训练、微调与数据面试题图文讲义2576 字

Accelerate分布式训练面试题

·全库 141 / 611

《Accelerate分布式训练面试题》共 11 页、0.3 万字,通篇围绕 GPU、CUDA、Attention 展开,归在「训练、微调与数据」这一层。

覆盖GPUCUDAAttention

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(1 节)
  1. 设置随机数种子,保证实验可重现

原 PDF 已逐页还原成图,共 11 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01一、为什么需要 accelerate…
  2. 02$ pip install acce…
  3. 03#需要重新初始化引擎 model_e…
011 / 3
第 1 页
第 1 页

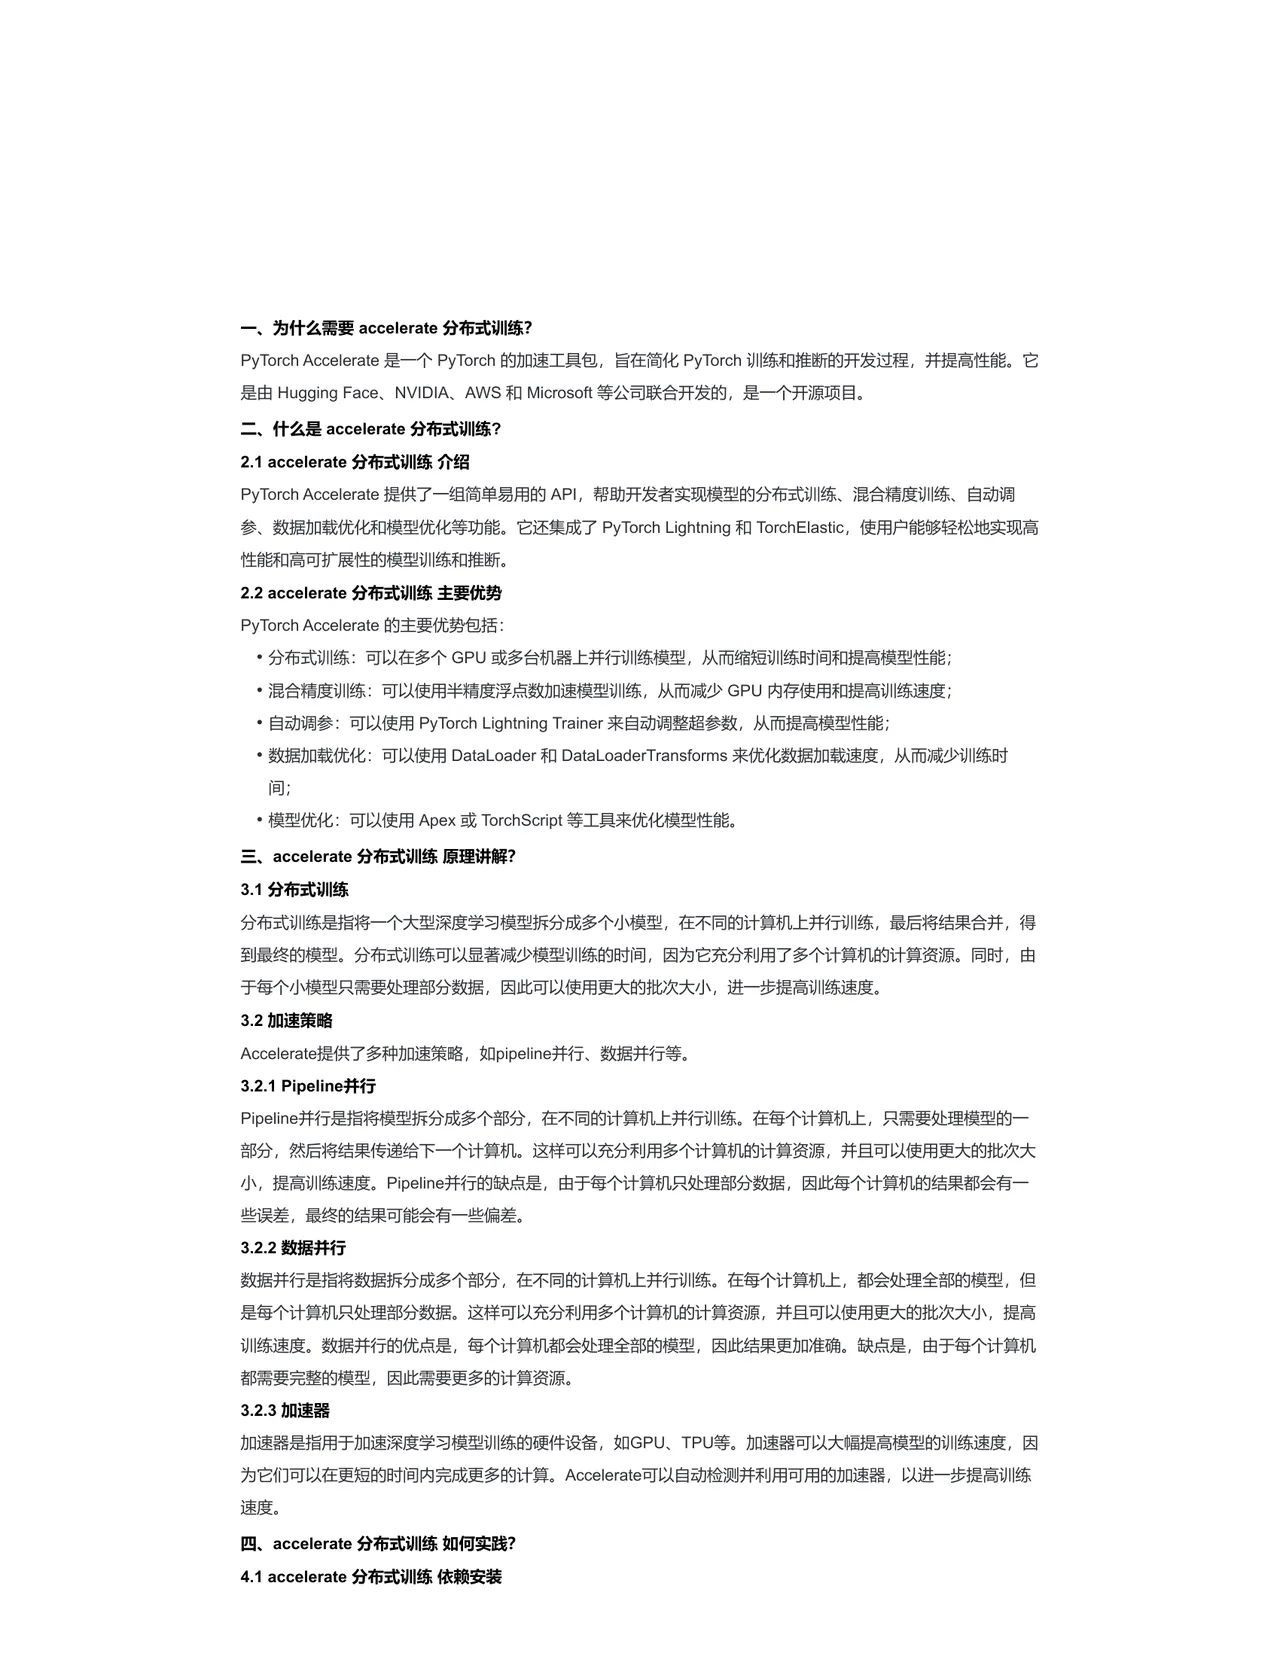
一、为什么需要 accelerate…

  • 一、为什么需要 accelerate 分布式训练? PyTorch Accelerate 是一个 PyTorch 的加速工具包,旨在简化 PyTorch 训练和推断的开发过程,并提高性能。它 是由 Hugging Face、NVIDIA、AWS 和 Microsoft 等公司联合开发的,是一个开源项目。 二,什么是 accelerate 分布式训练? 2.1 accelerate 分布式训练介绍 PyTorch Accelerate 提供了一组简单易用的 API,帮助开发者实现模型的分布式训练、混合精度训练、自动调 参、数据加载优化和模型优化等功能。它还集成了 PyTorch Lightning 和 TorchElastic,使用户能够轻松地实现高 性能和高可扩展性的模型训练和推断。 2.2 accelerate 分布式训练主要优势 PyTorch Accelerate 的主要优势包括:
  • 分布式训练:可以在多个 GPU 或多台机器上并行训练模型,从而缩短训练时间和提高模型性能;
  • 混合精度训练:可以使用半精度浮点数加速模型训练,从而减少 GPU 内存使用和提高训练速度;
  • 自动调参:可以使用 PyTorch Lightning Trainer 来自动调整超参数,从而提高模型性能;
  • 数据加载优化:可以使用 DataLoader 和 DataLoaderTransforms 来优化数据加载速度,从而减少训练时 间;
  • 模型优化:可以使用 Apex 或 TorchScript 等工具来优化模型性能。 三,accelerate 分布式训练原理讲解? 3.1 分布式训练 分布式训练是指将一个大型深度学习模型拆分成多个小模型,在不同的计算机上并行训练,最后将结果合并,得 到最终的模型。分布式训练可以显著减少模型训练的时间,因为它充分利用了多个计算机的计算资源。同时,由 于每个小模型只需要处理部分数据,因此可以使用更大的批次大小,进一步提高训练速度。 3.2 加速策略 Accelerate 提供了多种加速策略,如 pipeline 并行、数据并行等。 3.2.1 Pipeline 并行 Pipeline 并行是指将模型拆分成多个部分,在不同的计算机上并行训练。在每个计算机上,只需要处理模型的一 部分,然后将结果传递给下一个计算机。这样可以充分利用多个计算机的计算资源,并且可以使用更大的批次大 小,提高训练速度。Pipeline 并行的缺点是,由于每个计算机只处理部分数据,因此每个计算机的结果都会有一 些误差,最终的结果可能会有一些偏差。 3.2.2 数据并行 数据并行是指将数据拆分成多个部分,在不同的计算机上并行训练。在每个计算机上,都会处理全部的模型,但 是每个计算机只处理部分数据。这样可以充分利用多个计算机的计算资源,并且可以使用更大的批次大小,提高 训练速度。数据并行的优点是,每个计算机都会处理全部的模型,因此结果更加准确。缺点是,由于每个计算机 都需要完整的模型,因此需要更多的计算资源。 3.2.3 加速器 加速器是指用于加速深度学习模型训练的硬件设备,如 GPU、TPU 等。加速器可以大幅提高模型的训练速度,因 为它们可以在更短的时间内完成更多的计算。Accelerate 可以自动检测并利用可用的加速器,以进一步提高训练 速度。 四、accelerate 分布式训练如何实践? 4.1 accelerate 分布式训练依赖安装
022 / 3
第 2 页
第 2 页

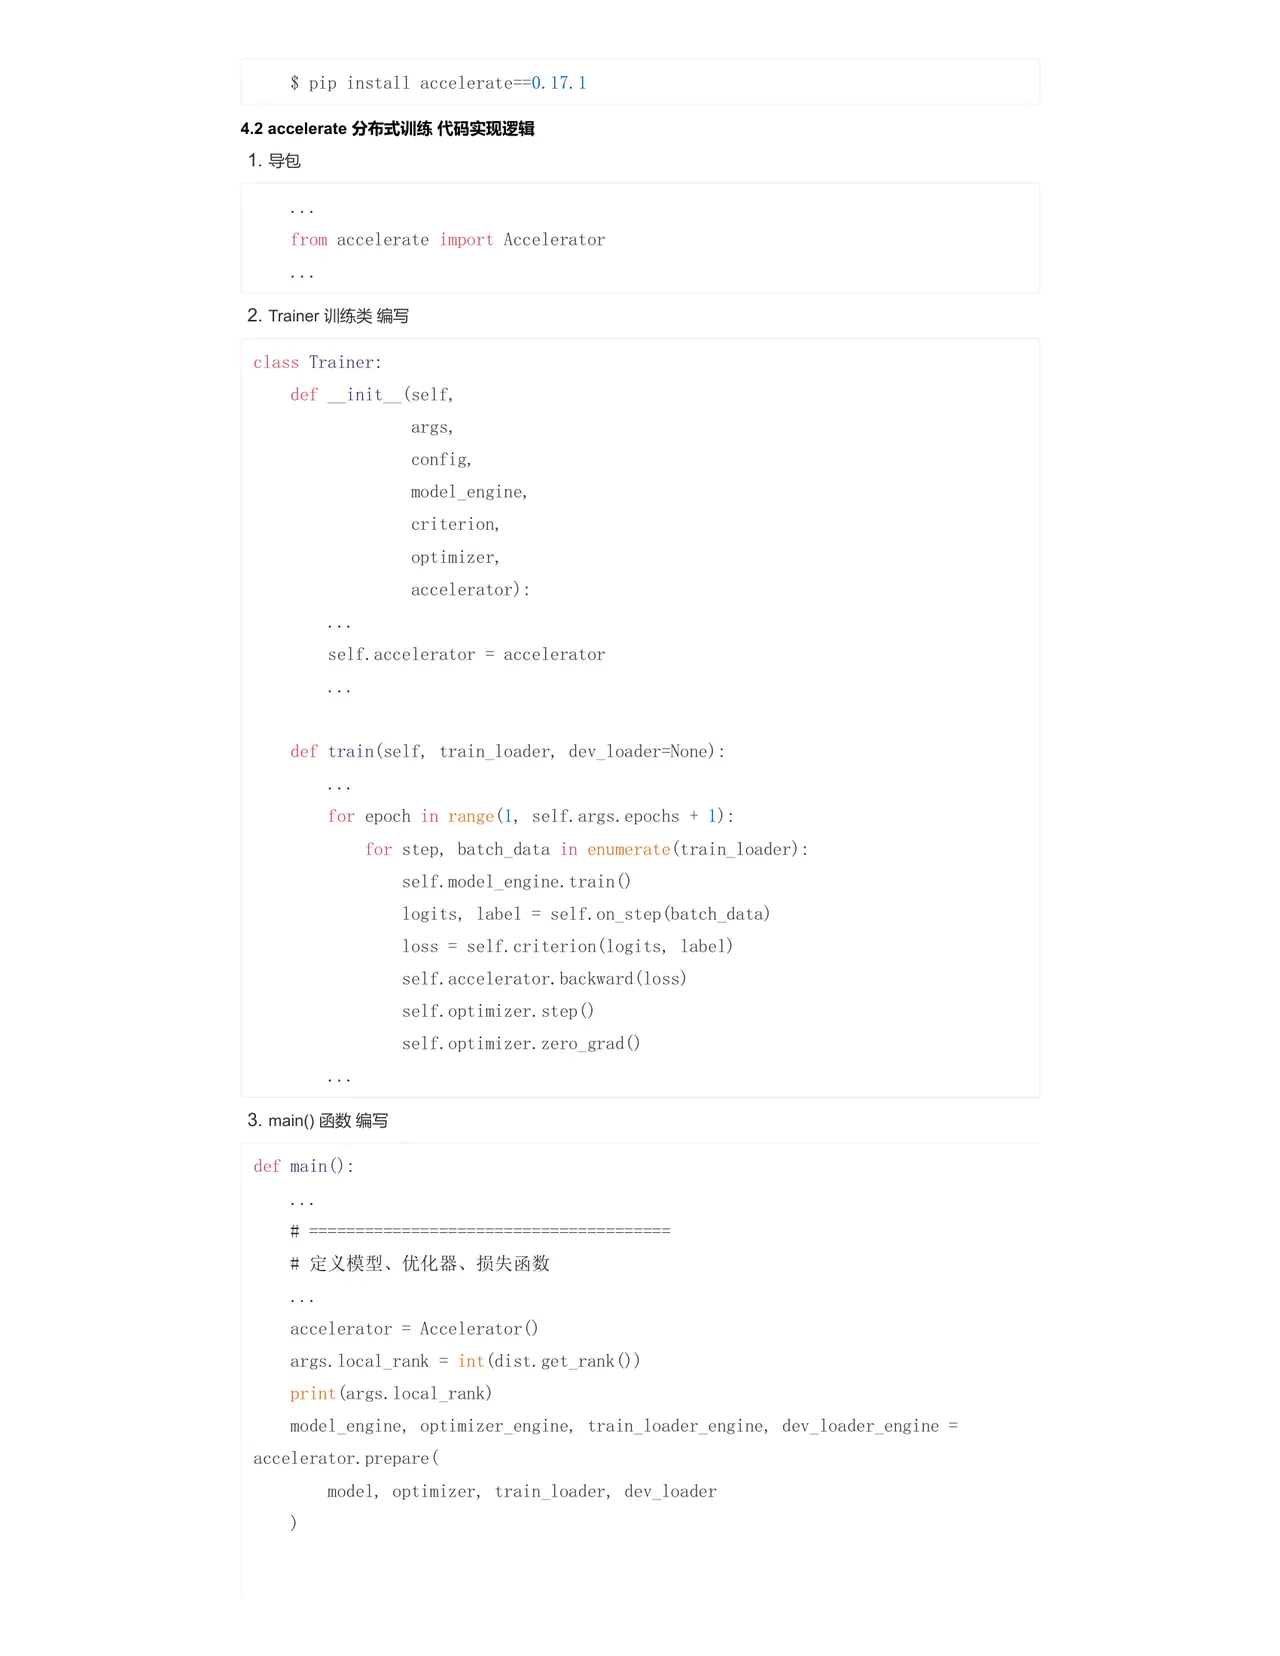
$ pip install acce…

$ pip install accelerate==0.17.1 4.2 accelerate 分布式训练代码实现逻辑

from accelerate import Accelerator

  1. Trainer 训练类编写 class Trainer:

argS, config, model_engine, criterion, optimizer, accelerator):

self.accelerator = accelerator

def train (self, train_loader, dev_loader=None):

for step, batch_data in enumerate (train_loader): self.model_engine.train ( logits, label = self.on_step (batch_data) loss = self.criterion (logits, label)

self.accelerator. backward (loss) self.optimizer.step ( self.optimizer.zero_ gradO

  1. main ()函数编写

# 定义模型、优化器、损失函数

accelerator = Accelerator () args.local_rank = int (dist.get_rank ()) print (args. local_rank) model_engine, optimizer_engine, accelerator.prepare ( model, optimizer, train_loader, dev_loader

train_loader_engine,

dev_loader_engine =

033 / 3
第 3 页
第 3 页

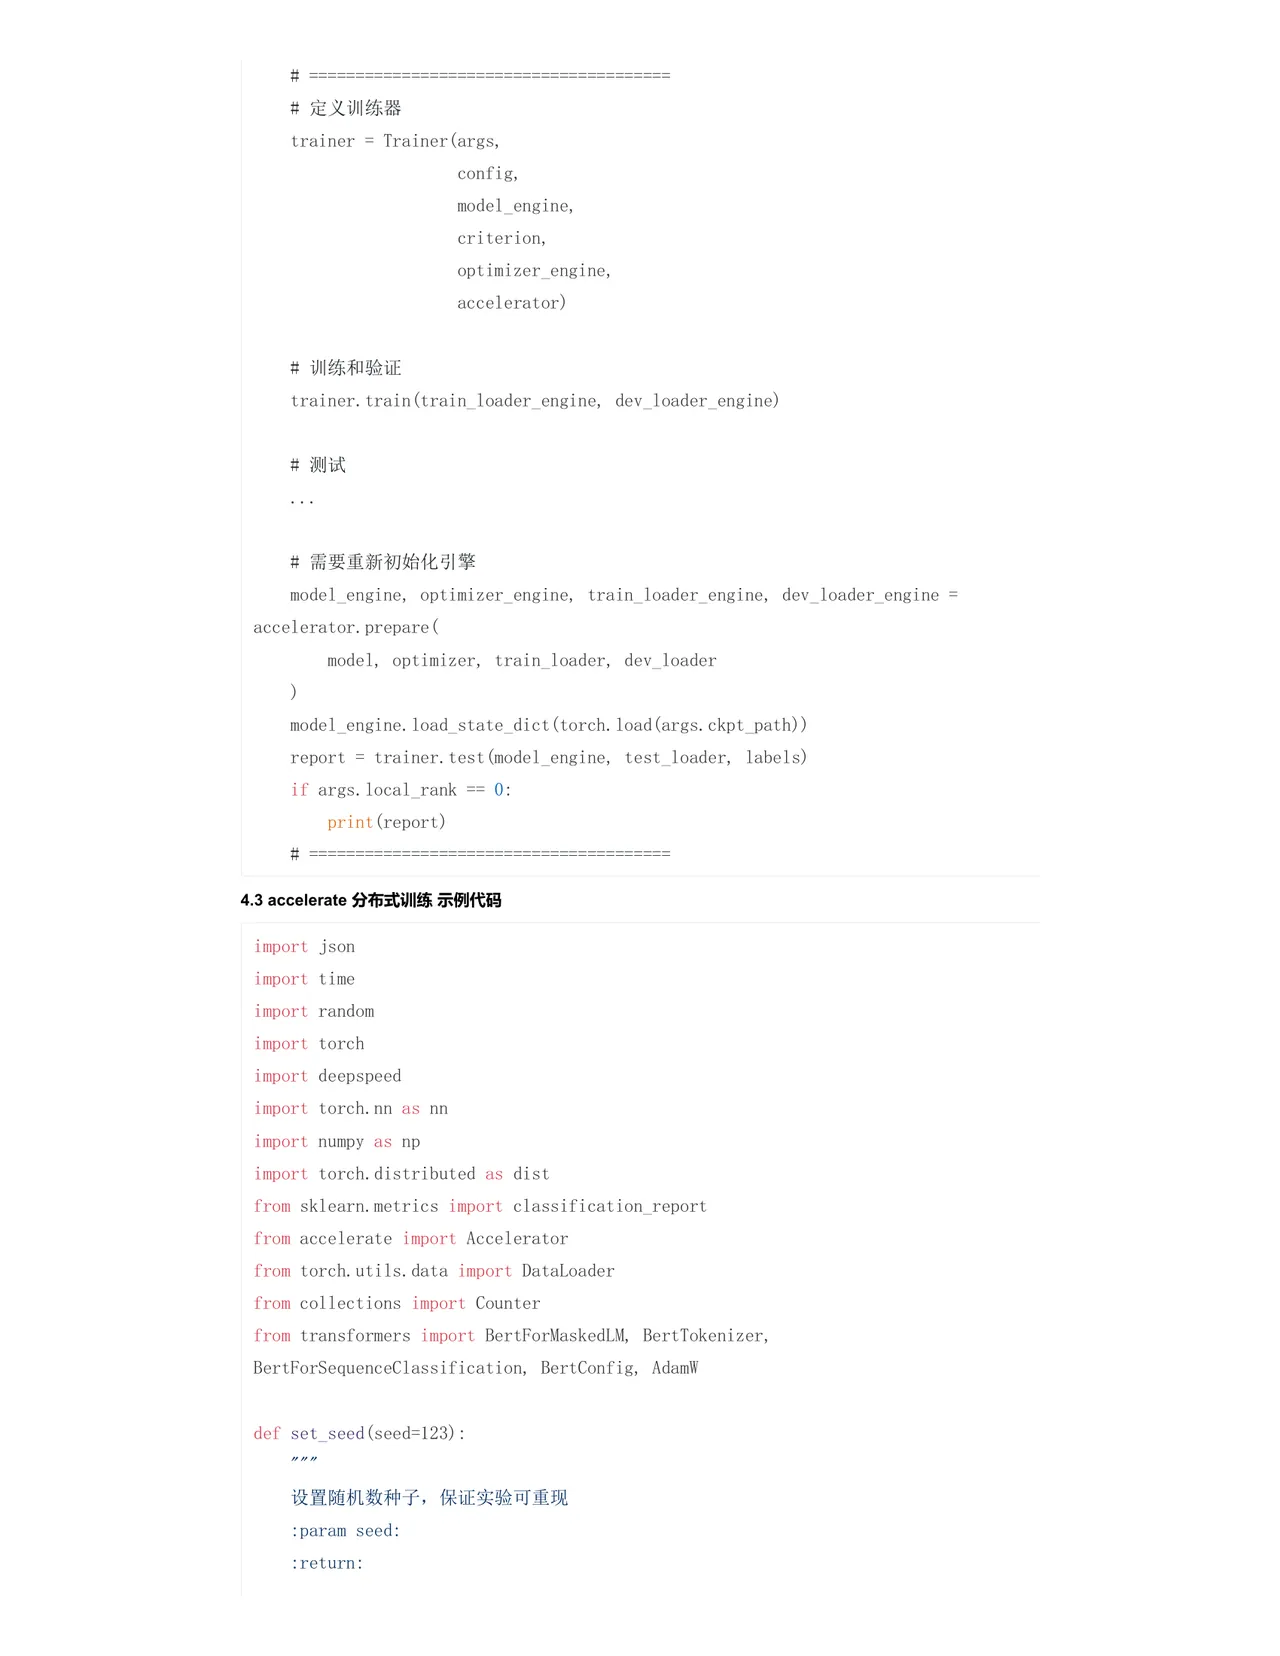
#需要重新初始化引擎 model_e…

trainer = Trainer (args,

trainer.train (train_loader_engine,

#测试

#需要重新初始化引擎 model_engine, optimizer_engine, train_loader_engine, accelerator. prepare ( model, optimizer, train_loader,

model_engine.load_state dict (torch. load (args.ckpt._path)) report = trainer.test (model_engine, test_loader, labels)

print (report)

4.3 accelerate 分布式训练示例代码 import json import time import random import torch import deepspeed import torch.nn as nn import numpy as np import torch.distributed from sklearn.metrics import classification_report from accelerate import Accelerator from torch. utils.data import Dataloader from collections import Counter from transformers import BertForMaskedLM, BertForSequenceClassification, BertConfig,

def set_seed (seed=123):

设置随机数种子,保证实验可重现

:param seed: :return:

config, model_engine,

optimizer_engine,

accelerator)

as dist

dev_loader_engine)

dev loader

Bertlokenizer, AdamW

dev_loader_engine =

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求