
Prompting学习微调面试题
《Prompting学习微调面试题》共 5 页、0.3 万字,通篇围绕 prompt、微调、预训练、成本 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(5 节)
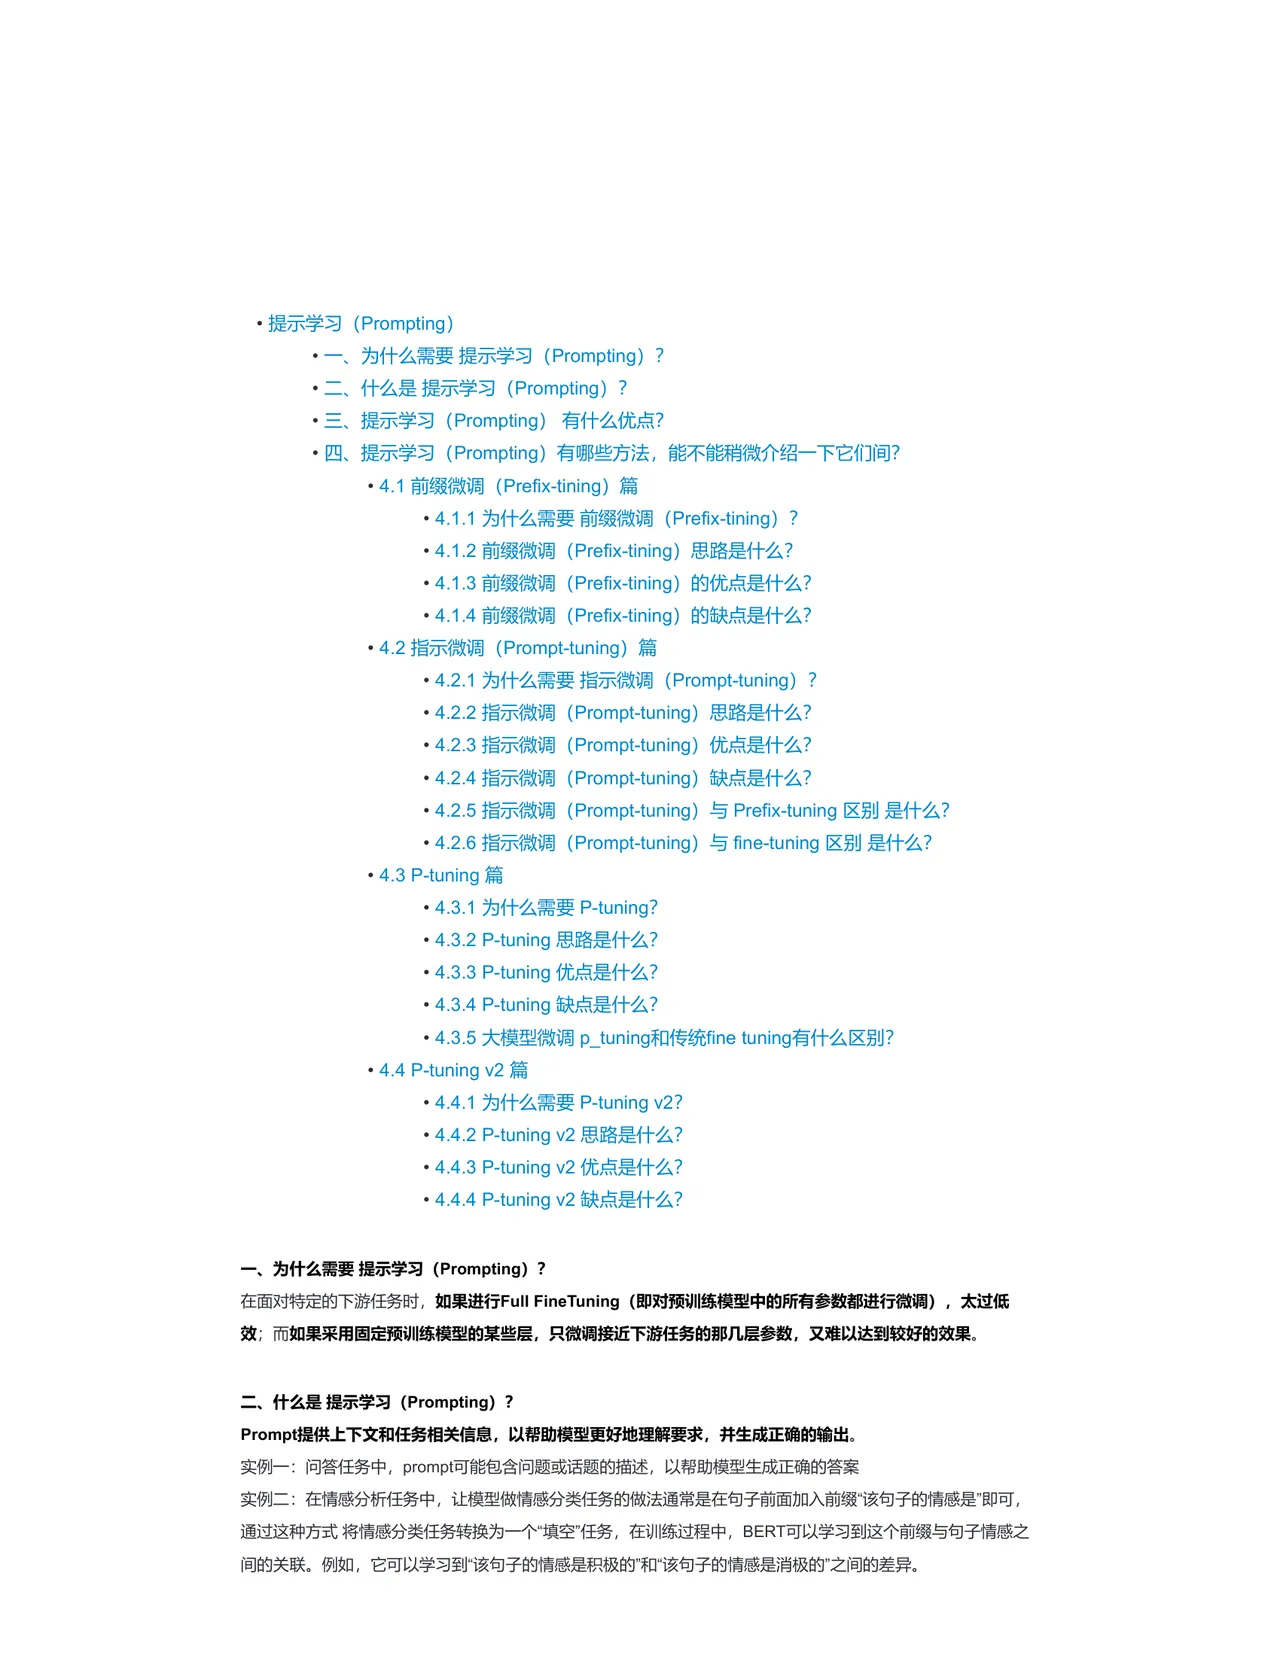
- 提示学习(Prompting)
- 4.1 前缀微调(Prefix-tining)篇
- 4.2 指示微调(Prompt-tuning)篇
- 考虑所有类型的语言模型
- prompt 的味道
原 PDF 已逐页还原成图,共 5 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。
提示学习(Prompting)
- 提示学习(Prompting)
- 一、为什么需要提示学习(Prompting)?
- 二、什么是提示学习(Prompting)?
- 三、提示学习(Prompting)有什么优点?
- 四、提示学习(Prompting)有哪些方法,能不能稍微介绍一下它们间?
- 4.1 前缀微调(Prefix-tining)篇
- 4.1.1 为什么需要前缀微调(Prefix-tining)?
- 4.1.2 前缀微调(Prefix-tining)思路是什么?
- 4.1.3 前缀微调(Prefix-tining)的优点是什么?
- 4.1.4 前缀微调(Prefix-tining)的缺点是什么?
- 4.2 指示微调(Prompt-tuning)篇
- 4.2.1 为什么需要指示微调(Prompt-tuning)?
- 4.2.2 指示微调(Prompt-tuning)思路是什么?
- 4.2.3 指示微调(Prompt-tuning)优点是什么?
- 4.2.4 指示微调(Prompt-tuning)缺点是什么?
- 4.2.5 指示微调(Prompt-tuning)与 Prefix-tuning 区别是什么?
- 4.2.6 指示微调(Prompt-tuning)与 fine-tuning 区别是什么?
- 4.3.1 为什么需要 P-tuning?
- 4.3.2 P-tuning 思路是什么?
- 4.3.3 P-tuning 优点是什么?
- 4.3.4 P-tuning 缺点是什么?
- 4.3.5 大模型微调 p_tuning 和传统 fine tuning 有什么区别?
- 4.4.1 为什么需要 P-tuning v2?
- 4.4.2 P-tuning v2 思路是什么?
- 4.4.3 P-tuning v2 优点是什么?
- 4.4.4 P-tuning v2 缺点是什么?
一、为什么需要提示学习(Prompting)? 在面对特定的下游任务时,如果进行 Full FineTuning (即对预训练模型中的所有参数都进行微调),太过低 效;而如果采用固定预训练模型的某些层,只微调接近下游任务的那几层参数,又难以达到较好的效果。
二、什么是提示学习(Prompting)? Prompt 提供上下文和任务相关信息,以帮助模型更好地理解要求,并生成正确的输出。 实例一:问答任务中,prompt 可能包含问题或话题的描述,以帮助模型生成正确的答案 实例二:在情感分析任务中,让模型做情感分类任务的做法通常是在句子前面加入前缀该句子的情感是”即可, 通过这种方式将情感分类任务转换为一个“填空”任务,在训练过程中,BERT 可以学习到这个前缀与句子情感之 间的关联。例如,它可以学习到“该句子的情感是积极的”和”该句子的情感是消极的”之间的差异。
三,提示学习(Prompting)有…
三,提示学习(Prompting)有什么优点? 提示学习(Prompting)旨在通过最小化微调参数的数量和计算复杂度,来提高预训练模型在新任务上的性能, 从而缓解大型预训练模型的训练成本。这样一来,即使计算资源受限,也可以利用预训练模型的知识来迅速适应 新任务,实现高效的迁移学习。
四.提示学习(Prompting)有哪些方法,能不能稍微介绍一下它们间?
4.1 前缀微调(Prefix-tining)篇
- 人工设计离散的 Prompts 缺点: a. Prompts 的变化对模型最终的性能特别敏感,加一个词、少一个词或者变动位置都会造成比较大的 变化 2. 自动化搜索离散的 Prompts 缺点: a. 成本也比较高 3. 离散化的 token 搜索出来的结果可能并不是最优的; 4.传统的微调范式利用预训练模型去对不同的下游任务进行微调,对每个任务都要保存一份微调后的模型权 重,一方面微调整个模型耗时长;另一方面也会占很多存储空间
- 4.1.2 前缀微调(Prefix-tining)思路是什么?
- step 1Prefix 构建。在输入 token 之前构造一段任务相关的 virtual tokens 作为 Prefix;
- step 2 训练时只更新 Prefix 部分的参数,而 Transformer 中的其他部分参数固定;
- step 3 在 Prefix 层前面加了 MLP 结构(相当于将 Prefix 分解为更小维度的 Input 与 MLP 的组合后输出的结果),训 练完成后,只保留 Prefx 的参数;(用于防止直接更新 Prefix 的参数导致训练不稳定的情况)
4.1.3 前缀微调(Prefix-tining)的优点是什么? 1. 前缀微调(Prefix-tining)vs 人工设计离散的 Prompts 无法更新参数:前缀微调(Prefix-tining)可以学习 的“隐式”的 Prompts; 2.基于前缀的架构可以在一个批次中处理来自多个用户/任务的样本,这是其他轻量级微调方法所不能做到的; 3. vs full fine-tuning: full fine-tuning 更新所有参数,Prefix Tuning 只更新 Prefix 部分的参数;
4.1.4 前缀微调(Prefix-tining)的缺点是什么? 1.占用序列长度。有一定的额外计算开销; 2. 在每层都加了 prompt 的参数,改动较大
4.2 指示微调(Prompt-tuning)篇 4.2.1 为什么需要指示微调(Prompt-tuning)? 1.模型全量微调对每个任务训练一个模型,开销和部署成本都比较高; 2. 离散的 prompts (指人工设 iprompts 提示语加入到模型)方法,成本比较高,并且效果不太好; 3. 前缀微调(Prefix-tining)占用序列长度。有一定的额外计算开销; 4. 前缀微调(Prefix-tining)在每层都加了 prompt 的参数,改动较大
4.2.2 指示微调(Prompt-tuning)思路是什么? 1.将 prompt 扩展到连续空间,仅在输入层添加 prompt 连续向量,通过反向传播更新参数来学习 prompts,而 不是人工设 iprompts; 2.冻结模型原始权重,只训练 prompts 参数,训练完成后,只用同一个模型可以做多任务推理; 3. 使用 LSTM 建模 prompt 向量间关联性
4.2.3 指示微调(Prompt-…
4.2.3 指示微调(Prompt-tuning)优点是什么? 1.只在输入层加入 prompt tokens,并且不需要加入 MLP 进行调整来解决难训练的问题; 2. 随着预训练模型参数量的增加,Prompt Tuning 的方法会逼近全参数微调的结果; 3. 提出了 prompt ensembling:在一个批次(Batch)里同时训练同一个任务的不同 prompt (即采用多种不同方 式询问同一个问题),这样相当于训练了不同模型,比模型集成的成本小多了;
4.2.4 指示微调(Prompt-tuning)缺点是什么? 1.训练难度加大。不太好训练,省了显存,但不一定省时间。具体来讲,大部分 prompt 现在只是 parameter efficient 并没有达到想要的 training efficient。也就是说只是省了空间(显存),但不一定能加快训练,训练时间 有可能更长 2. 多个 prompt token 之间相互独立,可能会影响效果 3. 在 NLU 上,prompt tuning 对于正常大小的预训练模型表现不佳; 4. 现有的 prompt tuning 方法不能处理困难的序列标注任务
4.2.5 指示微调(Prompt-tuning)与 Prefix-tuning 区别是什么? 可以看作是 Prefix Tuning 的简化版本 1. 适用任务不同 a. Prefix-tuning 仅针对 NLG 任务有效,服务于 GPT 架构; b. 2.指示微调(Prompt-tuning) 2. 添加方式不同 a. Prefix-tuning 限定在输入前面添加 b. 指示微(Prompt-tuning)可以在任意位置添加
- promp 连续向量添加方式不同 a. Prefix-tuning 每一层都添加,保证效果 b. 指示微调(Prompt-tuning)可以只在输入层添加
4.2.6 指示微调(Prompt-tuning)与 fine-tuning 区别是什么? 1. Fine-tuning 需要改变预训练阶段模型参数,可能带量灾难性遗忘问题 2. 指示微调(Prompt-tuning)不改变预训练阶段模型参数,而是通过微调寻找更好的连续 prompt,来引导已 学习到的知识使用
4.3 P-tuning 篇 4.3.1 为什么需要 P-tuning? 1.大模型的 Prompt 构造方式严重影响下游任务的效果。 eg:GPT 系列 AR 建模在自然语言理解 NLU 任务上效果不好,与 BERT 双向语言模型相比有明显差距; 注:GPT-3 采用人工构造的模版来做上下文学习(in context learning),但人工设计的模版的变化特别敏感,加 一个词或者少一个词,或者变动位置都会造成比较大的变化 1.之前的研究表明 GPT3 使用 prompt 训练方式可以显著提升 few-shot 和 zero-shot 的效果; 2. 自动化搜索模版工作成本也比较高,以前这种离散化的 token 的搜索出来的结果可能并不是最优的,导致性能
4.3.2 P-tuning 思路是什么? 1.可学习的 Embedding 层设计。将 Prompt 转换为可学习 Embedding 层; 2. prompt encoder 设计。用 prompt encoder (由一个双向的 LSTM+两层 MLP 组成)的方式来对 Prompt Embedding 进行一层处理,建模伪 token 的相互依赖,并且可以提供一个更好的初始化。
4.3.3 P-tuning 优点是什么?
考虑所有类型的语言模型