训练、微调与数据面试题图文讲义8410 字

分布式训练DeepSpeed面试题

·全库 148 / 611

《分布式训练DeepSpeed面试题》共 30 页、0.8 万字,通篇围绕 GPU、CUDA、显存、Attention 展开,归在「训练、微调与数据」这一层。

覆盖GPUCUDA显存Attention吞吐需求

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(8 节)
  1. 一、为什么需要 Deepspeed?
  2. 二、DeepSpeed 基本概念介绍一下?
  3. 三、DeepSpeed 通信策略介绍一下?
  4. 五、DeepSpeed 全部代码
  5. 六、优化器和调度器
  6. 填坑笔记
  7. 7.如何估算需要的显存?
  8. 七、训练精度

原 PDF 已逐页还原成图,共 30 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01图解分布式训练(六)——Pytorc…
  2. 02一、为什么需要 Deepspeed?
  3. 03二、DeepSpeed 基本概念介绍一下?
011 / 3
第 1 页
第 1 页

图解分布式训练(六)——Pytorc…

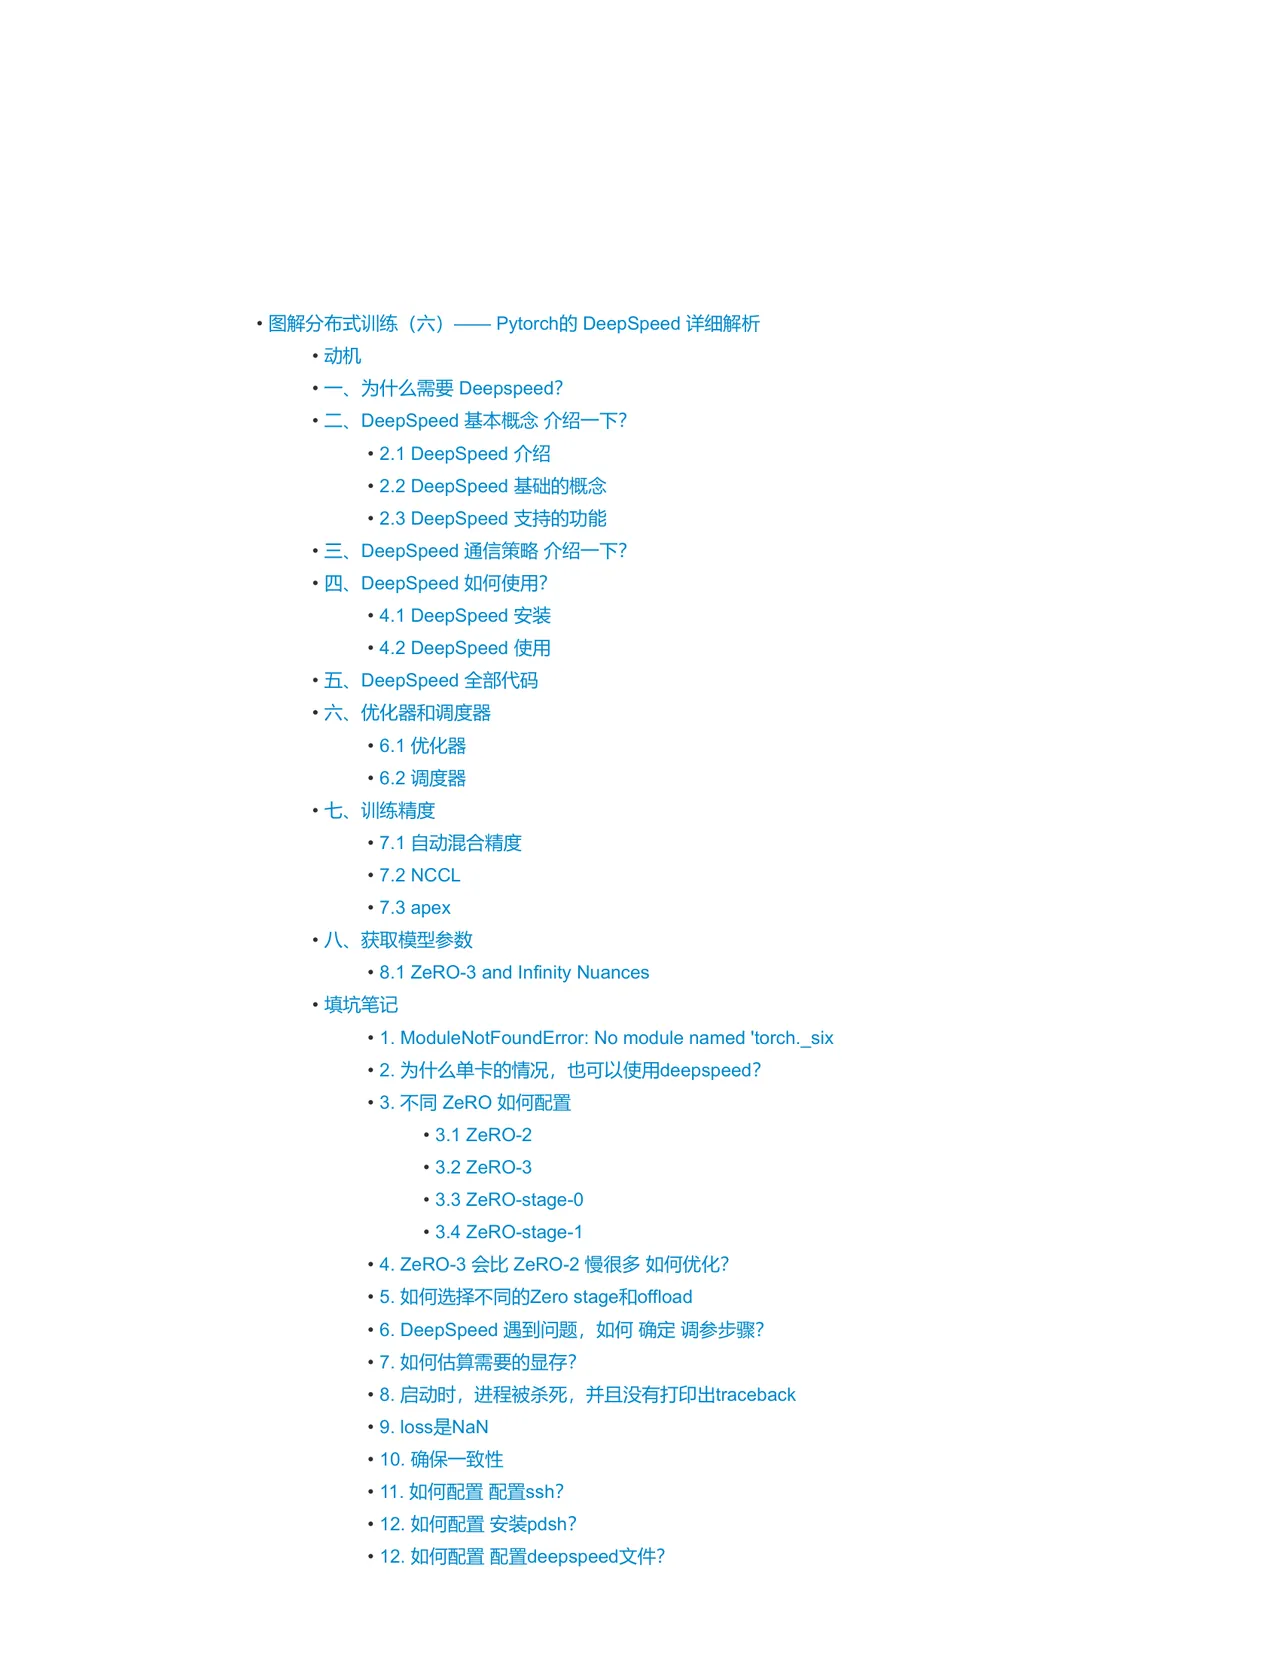
•图解分布式训练(六)——Pytorch 的 DeepSpeed 详细解析

  • 一、为什么需要 Deepspeed?
  • 二、DeepSpeed 基本概念介绍一下?
  • 2.1 DeepSpeed 介绍
  • 2.2 DeepSpeed 基础的概念
  • 2.3 DeepSpeed 支持的功能
  • 三、DeepSpeed 通信策略介绍一下?
  • 四、DeepSpeed 如何使用?
  • 4.1 DeepSpeed 安装
  • 4.2 DeepSpeed 使用
  • 五、DeepSpeed 全部代码
  • 六、优化器和调度器
  • 七、训练精度
  • 7.1 自动混合精度

• 7.3 apex

•八、获取模型参数

  • 8.1 ZeRO-3 and Infinity Nuances
  • 填坑笔记
  • 1. ModuleNotFoundError: No module named "torch._six
  • 2. 为什么单卡的情况,也可以使用 deepspeed?
  • 3. 不同 ZeRO 如何配置
  • 3.1 ZeRO-2
  • 3.2 ZeRO-3
  • 3.3 ZeRO-stage-0
  • 3.4 ZeRO-stage-1
  • 4. ZeRO-3 会比 ZeRO-2 慢很多如何优化?
  • 5. 如何选择不同的 Zero stage 和 offload
  • 6.DeepSpeed 遇到问题,如何确定调参步骤?
  • 7.如何估算需要的显存?
  • 8.启动时,进程被杀死,并且没有打印出 traceback
  • 10. 确保一致性
  • 11. 如何配置配置 ssh?
  • 12. 如何配置安装 pdsh?
  • 12. 如何配置配置 deepspeed 文件?
022 / 3
第 2 页:一、为什么需要 Deepspeed?
第 2 页

一、为什么需要 Deepspeed?

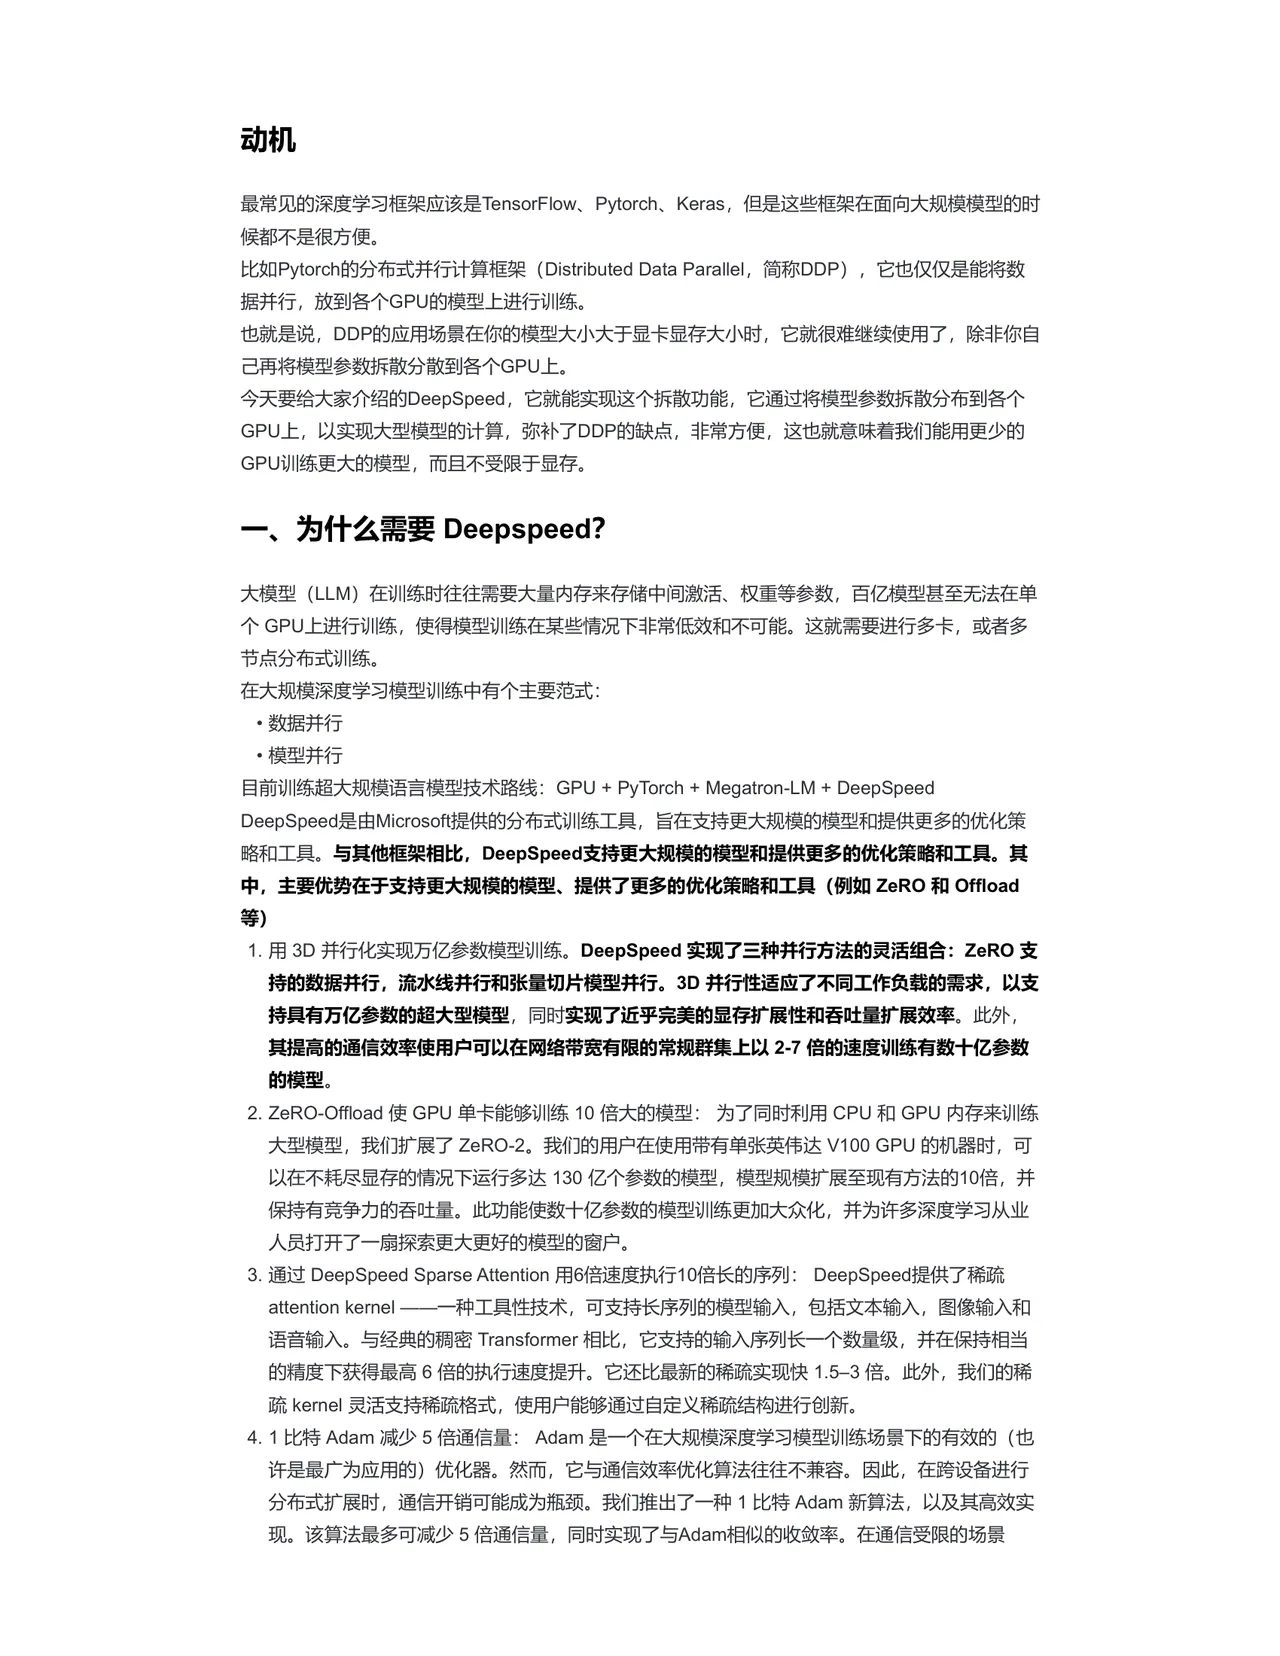
动机

最常见的深度学习框架应该是 TensorFlow、Pytorch、Keras,但是这些框架在面向大规模模型的时 候都不是很方便。 比如 Pytorch 的分布式并行计算框架(Distributed Data Parallel,简称 DDP),它也仅仅是能将数 据并行,放到各个 GPU 的模型上进行训练。 也就是说,DDP 的应用场景在你的模型大小大于显卡显存大小时,它就很难继续使用了,除非你自 己再将模型参数拆散分散到各个 GPU 上。 今天要给大家介绍的 DeepSpeed,它就能实现这个拆散功能,它通过将模型参数拆散分布到各个 GPU 上,以实现大型模型的计算,弥补了 DDP 的缺点,非常方便,这也就意味着我们能用更少的 GPU 训练更大的模型,而且不受限于显存。

  • 大模型(LLM)在训练时往往需要大量内存来存储中间激活、权重等参数,百亿模型甚至无法在单 个 GPU 上进行训练,使得模型训练在某些情况下非常低效和不可能。这就需要进行多卡,或者多 节点分布式训练。 在大规模深度学习模型训练中有个主要范式:
  • 数据并行
  • 模型并行 目前训练超大规模语言模型技术路线:GPU + PyTorch + Megatron-LM + DeepSpeed DeepSpeed 是由 Microsoft 提供的分布式训练工具,旨在支持更大规模的模型和提供更多的优化策 略和工具。与其他框架相比,DeepSpeed 支持更大规模的模型和提供更多的优化策略和工具。其 中,主要优势在于支持更大规模的模型、提供了更多的优化策略和工具(例如 ZeRO 和 Offload 1.用 3D 并行化实现万亿参数模型训练。DeepSpeed 实现了三种并行方法的灵活组合:ZeRO 支 持的数据井行,流水线井行和张量切片模型井行。3D 并行性适应了不同工作负载的需求,以支 持具有万亿参数的超大型模型,同时实现了近乎完美的显存扩展性和吞吐量扩展效率。此外, 其提高的通信效率使用户可以在网络带竞有限的常规群集上以 2-7 倍的速度训练有数十亿参数 的模型。 2.ZeRO-Offload 使 GPU 单卡能够训练 10 倍大的模型:为了同时利用 CPU 和 GPU 内存来训练 大型模型,我们扩展了 ZeRO-2。我们的用户在使用带有单张英伟达 V100 GPU 的机器时,可 以在不耗尽显存的情况下运行多达 130 亿个参数的模型,模型规模扩展至现有方法的 10 倍,并 保持有竞争力的吞吐量。此功能使数十亿参数的模型训练更加大众化,并为许多深度学习从业 人员打开了一扇探索更大更好的模型的窗户。 3. 通过 DeepSpeed Sparse Attention 用 6 倍速度执行 10 倍长的序列:DeepSpeed 提供了稀疏 attention kerel———种工具性技术,可支持长序列的模型输入,包括文本输入,图像输入和 语音输入。与经典的稠密 Transformer 相比,它支持的输入序列长一个数量级,并在保持相当 的精度下获得最高 6 倍的执行速度提升。它还比最新的稀疏实现快 1.5-3 倍。此外,我们的稀 疏 kernel 灵活支持稀疏格式,使用户能够通过自定义稀疏结构进行创新。 4.1 比特 Adam 减少 5 倍通信量:Adam 是一个在大规模深度学习模型训练场景下的有效的(也 许是最广为应用的)优化器。然而,它与通信效率优化算法往往不兼容。因此,在跨设备进行 分布式扩展时,通信开销可能成为瓶颈。我们推出了一种 1 比特 Adam 新算法,以及其高效实 现。该算法最多可减少 5 倍通信量,同时实现了与 Adam 相似的收敛率。在通信受限的场景

033 / 3
第 3 页:二、DeepSpeed 基本概念介绍一下?
第 3 页

二、DeepSpeed 基本概念介绍一下?

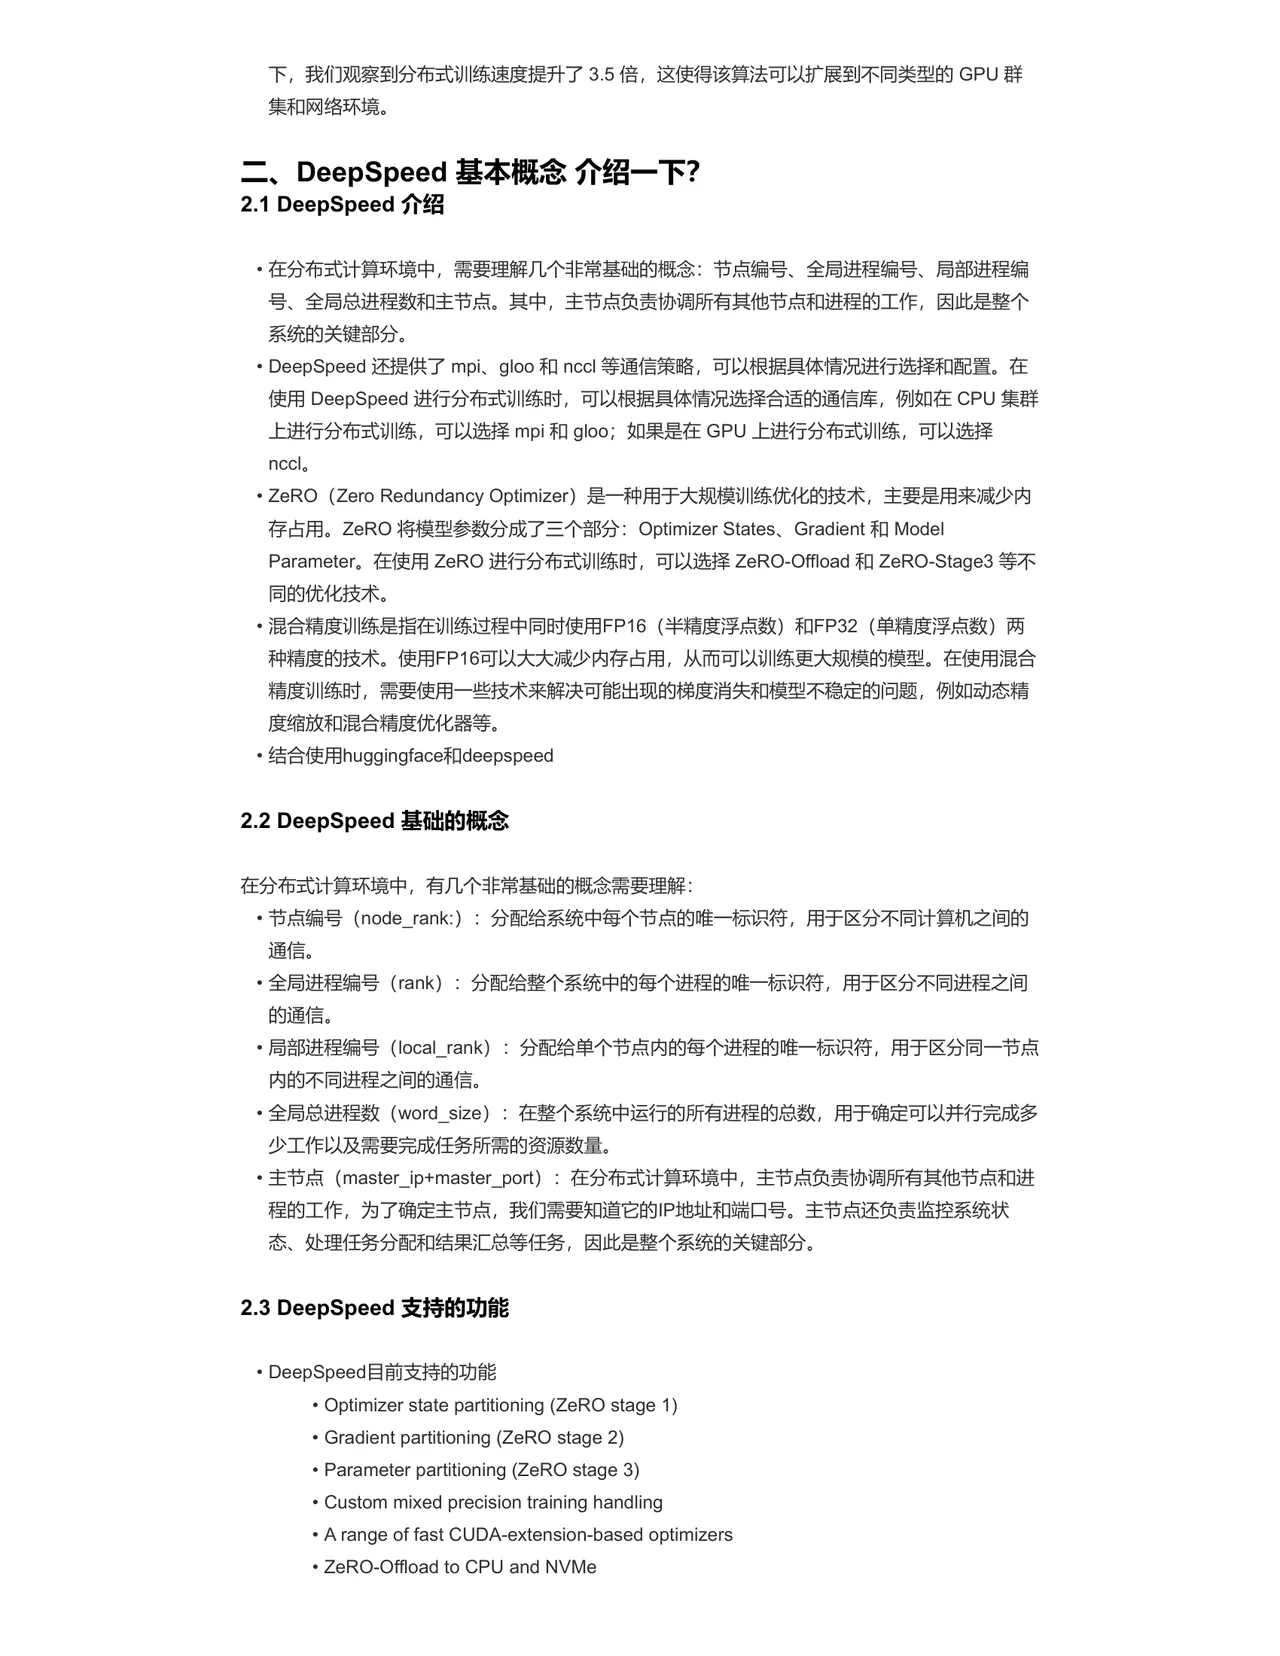
下,我们观察到分布式训练速度提升了 3.5 倍,这使得该算法可以扩展到不同类型的 GPU 群 集和网络环境。

2.1 DeepSpeed 介绍

  • 在分布式计算环境中,需要理解几个非常基础的概念:节点编号、全局进程编号、局部进程编 号、全局总进程数和主节点。其中,主节点负责协调所有其他节点和进程的工作,因此是整个 系统的关键部分。
  • DeepSpeed 还提供了 mpi、gloo 和 nccl 等通信策略,可以根据具体情况进行选择和配置。在 使用 DeepSpeed 进行分布式训练时,可以根据具体情况选择合适的通信库,例如在 CPU 集群 上进行分布式训练,可以选择 mpi 和 gloo;如果是在 GPU 上进行分布式训练,可以选择
  • ZeRO (Zero Redundancy Optimizer)是一种用于大规模训练优化的技术,主要是用来减少内 存占用。ZeRO 将模型参数分成了三个部分:Optimizer States、Gradient 和 Model Parameter。在使用 ZeRO 进行分布式训练时,可以选择 ZeRO-Offload 和 ZeRO-Stage3 等不 同的优化技术。
  • 混合精度训练是指在训练过程中同时使用 FP16 (半精度浮点数)和 FP32 (单精度浮点数)两 种精度的技术。使用 FP16 可以大大減少内存占用,从而可以训练更大规模的模型。在使用混合 精度训练时,需要使用一些技术来解決可能出现的梯度消失和模型不稳定的问题,例如动态精 度缩放和混合精度优化器等。
  • 结合使用 huggingface 和 deepspeed

2.2 DeepSpeed 基础的概念

  • 在分布式计算环境中,有几个非常基础的概念需要理解:
  • 节点编号(node_rank:):分配给系统中每个节点的唯一标识符,用于区分不同计算机之间的 通信。
  • 全局进程编号(rank):分配给整个系统中的每个进程的唯一标识符,用于区分不同进程之间 的通信。
  • 局部进程编号(local_rank):分配给单个节点内的每个进程的唯一标识符,用于区分同一节点 内的不同进程之间的通信。
  • 全局总进程数(word_size):在整个系统中运行的所有进程的总数,用于确定可以并行完成多 少工作以及需要完成任务所需的资源数量。
  • 主节点(master_ip+master_port):在分布式计算环境中,主节点负责协调所有其他节点和进 程的工作,为了确定主节点,我们需要知道它的 IP 地址和端口号。主节点还负责监控系统状 态、处理任务分配和结果汇总等任务,因此是整个系统的关键部分。 2.3 DeepSpeed 支持的功能
  • DeepSpeed 目前支持的功能
  • Optimizer state partitioning (ZeRO stage 1)
  • Gradient partitioning (ZeRO stage 2)
  • Parameter partitioning (ZeRO stage 3)
  • Custom mixed precision training handling
  • A range of fast CUDA-extension-based optimizers
  • ZeRO-Offload to CPU and NVMe

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求