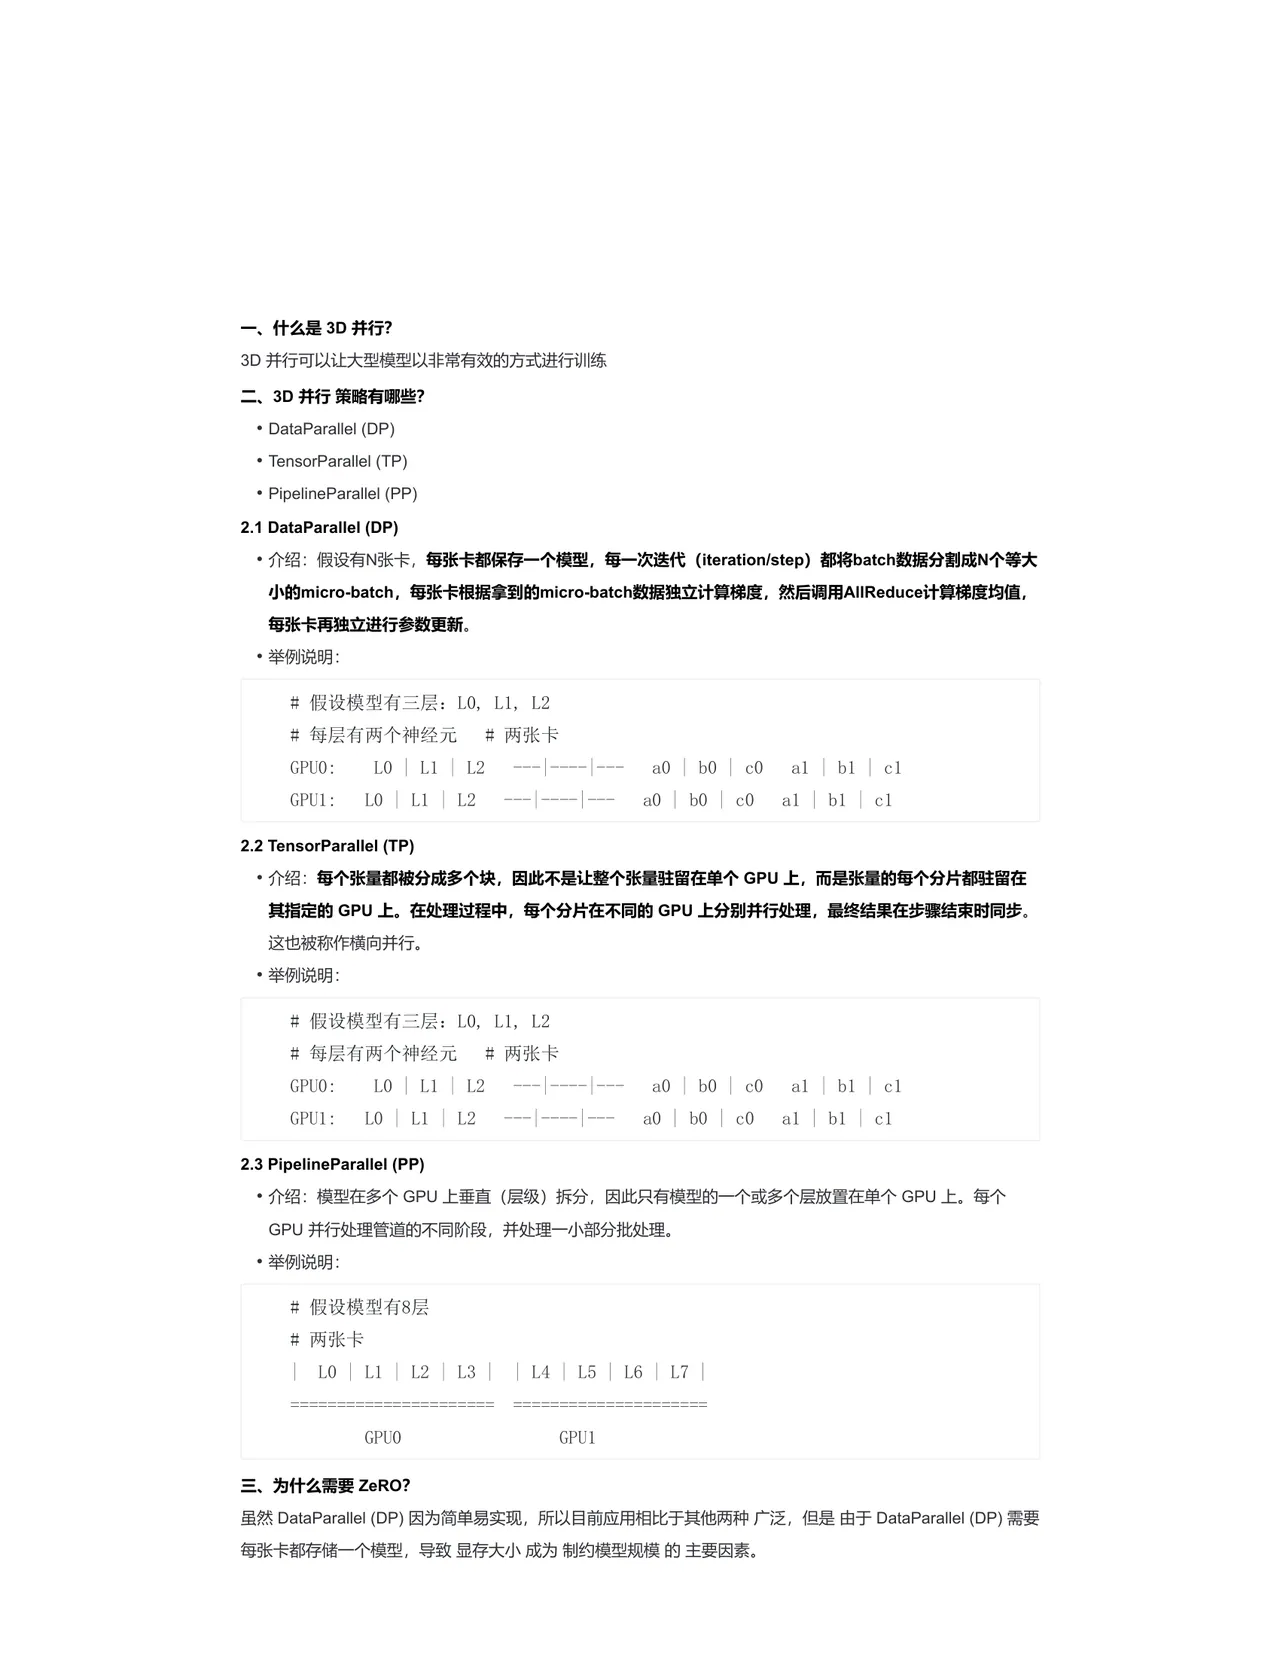
既然每张卡都存储一个模型会增加模型训练过程中的显存占用,那么是否可以让每行卡训练 1/N 的模型参 数,然后合并起来就是一个完整模型呢?这样,随着卡数的增加,每张卡用于模型训练的显存占用将减低,能 够训练的模型也就越大。 如今训练大模型离不开各种分布式并行策略,ZeRO 系列技术就是一种显存优化的数据并行方案,旨在训练超大 规模的语言模型。
- 四、ZeRO 的核心思想是什么? 去除数据并行中的冗余参数,使每张卡只存储一部分模型状态,从而減减少显存占用。 五、ZeRO 显存如何分配? ZeRO 将模型训练阶段中每张卡的显存内容分为两类:
- 模型状态:包括参数、梯度和优化器状态,其中优化器状态占比 75%。
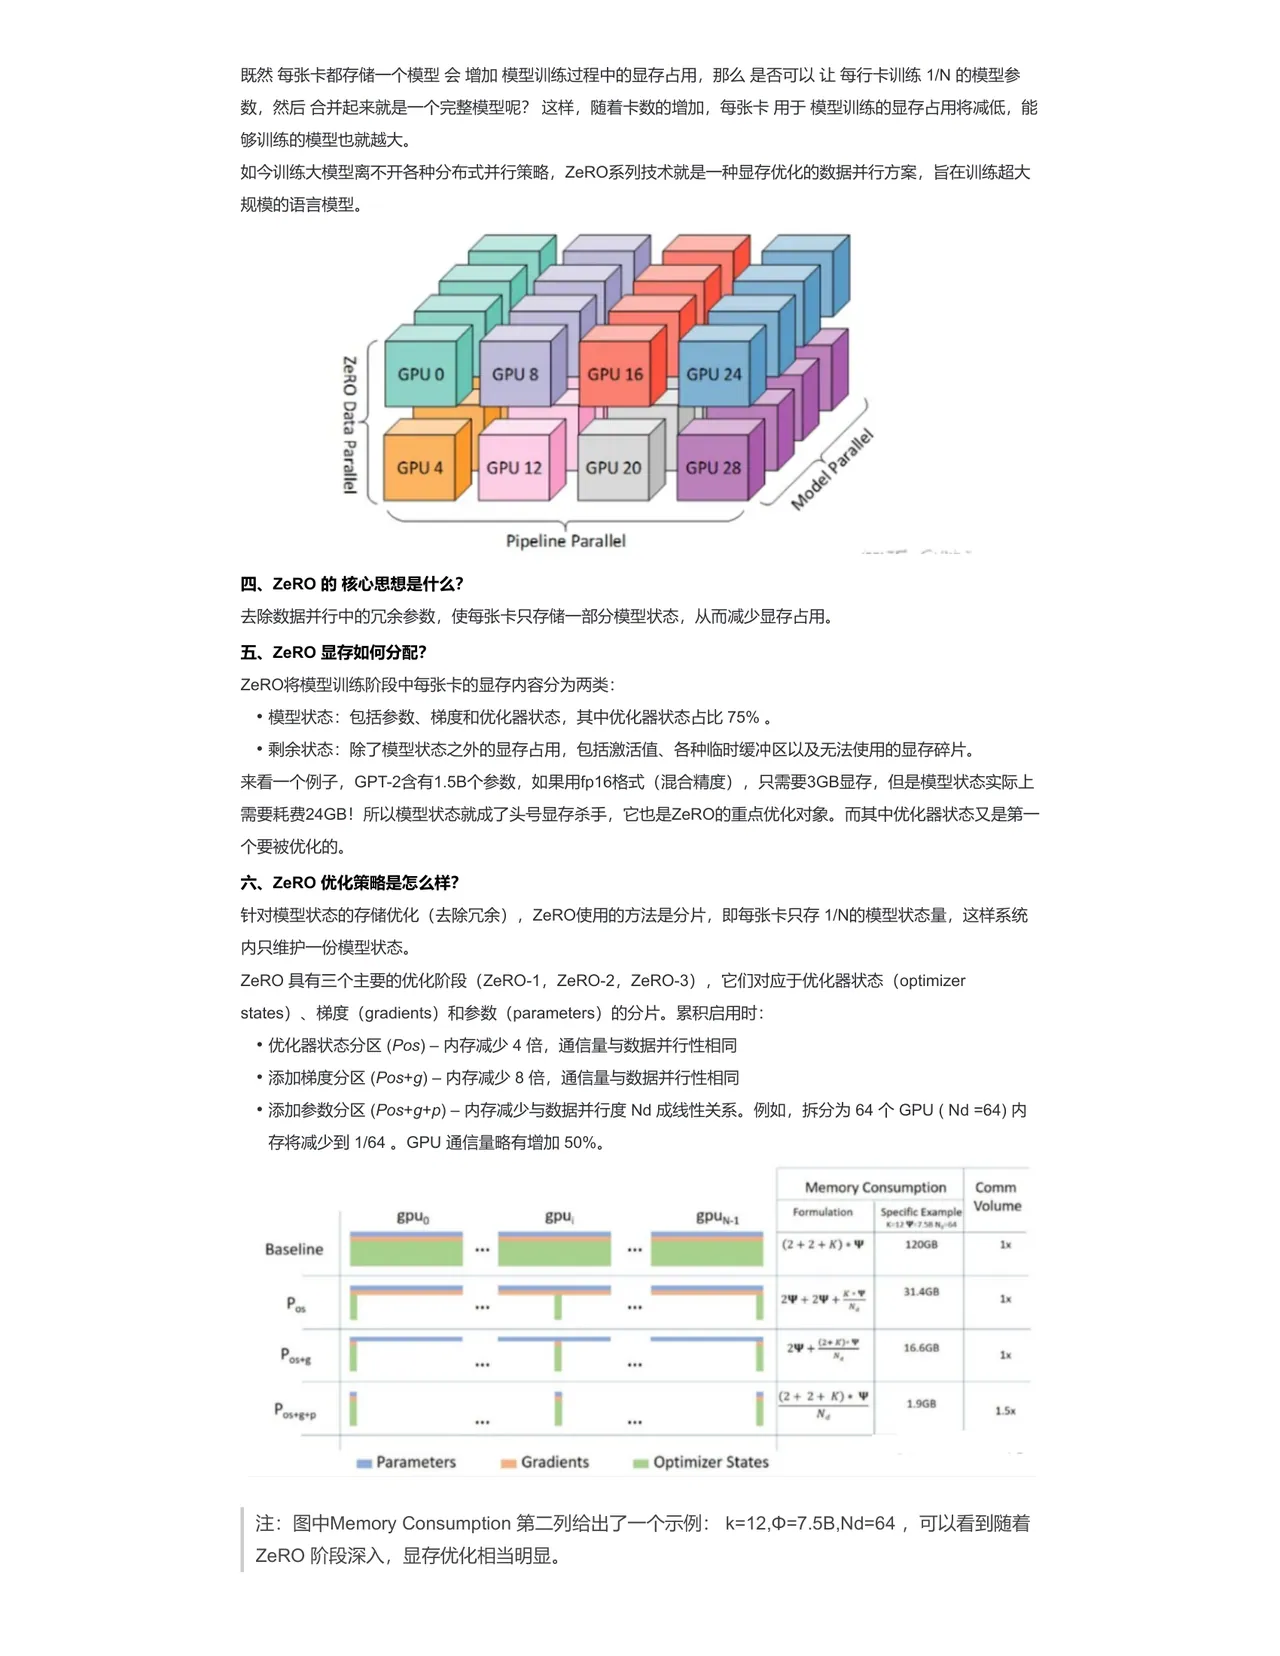
- 剩余状态:除了模型状态之外的显存占用,包括激活值、各种临时缓冲区以及无法使用的显存碎片。 来看一个例子,GPT-2 含有 1.5B 个参数,如果用 fp16 格式(混合精度),只需要 3GB 显存,但是模型状态实际上 需要耗费 24GB!所以模型状态就成了头号显存杀手,它也是 ZeRO 的重点优化对象。而其中优化器状态又是第一 个要被优化的。 六、.ZeRO 优化策略是怎么样? 针对模型状态的存储优化(去除冗余),ZeRO 使用的方法是分片,即每张卡只存 1/N 的模型状态量,这样系统 内只维护一份模型状态。 ZeRO 具有三个主要的优化阶段(ZeRO-1,ZeRO-2,ZeRO-3),它们对应于优化器状态(optimizer states)、梯度(gradients)和参数(parameters)的分片。累积启用时:
- 优化器状态分区(Pos)-内存减少 4 倍,通信量与数据并行性相同
- 添加梯度分区(Postg)内存減少 8 倍,通信量与数据并行性相同
- 添加参数分区(Postg+p)-内存减少与数据并行度 Nd 成线性关系。例如,拆分为 64 个 GPU (Nd =64)内 存将减少到 1/64。GPU 通信量略有增加 50%。
Baseline
注:图中 Memory Consumption 第二列给出了一个示例:k=12,中=7.5B,Nd=64,可以看到随着 ZeRO 阶段深入,显存优化相当明显。
GPU 24 GPU 16
GPU O
Model Parallel
GPU 20 GPU 12 GPU 28 GPU
Pipeline Parallel
Memory Consumption Volume
Formulation Specific Example 120GB 31.4G8
16.6G8
1.9G8
1.5x N. • Optimizer States Gradients