训练、微调与数据面试题图文讲义3180 字

大模型流水线并行训练面试题

·全库 151 / 611

《大模型流水线并行训练面试题》共 7 页、0.3 万字,通篇围绕 GPU、Transformer、语料 展开,归在「训练、微调与数据」这一层。

覆盖GPUTransformer语料

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(3 节)
  1. Z (算完即废)
  2. Z (保存)
  3. Pipeline-8

原 PDF 已逐页还原成图,共 7 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01为什么需要流水线并行(Pipelin…
  2. 02动机:当你有一个单卡装不下的大模型时
  3. 03图中阴影部分的面积为:
011 / 3
第 1 页
第 1 页

为什么需要流水线并行(Pipelin…

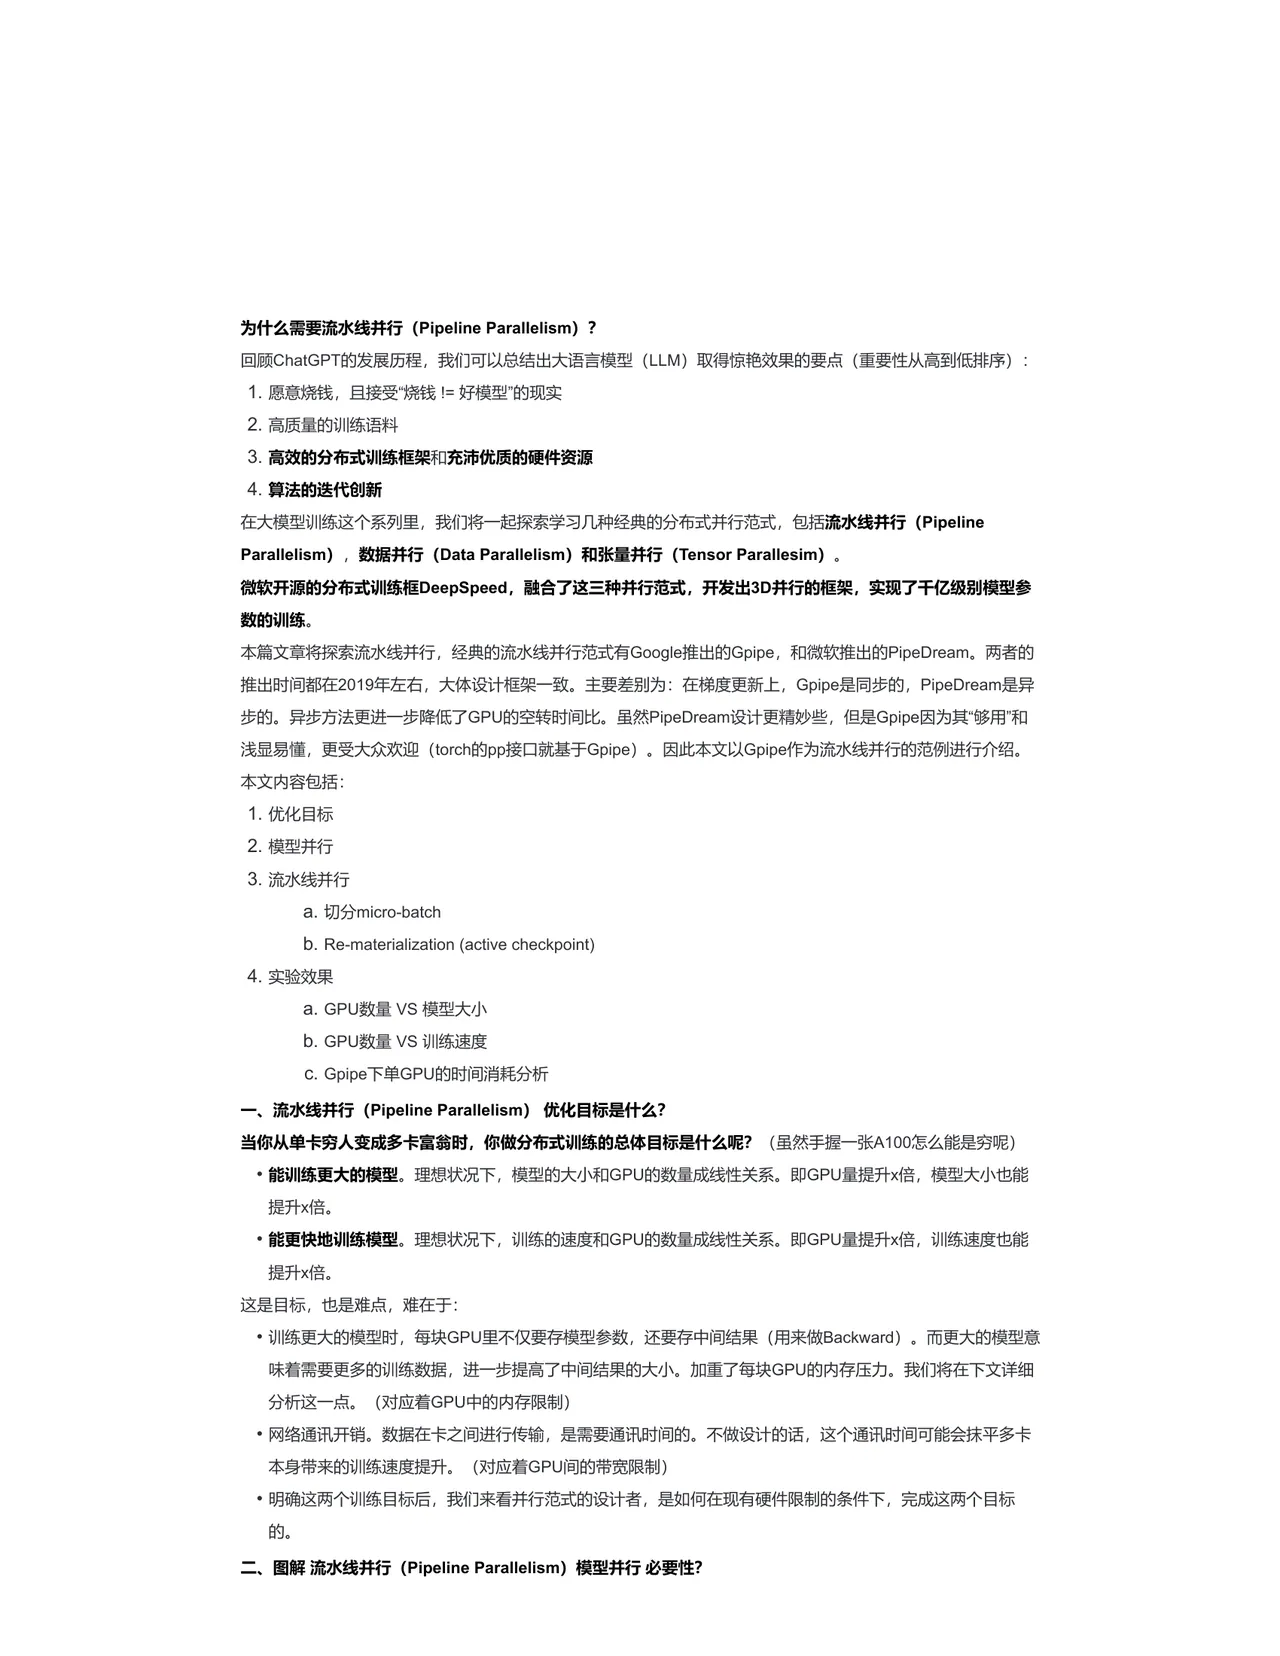
为什么需要流水线并行(Pipeline Parallelism)? 回顾 ChatGPT 的发展历程,我们可以总结出大语言模型(LLM)取得惊艳效果的要点(重要性从高到低排序): 1.愿意烧钱,且接受"烧钱!=好模型”的现实 2.高质量的训练语料 3. 高效的分布式训练框架和充沛优质的硬件资源 4. 算法的选代创新 在大模型训练这个系列里,我们将一起探索学习几种经典的分布式并行范式,包括流水线并行(Pipeline Parallelism),数据并行(Data Parallelism)和张量并行(Tensor Parallesim)。 微软开源的分布式训练框 DeepSpeed,融合了这三种并行范式,开发出 3D 并行的框架,实现了干亿级别模型参 数的训练。 本篇文章将探索流水线并行,经典的流水线并行范式有 Google 推出的 Gpipe,和微软推出的 PipeDream。两者的 推出时间都在 2019 年左右,大体设计框架一致。主要差别为:在梯度更新上,Gpipe 是同步的,PipeDream 是异 步的。异步方法更进一步降低了 GPU 的空转时间比。虽然 PipeDream 设计更精妙些,但是 Gpipe 因为其”够用”和 浅显易懂,更受大众欢迎(torch 的 pp 接口就基于 Gpipe)。因此本文以 Gpipe 作为流水线并行的范例进行介绍。 本文内容包括: 1. 优化目标 2. 模型并行 3.流水线并行

a. 切分 micro-batch b. Re-materialization (active checkpoint) 4. 实验效果 a. GPU 数量 VS 模型大小 b. GPU 数量 VS 训练速度

  • c. Gpipe 下单 GPU 的时间消耗分析 一、流水线并行(Pipeline Parallelism)优化目标是什么? 当你从单卡穷人变成多卡富翁时,你做分布式训练的总体目标是什么呢?(虽然手握一张 A100 怎么能是穷呢)
  • 能训练更大的模型。理想状况下,模型的大小和 GPU 的数量成线性关系。即 GPU 量提升 x 倍,模型大小也能 提升 x 倍。
  • 能更快地训练模型。理想状况下,训练的速度和 GPU 的数量成线性关系。即 GPU 量提升 x 倍,训练速度也能 提升 x 倍。 这是目标,也是难点,难在于:
  • 训练更大的模型时,每块 GPU 里不仅要存模型参数,还要存中间结果(用来做 Backward)。而更大的模型意 味着需要更多的训练数据,进一步提高了中间结果的大小。加重了每块 GPU 的内存压力。我们将在下文详细 分析这一点。(对应着 GPU 中的内存限制)
  • 网络通讯开销。数据在卡之间进行传输,是需要通讯时间的。不做设计的话,这个通讯时间可能会抹平多卡 本身带来的训练速度提升。(对应着 GPU 间的带宽限制)
  • 明确这两个训练目标后,我们来看并行范式的设计者,是如何在现有硬件限制的条件下,完成这两个目标 的。 二、图解流水线并行(Pipeline Parallelism)模型并行必要性?
022 / 3
第 2 页
第 2 页

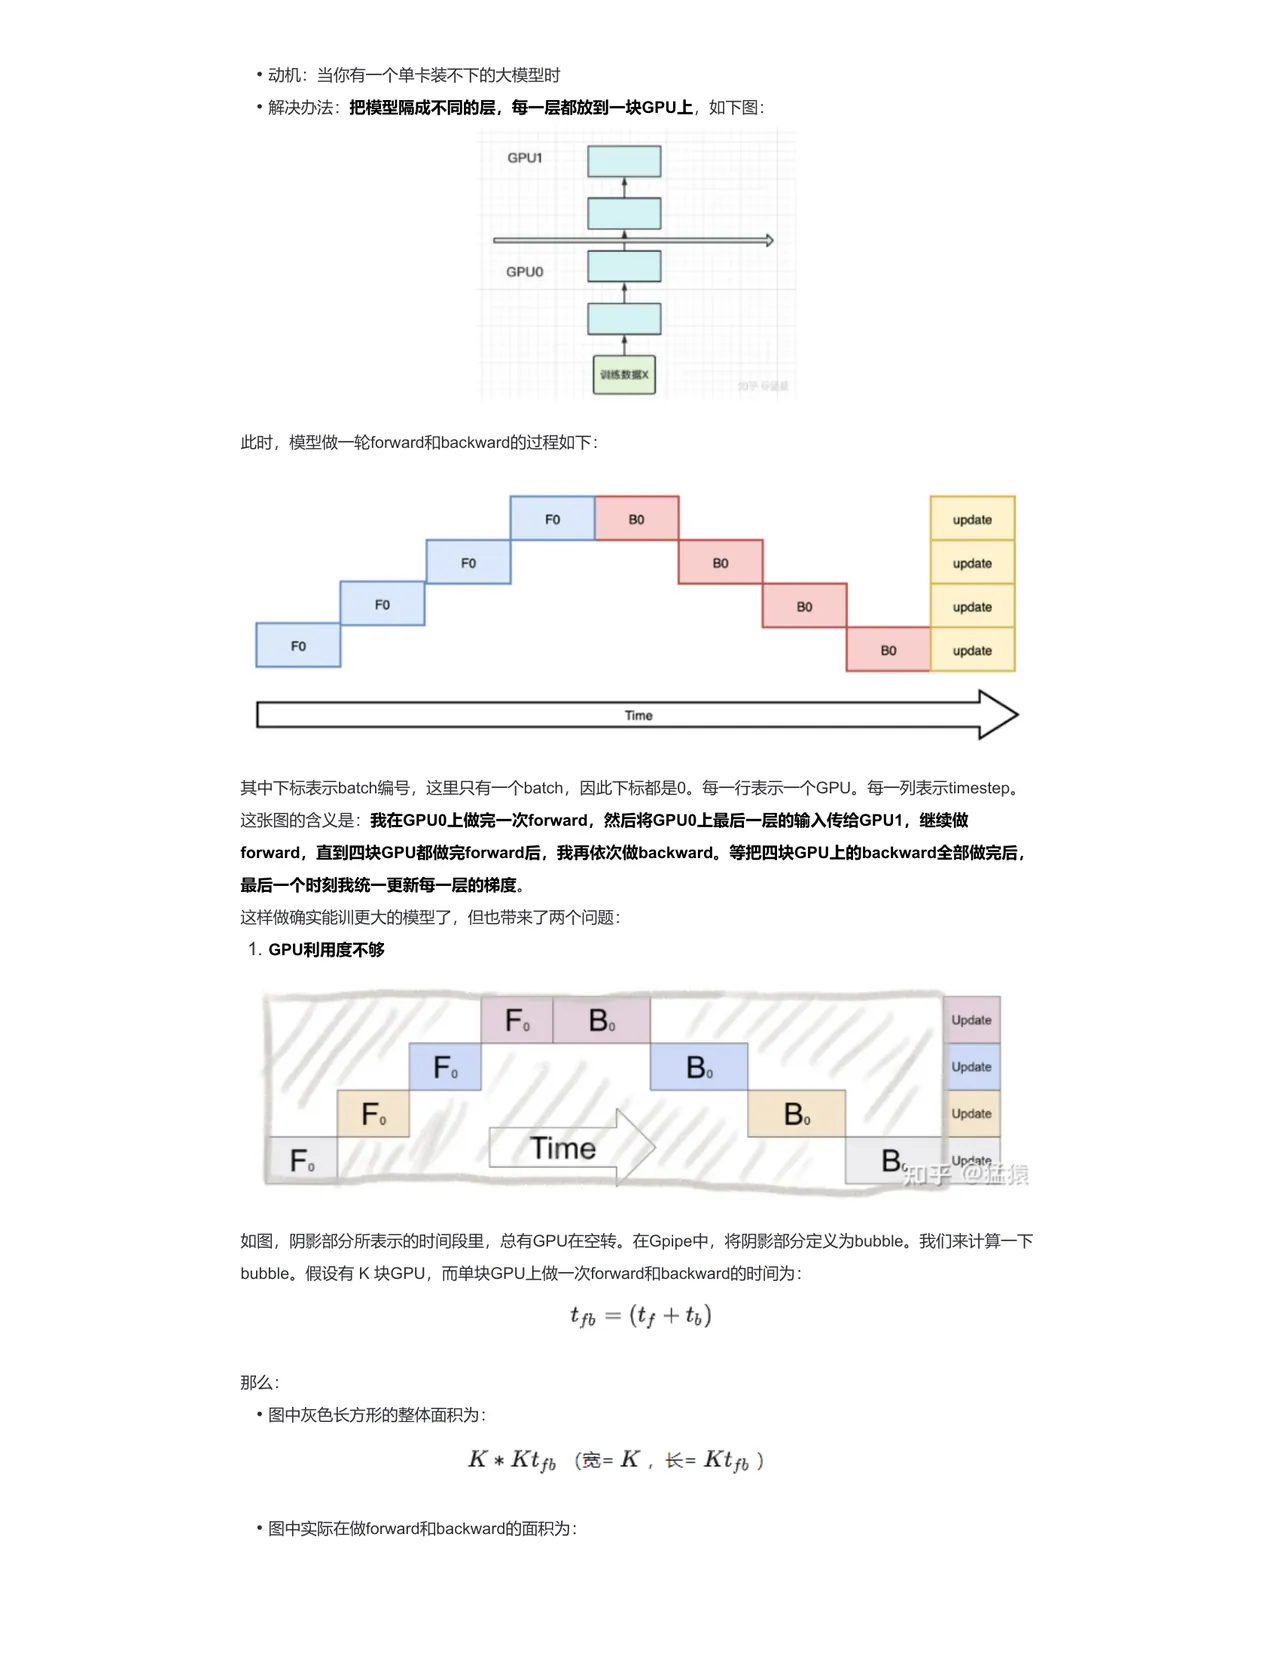
动机:当你有一个单卡装不下的大模型时

  • 动机:当你有一个单卡装不下的大模型时
  • 解决办法:把模型隔成不同的层,每一层都放到一块 GPU 上,如下图:

GPU1

此时,模型做一轮 forward 和 backward 的过程如下:

FO FO BO B0 FO

Time

其中下标表示 batch 编号,这里只有一个 batch,因此下标都是 0。每一行表示一个 GPU。每一列表示 timestep。 这张图的含义是:我在 GPUO 上做完一次 forward,然后将 GPUO 上最后一层的输入传给 GPU1,继续做 forward,直到四块 GPU 都做完 forward 后,我再依次做 backward。等把四块 GPU 上的 backward 全部做完后, 最后一个时刻我统一更新每一层的梯度。 这样做确实能训更大的模型了,但也带来了两个问题: 1. GPU 利用度不够

F。

如图,阴影部分所表示的时间段里,总有 GPU 在空转。在 Gpipe 中,将阴影部分定义为 bubble。我们来计算一下 bubble。假设有 K 块 GPU,而单块 GPU 上做一次 forward 和 backward 的时间为:

那么: •图中灰色长方形的整体面积为:

K*Ktfo (宽二五,长=Ktfo)

•图中实际在做 forward 和 backward 的面积为:

update

update

update update

Update Update Update

033 / 3
第 3 页
第 3 页

图中阴影部分的面积为:

•图中阴影部分的面积为:

•图像阴影部分的占比为:

则我们定义出 bubble 部分的时间复杂度为:

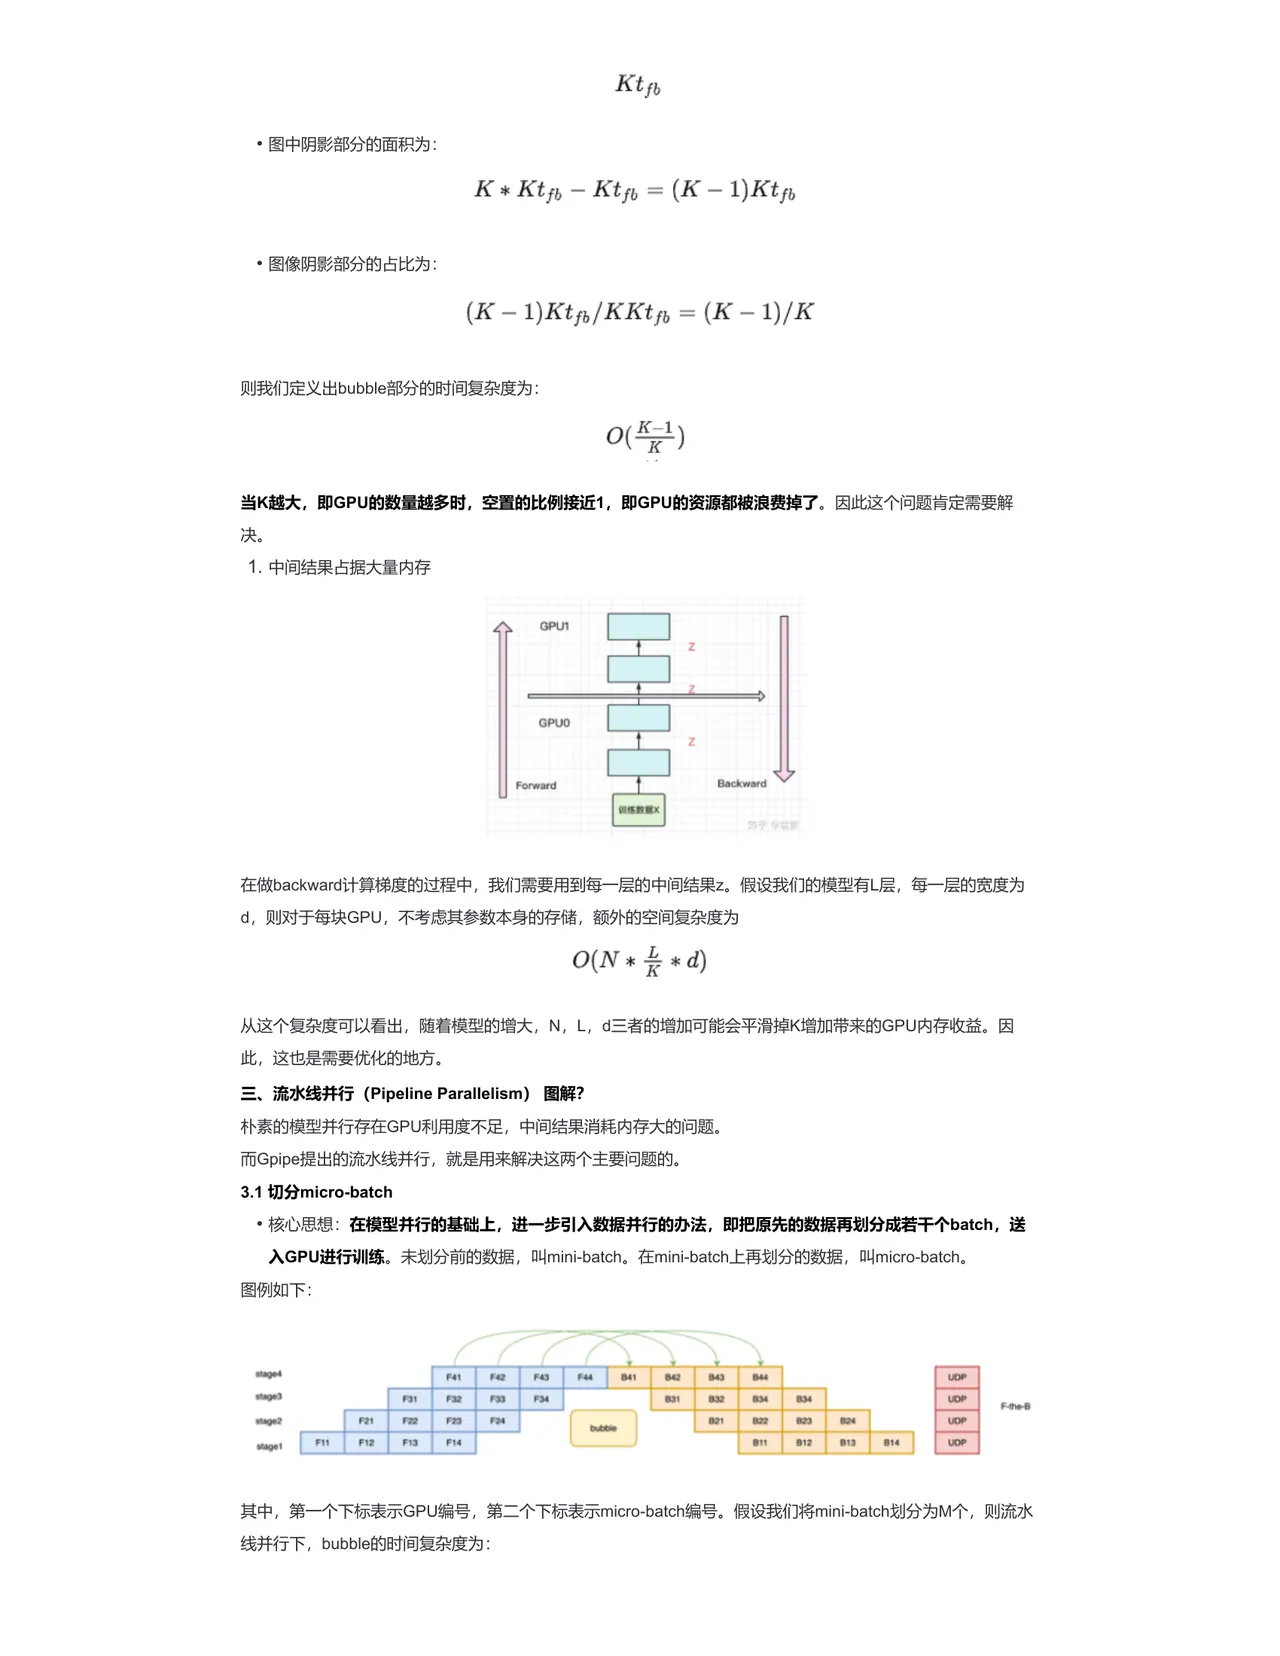
当 K 越大,即 GPU 的数量越多时,空置的比例接近 1,即 GPU 的资源都被浪费掉了。因此这个问题肯定需要解 决。 1. 中间结果占据大量内存

在做 backward 计算梯度的过程中,我们需要用到每一层的中间结果 z。假设我们的模型有 L 层,每一层的宽度为 d,则对于每块 GPU,不考虑其参数本身的存储,额外的空间复杂度为

从这个复杂度可以看出,随着模型的增大,N,L,d 三者的增加可能会平滑掉 K 增加带来的 GPU 内存收益。因 此,这也是需要优化的地方。

三、流水线并行(Pipeline Parallelism)图解? 朴素的模型并行存在 GPU 利用度不足,中间结果消耗内存大的问题。 而 Gpipe 提出的流水线并行,就是用来解决这两个主要问题的。

3.1 切分 micro-batch

•核心思想:在模型并行的基础上,进一步引入数据并行的办法,即把原先的数据再划分成若干个 batch,送 入 GPU 进行训练。未划分前的数据,叫 mini-batch。在 mini-batch 上再划分的数据,叫 micro-batch。 图例如下:

其中,第一个下标表示 GPU 编号,第二个下标表示 micro-batch 编号。假设我们将 mini-batch 划分为 M 个,则流水 线并行下,bubble 的时间复杂度为:

GPUO

Forward

Backward

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求