训练、微调与数据面试题图文讲义4153 字

大模型分布式训练面试题

·全库 152 / 611

《大模型分布式训练面试题》共 9 页、0.4 万字,通篇围绕 显存、GPU、推理、成本 展开,归在「训练、微调与数据」这一层。

覆盖显存GPU推理成本监控微调

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(8 节)
  1. PipeDream Device
  2. 1.ChatGML 在 V100 单卡推理耗时统计
  3. 给我介绍一下苹果公
  4. 给我介绍一下微软公 s
  5. 给我个绍一下苹果公 s
  6. 给我个绍一下微软公 s
  7. 给我介绍一下苹果公 s
  8. 给我介餐一下苹果公 s

原 PDF 已逐页还原成图,共 9 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 011.理论篇 1.1 训练大语言模型存…
  2. 02后向传递 优化噐更新 前向传递 模型…
  3. 03PipeDream Device
011 / 3
第 1 页
第 1 页

1.理论篇 1.1 训练大语言模型存…

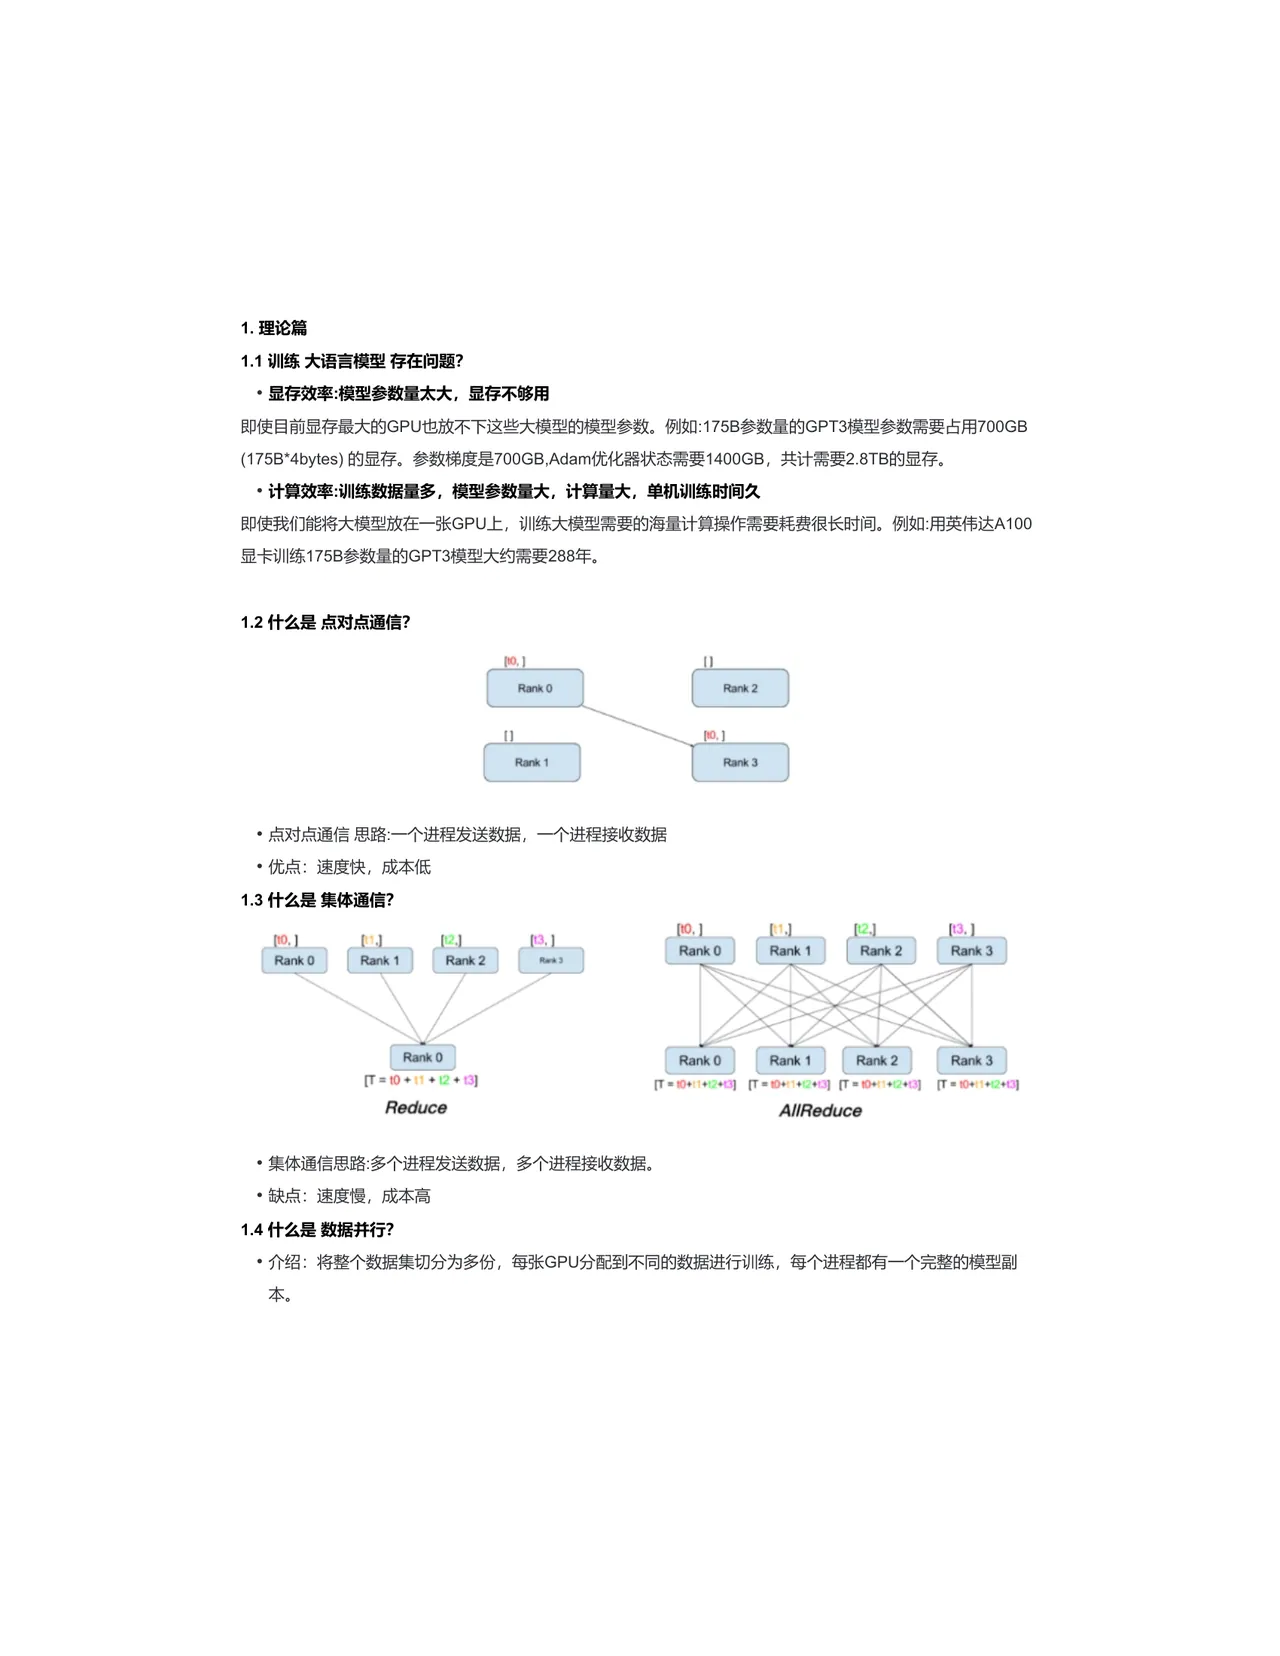
  • 1.理论篇 1.1 训练大语言模型存在问题?
  • 显存效率:模型参数量太大,显存不够用 即使目前显存最大的 GPU 也放不下这些大模型的模型参数。例如:175B 参数量的 GPT3 模型参数需要占用 700GB (175B*4bytes)的显存。参数梯度是 700GB.Adam 优化器状态需要 1400GB,共计需要 2.8TB 的显存。
  • 计算效率;训练数据量多,模型参数量大,计算量大,单机训练时间久 即使我们能将大模型放在一张 GPU 上,训练大模型需要的海量计算操作需要耗费很长时间。例如:用英伟达 A100 显卡训练 175B 参数量的 GPT3 模型大约需要 288 年。

1.2 什么是点对点通信?

  • 点对点通信思路:一个进程发送数据,一个进程接收数据
  • 优点:速度快,成本低 1.3 什么是集体通信?
  • 集体通信思路:多个进程发送数据,多个进程接收数据。
  • 缺点:速度慢,成本高 1.4 什么是数据井行?
  • 介绍:将整个数据集切分为多份,每张 GPU 分配到不同的数据进行训练,每个进程都有一个完整的模型副 本。

Rank 1|

Rank

Rank 0

Reduce

Rank Rank

Rank Rank

AllReduce

022 / 3
第 2 页
第 2 页

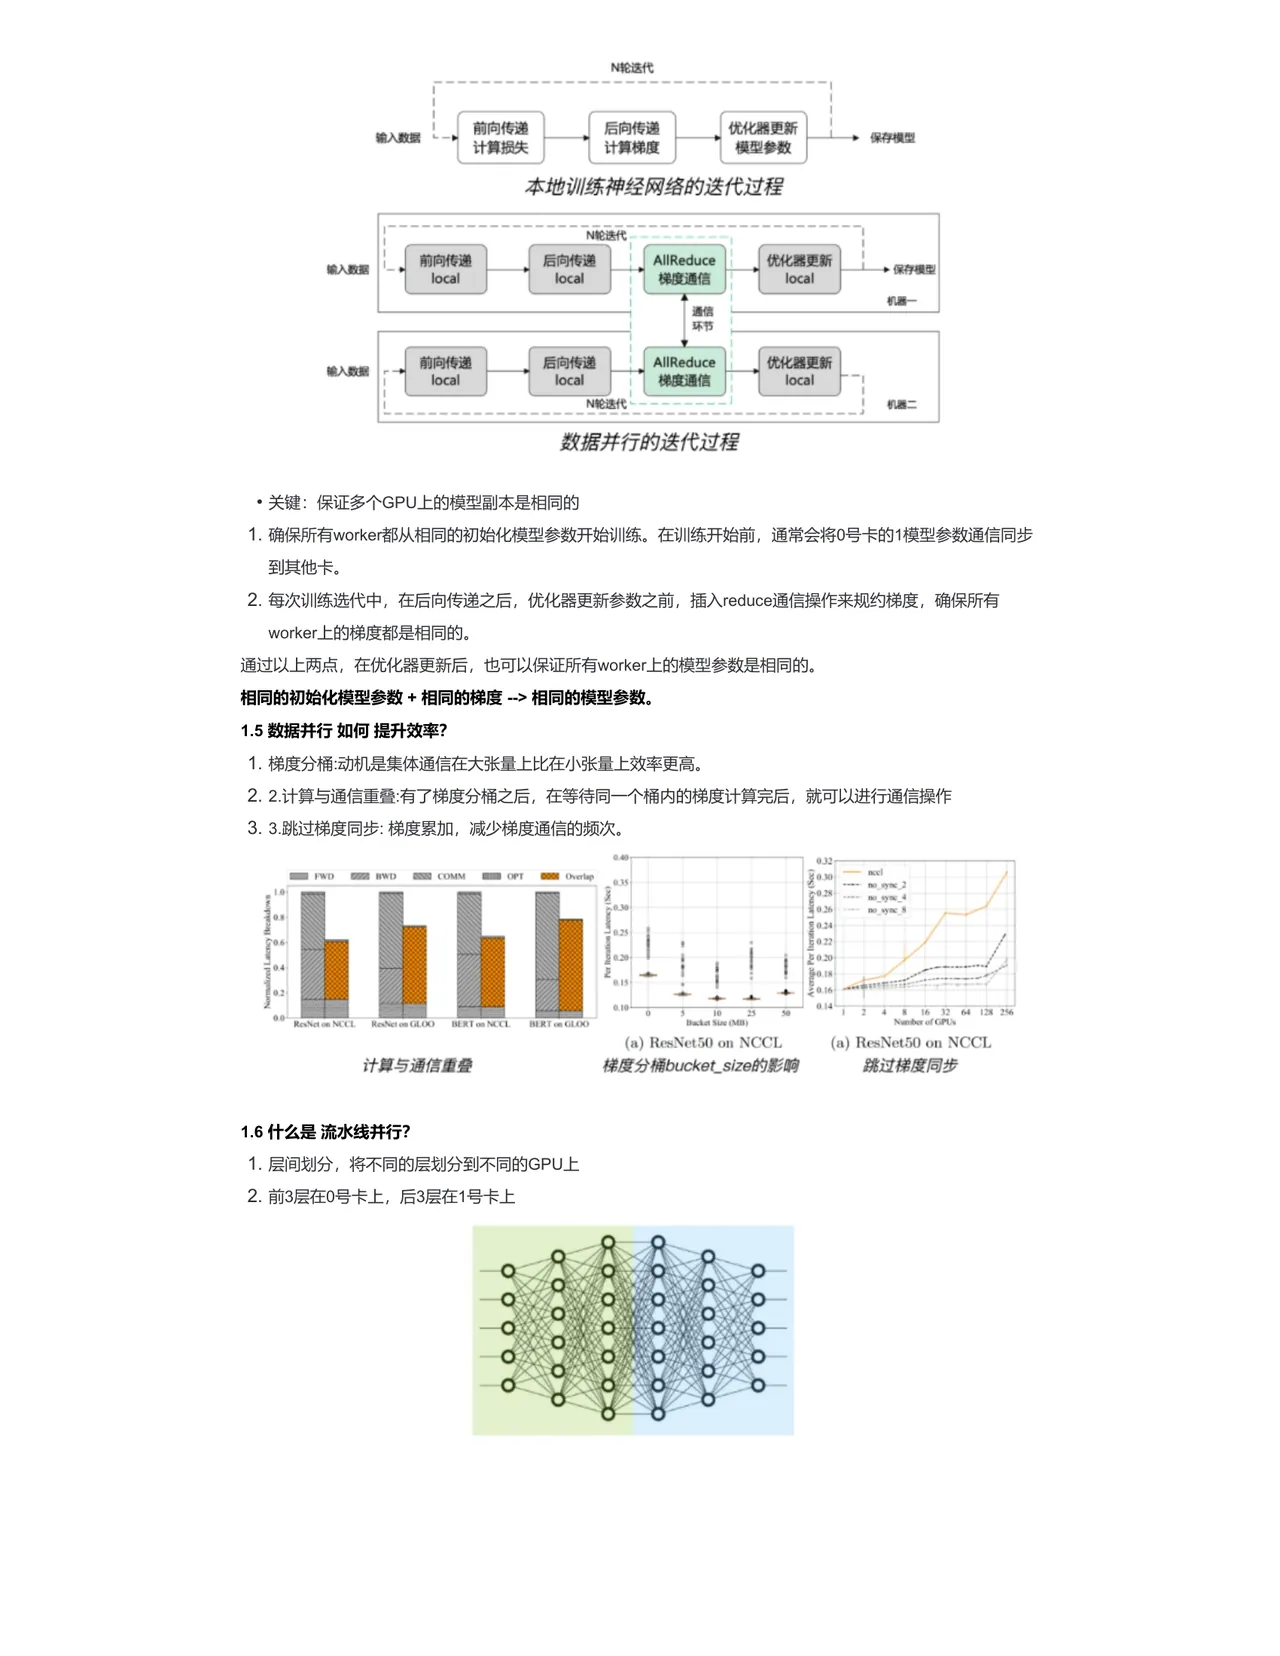
后向传递 优化噐更新 前向传递 模型…

N 轮迭代

后向传递 优化噐更新 前向传递 模型参数 计算损失 计算梯度 本地训练神经网络的迭代过程

AllReduce

后向传递 前向传递

梯度通信 local local local 机器一 通信 环节

优化嚣更新

AllReduce

后向传递 前向传递 local local local 梯度通信

数据并行的迭代过程

•关键:保证多个 GPU 上的模型副本是相同的 1.确保所有 worker 都从相同的初始化模型参数开始训练。在训练开始前,通常会将 0 号卡的 1 模型参数通信同步 到其他卡。 2.每次训练选代中,在后向传递之后,优化器更新参数之前,插入 reduce 通信操作来规约梯度,确保所有 worker 上的梯度都是相同的。 通过以上两点,在优化器更新后,也可以保证所有 worker 上的模型参数是相同的。 相同的初始化模型参数+相同的梯度->相同的模型参数。 1.5 数据并行如何提升效率? 1.梯度分桶:动机是集体通信在大张量上比在小张量上效率更高。 2.2.计算与通信重叠:有了梯度分桶之后,在等待同一个桶内的梯度计算完后,就可以进行通信操作 3. 3.跳过梯度同步:梯度累加,减少梯度通信的频次。

(a)ResNet50 on NCCL (a)ResNet50 on NCCL 计算与通信重叠 跳过梯度同步 梯度分桶 bucket_size 的影响

1.6 什么是流水线井行? 1.层间划分,将不同的层划分到不同的 GPU 上 2.前 3 层在 0 号卡上,后 3 层在 1 号卡上

033 / 3
第 3 页:PipeDream Device
第 3 页

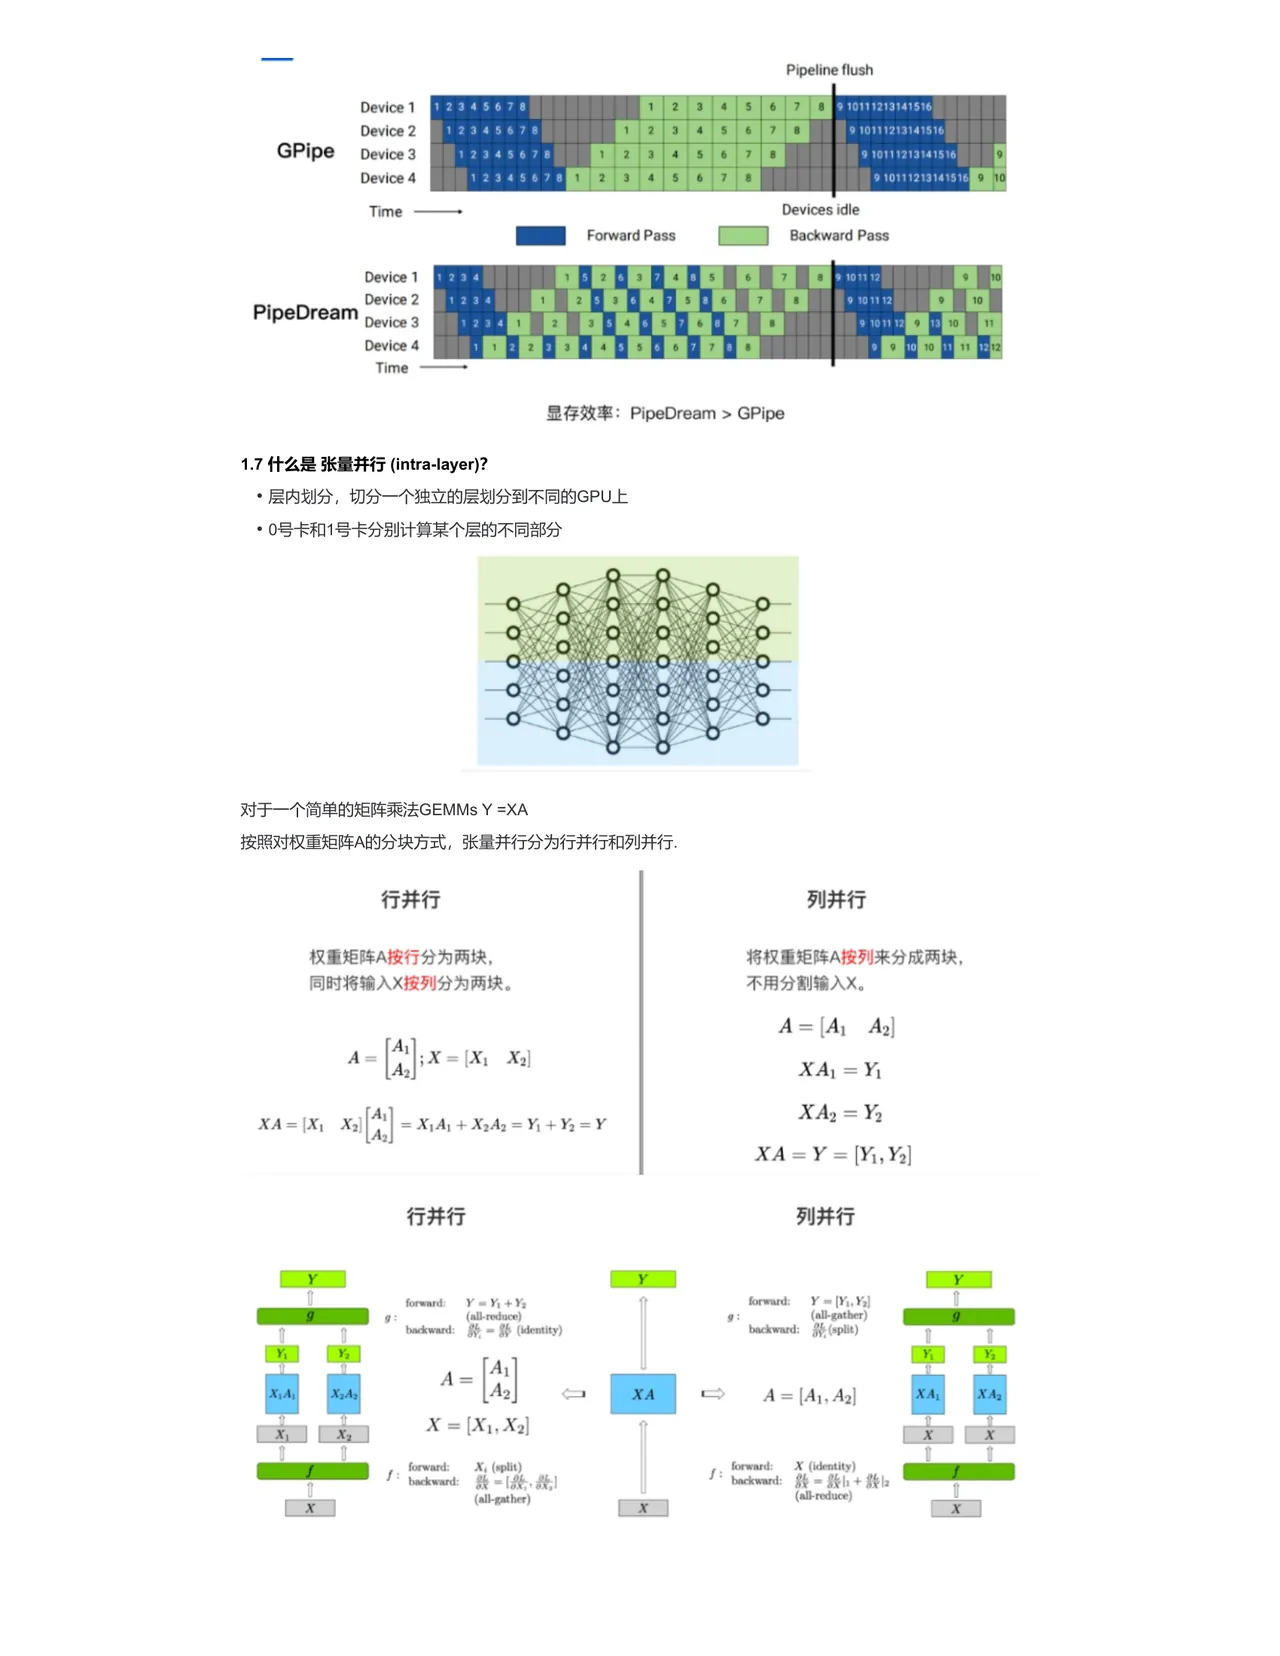
PipeDream Device

Pipeline flush. 9 10111213141516 Device ② 10111213141516 Device

GPipe

Device ⑨ 10111213141516 9 10111213141516 9 10 Devices idle Backward Pass Forward Pass Device Device Device Time

  • 显存效率:PipeDream >GPipe 1.7 什么是张量并行(intra-layer)?
  • 层内划分,切分一个独立的层划分到不同的 GPU 上
  • 0 号卡和 1 号卡分别计算某个层的不同部分

对于一个简单的矩阵乘法 GEMMsY=XA 按照对权重矩阵 A 的分块方式,张量并行分为行并行和列并行. 列并行 行并行

将权重矩阵 A 按列来分成两块, 权重矩阵 A 按行分为两块, 不用分割输入 X。 同时将输入 X 按列分为两块。

列并行 行井行

forward: forward: (all-gather) (all-reduce)

器-影(kentity)

backward: backward:

XA

forward: forward: X (identity) (all-reduce) (all-gather)

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求