
分布式训练之DataParallel面试题
《分布式训练之DataParallel面试题》共 7 页、0.4 万字,通篇围绕 GPU、CUDA、向量、显存 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(6 节)
- FWD/BWD
- AllReduce
- 4.5 device_ids 0 被占用问题
- input tensors were
- Rank Rank2|
- Rank Rank Rank
原 PDF 已逐页还原成图,共 7 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。
为什么需要 nn.DataParal…
为什么需要 nn.DataParallel?
- 多 GPU 并行训练的原理就是将模型参数和数据分布到多个 GPU 上,同时利用多个 GPu 计算加速训练过程。具体 实现需要考虑以下两个问题: 数据如何划分?因为模型需要处理的数据通常很大,将所有数据放入单个 GPU 内存中可能会导致内存不足,因此 我们需要将数据划分到多个 GPU 上。一般有两种划分方式:
- 数据并行:将数据分割成多个小批次,每个 GPU 处理其中的一个小批次,然后将梯度汇总后更新模型参数。
- 模型并行:将模型分解成多个部分,每个 GPU 处理其中一个部分,并将处理结果传递给其他 GPU 以获得最终 结果。 计算如何协同?因为每个 GPU 都需要计算模型参数的梯度并将其发送给其他 GPU,因此需要使用同步机制来保 证计算正确性。一般有两种同步方式:
- 数据同步:在每个 GPU 上计算模型参数的梯度,然后将梯度发送到其他 GPU 上进行汇总,最终更新模型参 数。
- 模型同步:在每个 GPU 上计算模型参数的梯度,然后将模型参数广播到其他 GPU 上进行汇总,最终更新模型 参数。
一、pytorch 中的 GPU 操作默认是什么样? pytorch 中的 GPU 操作默认是异步的,当调用函数需要使用 GPU 时,该函数操作就会进入特定设备队列中等待 执行,正因为此,pytorch 支持并行计算。不过 pytorch 并行计算的效果对调用者是不可见。 Pytorch 中的多 GPU 并行计算是数据级并行,相当于开了多个进程,每个进程自己独立运行,然后再整合在一 起。 device_ids = [ 0, 1 ] net = torch.nn. DataParallel (net, device_ids=device_ids) 二、介绍一下 nn.DataParallel 函数? nn.DataParallel 函数 torch.nn.DataParallel (module, device_ids=None, output_device=None, dim=O)
- module:即模型,此处注意,虽然输入数据被均分到不同 gpu 上,但每个 gpu 上都要拷贝一份模型;
- device_ids:即参与训练的 gpu 列表,例如三块卡,device_ids =[ O,1,2 ];
- output_device:指定输出 gpu,一般省略。在省略的情况下,默认为第一块卡,即索引为 0 的卡。此 处有一个问题,输入计算是被几块卡均分的,但输出 loss 的计算是由这一张卡独自承担的,这就造成 这张卡所承受的计算量要大于其他参与训练的卡。 使用实例 net = torch. nn. Linear (100, 1) print (net)
net = torch.nn. DataParallel (net, device_ids=[ 0, 3 ]) print (net)
输出 Linear (in_feat…
输出 Linear (in_features=10, out_features=l, bias=True)
DataParallel ( (module):Linear (in_features=10, out_features=l, bias=True)
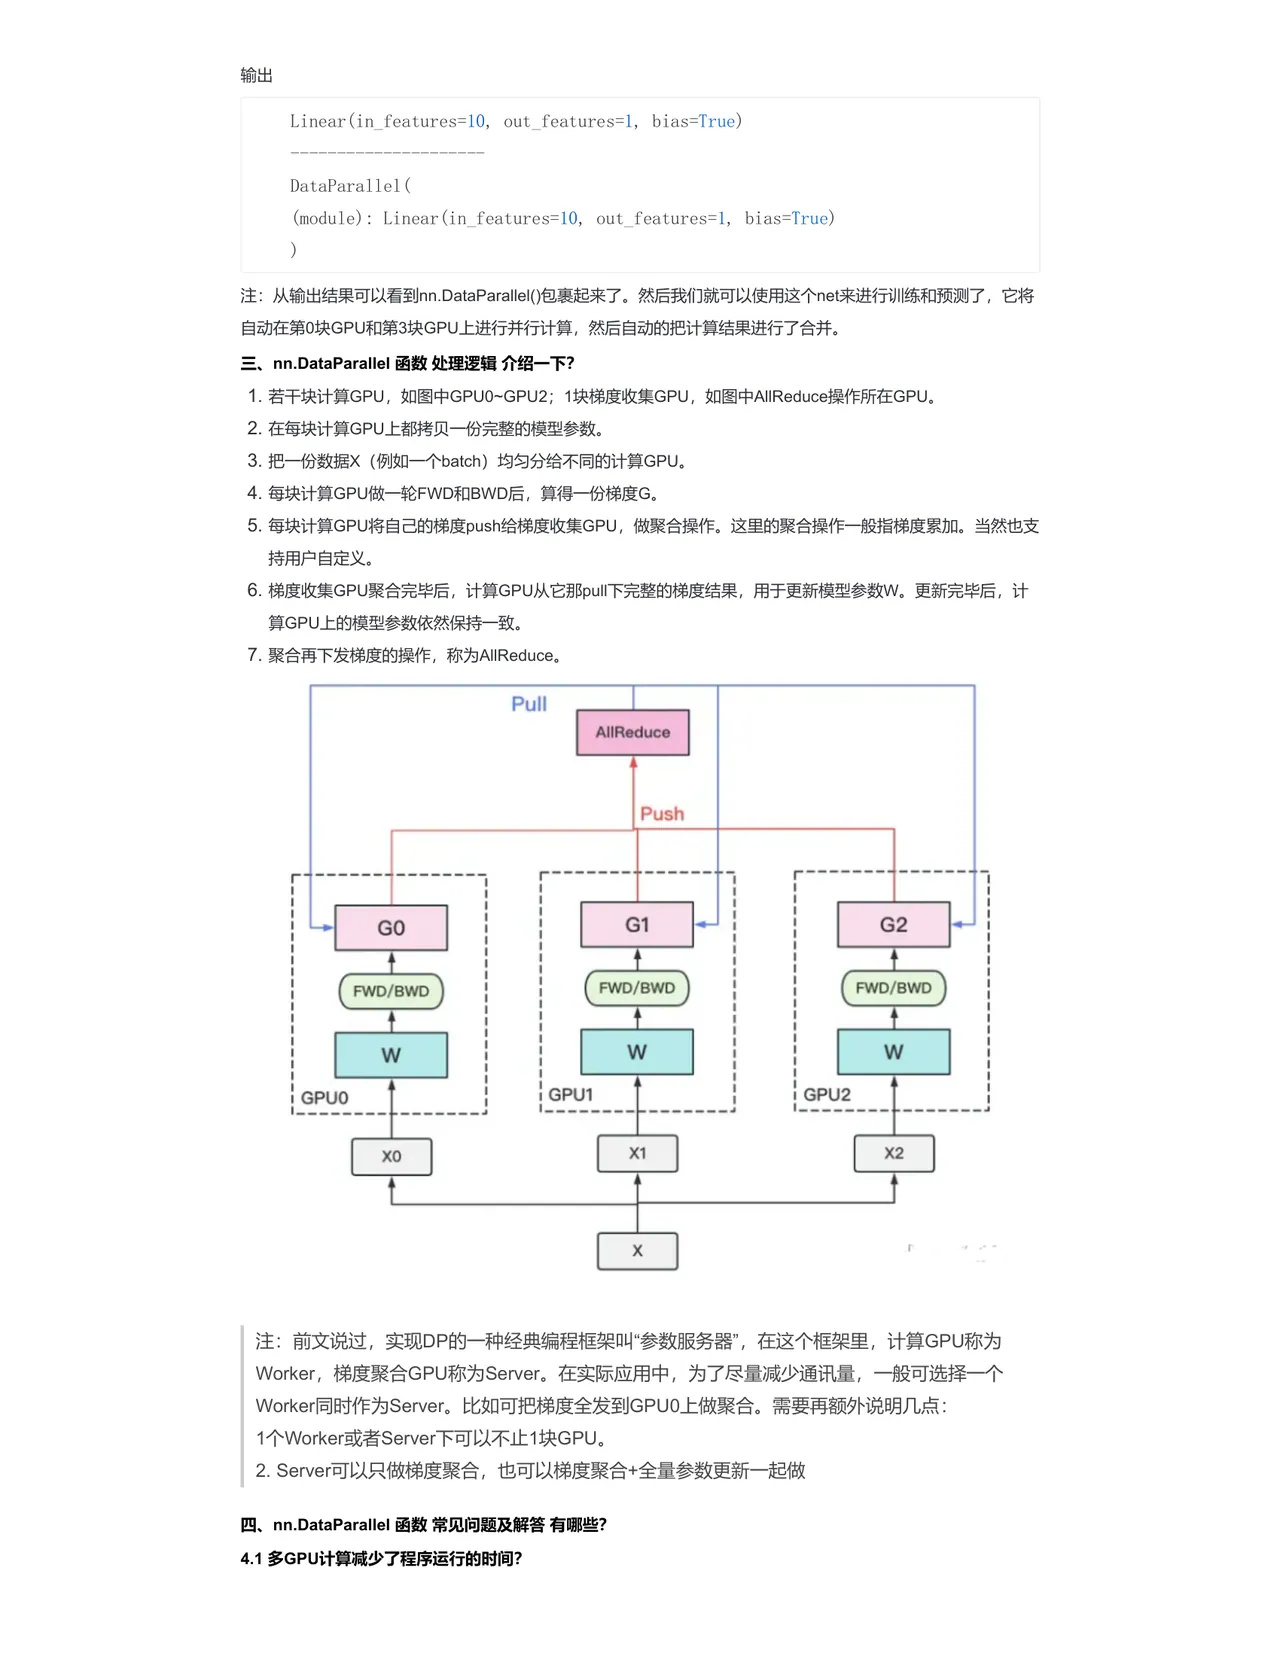
注:从输出结果可以看到 nn.DataParallel ()包裹起来了。然后我们就可以使用这个 net 来进行训练和预测了,它将 自动在第 0 块 GPU 和第 3 块 GPU 上进行并行计算,然后自动的把计算结果进行了合井。 三、nn.DataParallel 函数处理逻辑介绍一下? 1. 若干块计算 GPU,如图中 GPUO~GPU2;1 块梯度收集 GPU,如图中 AlIReduce 操作所在 GPU。 2. 在每块计算 GPU 上都拷贝一份完整的模型参数。 3.把一份数据 X (例如一个 batch)均匀分给不同的计算 GPU。 4.每块计算 GPU 做一轮 FWD 和 BWD 后,算得一份梯度 G。 5.每块计算 GPU 将自己的梯度 push 给梯度收集 GPU,做聚合操作。这里的聚合操作一般指梯度累加。当然也文 持用户自定义。 6. 梯度收集 GPU 聚合完毕后,计算 GPU 从它那 pulI 下完整的梯度结果,用于更新模型参数 W。更新完毕后,计 算 GPU 上的模型参数依然保持一致。 7. 聚合再下发梯度的操作,称为 AIIReduce。
GO
FWD/BWD
注:前文说过,实现 DP 的一种经典编程框架叫“参数服务器”,在这个框架里,计算 GPU 称为 Worker,梯度聚合 GPU 称为 Server。在实际应用中,为了尽量减少通讯量,一般可选择一个 Worker 同时作为 Server。比如可把梯度全发到 GPUO 上做聚合。需要再额外说明几点: 1 个 Worker 或者 Server 下可以不止 1 块 GPU。 2. Server 可以只做梯度聚合,也可以梯度聚合+全量参数更新一起做 四、nn.DataParallel 函数常见问题及解答有哪些? 4.1 多 GPU 计算减少了程序运行的时间?
Pull
AllReduce
Push
G1
G2
FWD/BWD
:GPU2
×2
虽然使用 nn.DataParall…
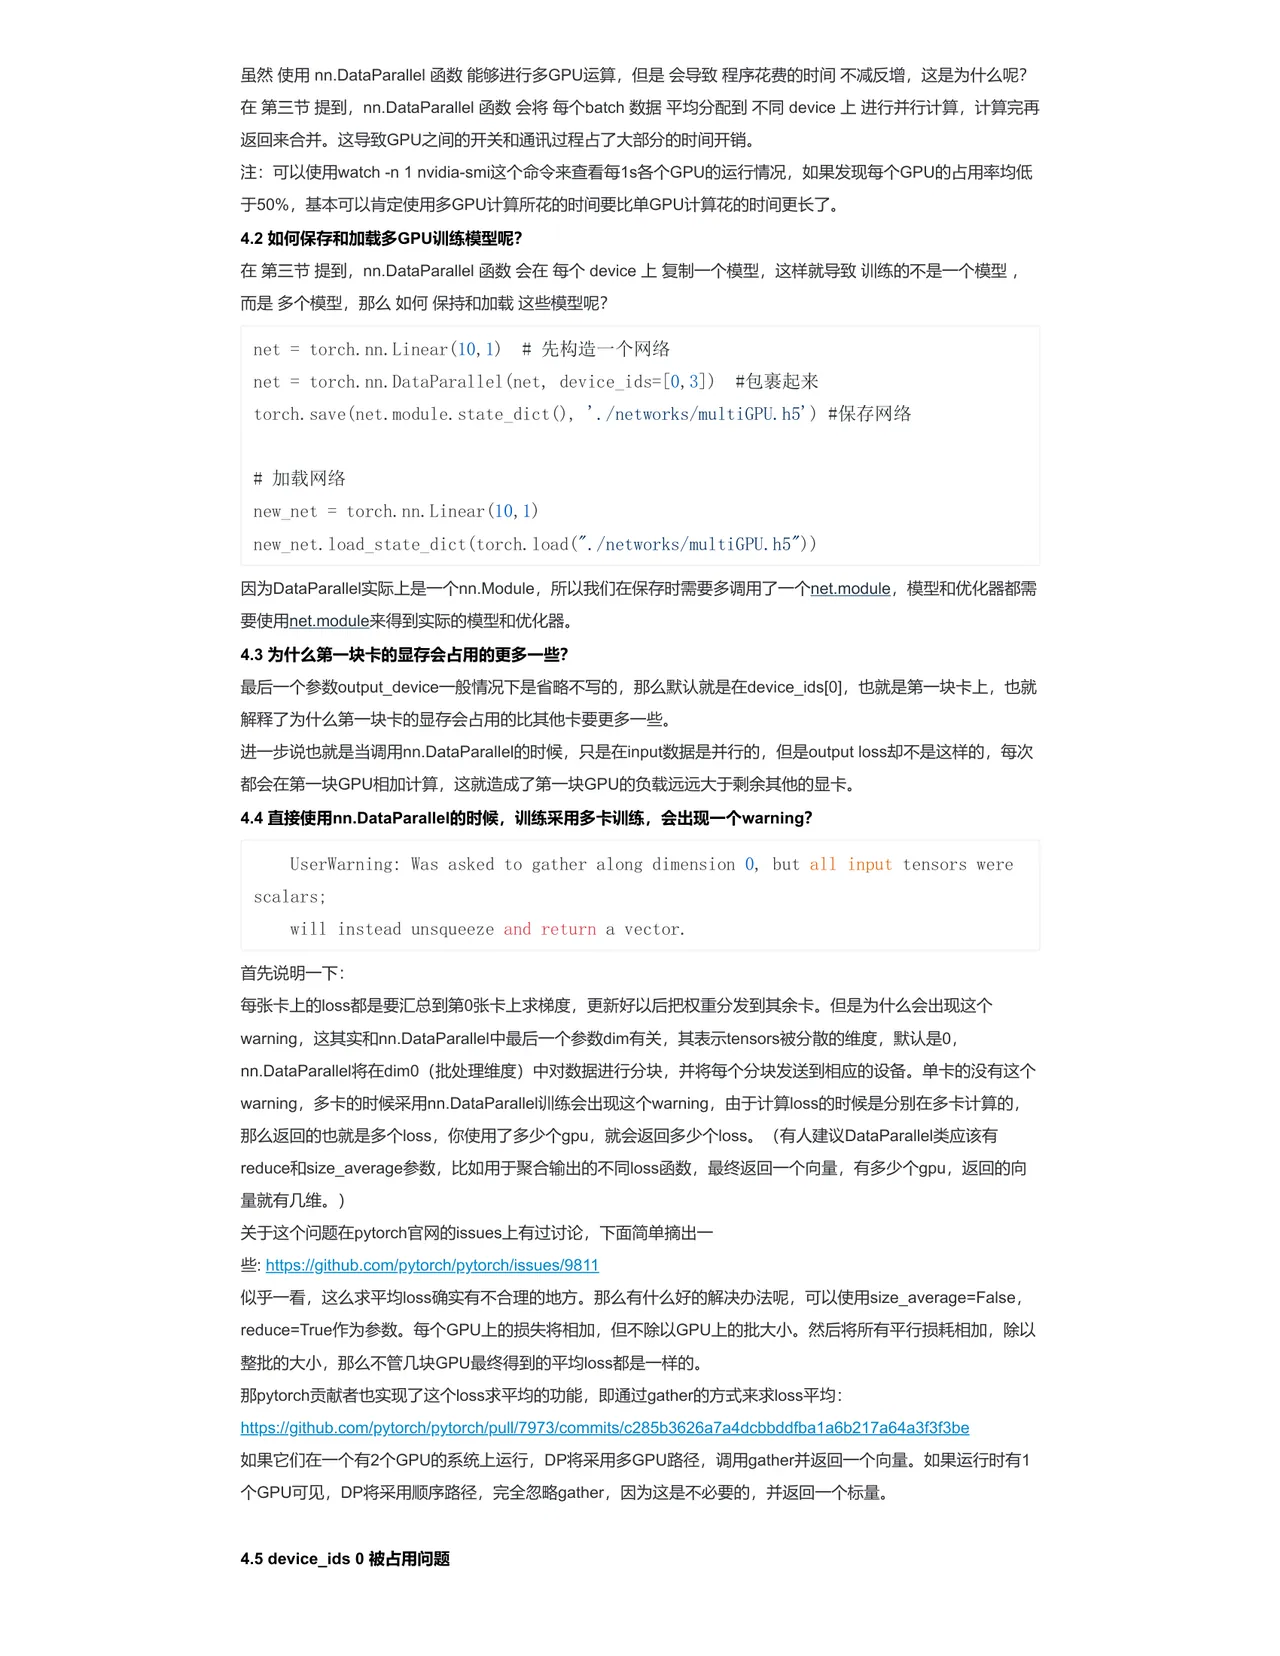
虽然使用 nn.DataParallel 函数能够进行多 GPU 运算,但是会导致程序花费的时间不減反增,这是为什么呢? 在第三节提到,nn.DataParallel 函数会将每个 batch 数据平均分配到不同 device 上进行并行计算,计算完再 返回来合并。这导致 GPU 之间的开关和通讯过程占了大部分的时间开销。 注:可以使用 watch-n 1 nvidia-smi 这个命令来查看每 1s 各个 GPU 的运行情况,如果发现每个 GPU 的占用率均低 于 50%,基本可以肯定使用多 GPU 计算所花的时间要比单 GPu 计算花的时间更长了。 4.2 如何保存和加载多 GPU 训练模型呢? 在第三节提到,nn.DataParallel 函数会在每个 device 上复制一个模型,这样就导致训练的不是一个模型, 而是多个模型,那么如何保持和加载这些模型呢? net = torch.nn. Linear (10, 1)# 先构造一个网络 net = torch.nn. DataParallel (net, device_ids=[ 0, 3 ])#包裹起来 torch.save (net.module.state_dict (),’./networks/multiGPU.h5’)#保存网络
new_net = torch. nn. Linear (10, 1) new_net. load_state_dict (torch. load ("./networks/multiGPU.h5")) 因为 DataParallel 实际上是一个 nn.Module,所以我们在保存时需要多调用了一个 net.module,模型和优化器都需 要使用 net.module 来得到实际的模型和优化器。 4.3 为什么第一块卡的显存会占用的更多一些? 最后一个参数 output_device 一般情況下是省略不写的,那么默认就是在 device_idsi0 ],也就是第一块卡上,也就 解释了为什么第一块卡的显存会占用的比其他卡要更多一些。 进一步说也就是当调用 nn.DataParalle 的时候,只是在 input 数据是并行的,但是 output loss 却不是这样的,每次 都会在第一块 GPU 相加计算,这就造成了第一块 GPU 的负载远远大于剩余其他的显卡。 4.4 直接使用 nn.DataParalleI 的时候,训练采用多卡训练,会出现一个 warning? UserWarning: Was asked to gather along dimension 0, but all| scalars; will instead unsqueeze and return a vector. 首先说明一下:
每张卡上的 loss 都是要汇总到第 0 张卡上求梯度,更新好以后把权重分发到其余卡。但是为什么会出现这个 warning,这其实和 nn.DataParallel 中最后一个参数 dim 有关,其表示 tensors 被分散的维度,默认是 0, n.DataParalle/将在 dimo (批处理维度)中对数据进行分块,并将每个分块发送到相应的设备。单卡的没有这个 warning,多卡的时候采用 nn.DataParalleli 训练会出现这个 warning,由于计算 loss 的时候是分别在多卡计算的, 那么返回的也就是多个 loss,你使用了多少个 gpu,就会返回多少个 loss。(有人建议 DataParallel 类应该有 reduce 和 size_average 参数,比如用于聚合输出的不同 loss 函数,最终返回一个向量,有多少个 gpu,返回的向 量就有几维。) 关于这个问题在 pytorch 官网的 jissues 上有过讨论,下面简单摘出一 些:https://github.com/pytorch/pytorch/issues/9811 似乎一看,这么求平均 loss 确实有不合理的地方。那么有什么好的解决办法呢,可以使用 size_average=False, reduce=True 作为参数。每个 GPU 上的损失将相加,但不除以 GPU 上的批大小。然后将所有平行损耗相加,除以 整批的大小,那么不管几块 GPU 最终得到的平均 loss 都是一样的。 那 pytorch 贡献者也实现了这个 loss 求平均的功能,即通过 gather 的方式来求 loss 平均:
https://github.com/pytorch/pytorch/pull/7973/commits/c285b3626a7a4dcbbddfba1a6b217a64a3f3f3be
如果它们在一个有 2 个 GPU 的系统上运行,DP 将采用多 GPU 路径,调用 gather 并返回一个向量。如果运行时有 个 GPU 可见,DP 将采用顺序路径,完全忽略 gather,因为这是不必要的,并返回一个标量。
4.5 device_ids 0 被占用问题
input tensors were