训练、微调与数据面试题图文讲义3028 字

分布式并行训练面试题

·全库 154 / 611

《分布式并行训练面试题》共 6 页、0.3 万字,通篇围绕 GPU、场景、CUDA、数据集 展开,归在「训练、微调与数据」这一层。

覆盖GPU场景CUDA数据集

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(1 节)
  1. 5/4352,train_loss:0.6

原 PDF 已逐页还原成图,共 6 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01为什么需要 nn.parallel.…
  2. 02一次累加完毕后,蓝色位置的数据块被更…
  3. 03以此类推,同样经过 3 轮迭代后,使…
011 / 3
第 1 页
第 1 页

为什么需要 nn.parallel.…

为什么需要 nn.parallel.DistributedDataParallel?

  • 多 GPU 并行训练的原理就是将模型参数和数据分布到多个 GPU 上,同时利用多个 GPu 计算加速训练过程。具体 实现需要考虑以下三个问题: 1.**数据如何划分?*因为模型需要处理的数据通常很大,将所有数据放入单个 GPU 内存中可能会导致内存不 足,因此我们需要将数据划分到多个 GPU 上。一般有两种划分方式:
  • 数据并行:将数据分割成多个小批次,每个 GPU 处理其中的一个小批次,然后将梯度汇总后更新模型参数。
  • 模型并行:将模型分解成多个部分,每个 GPU 处理其中一个部分,并将处理结果传递给其他 GPU 以获得最终 结果。 2. 计算如何协同?因为每个 GPU 都需要计算模型参数的梯度并将其发送给其他 GPU,因此需要使用同步机 制来保证计算正确性。一般有两种同步方式:
  • 数据同步:在每个 GPU 上计算模型参数的梯度,然后将梯度发送到其他 GPU 上进行汇总,最终更新模型参 数。
  • 模型同步:在每个 GPU 上计算模型参数的梯度,然后将模型参数广播到其他 GPU 上进行汇总,最终更新模型 参数。 3. DP 只支持单机多卡场景,在多机多卡场景下,DP 的通讯问题将被放大。
  • DDP 首先要解决的就是通讯问题:将 Server 上的通讯压力均衡转到各个 Worker 上。实现这一点后,可以进一 步去 Server,留 Worker。 一、什么是 DistributedDataParallel 核心—Ring-AlIReduce? 上节讲到 DP 只支持单机多卡场景,主要原因是 DP 无法数据并行中通讯负载不均的问题,而 DDP 能够解决 该问题的核心在于 Ring-AllReduce。它由百度最先提出,非常有效地解决了数据并行中通讯负载不均的问题, 使得 DDP 得以实现。

1.1 Ring-AlIReduce 介绍

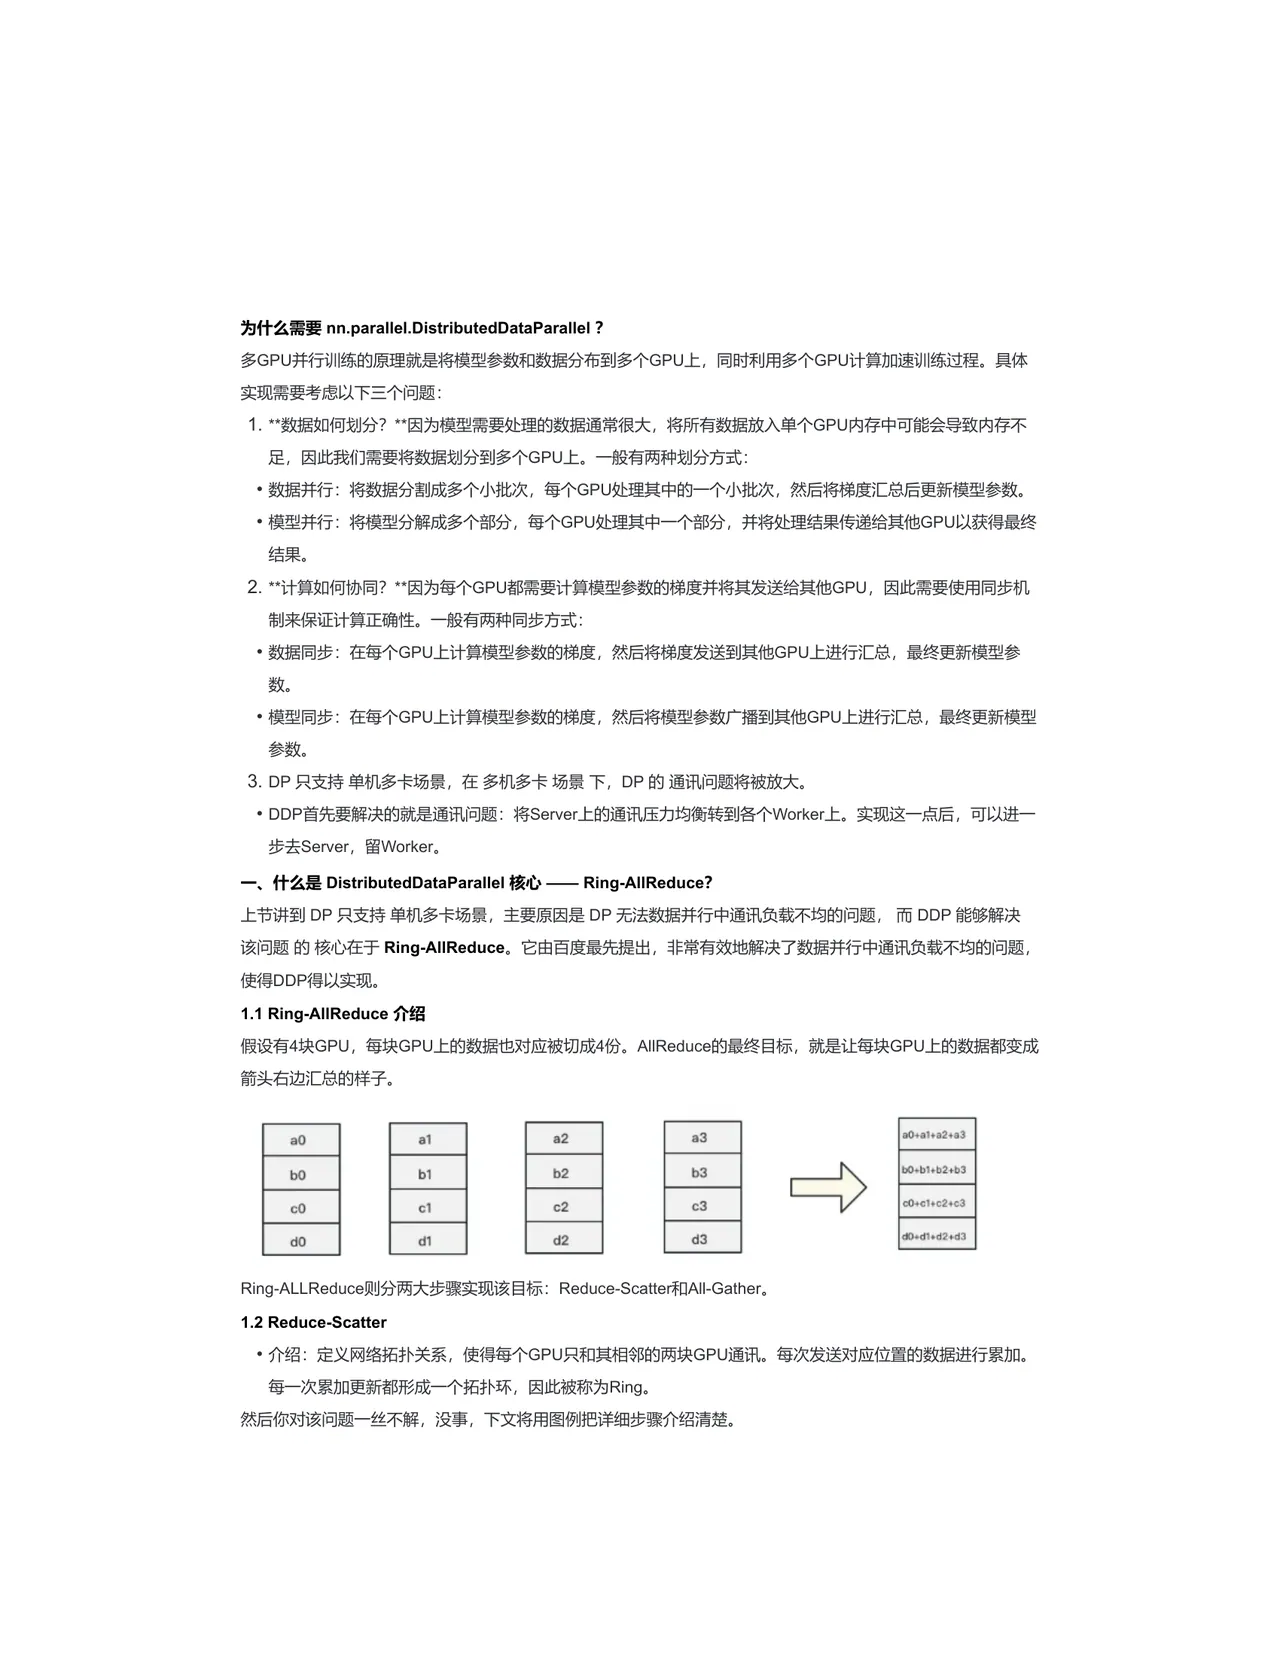
假设有 4 块 GPU,每块 GPU 上的数据也对应被切成 4 份。AlIReduce 的最终目标,就是让每块 GPU 上的数据都变成 箭头右边汇总的样子。

a0

cO

Ring-ALLReduce 则分两大步骤实现该目标:Reduce-Scatter 和 All-Gather。 1.2 Reduce-Scatter

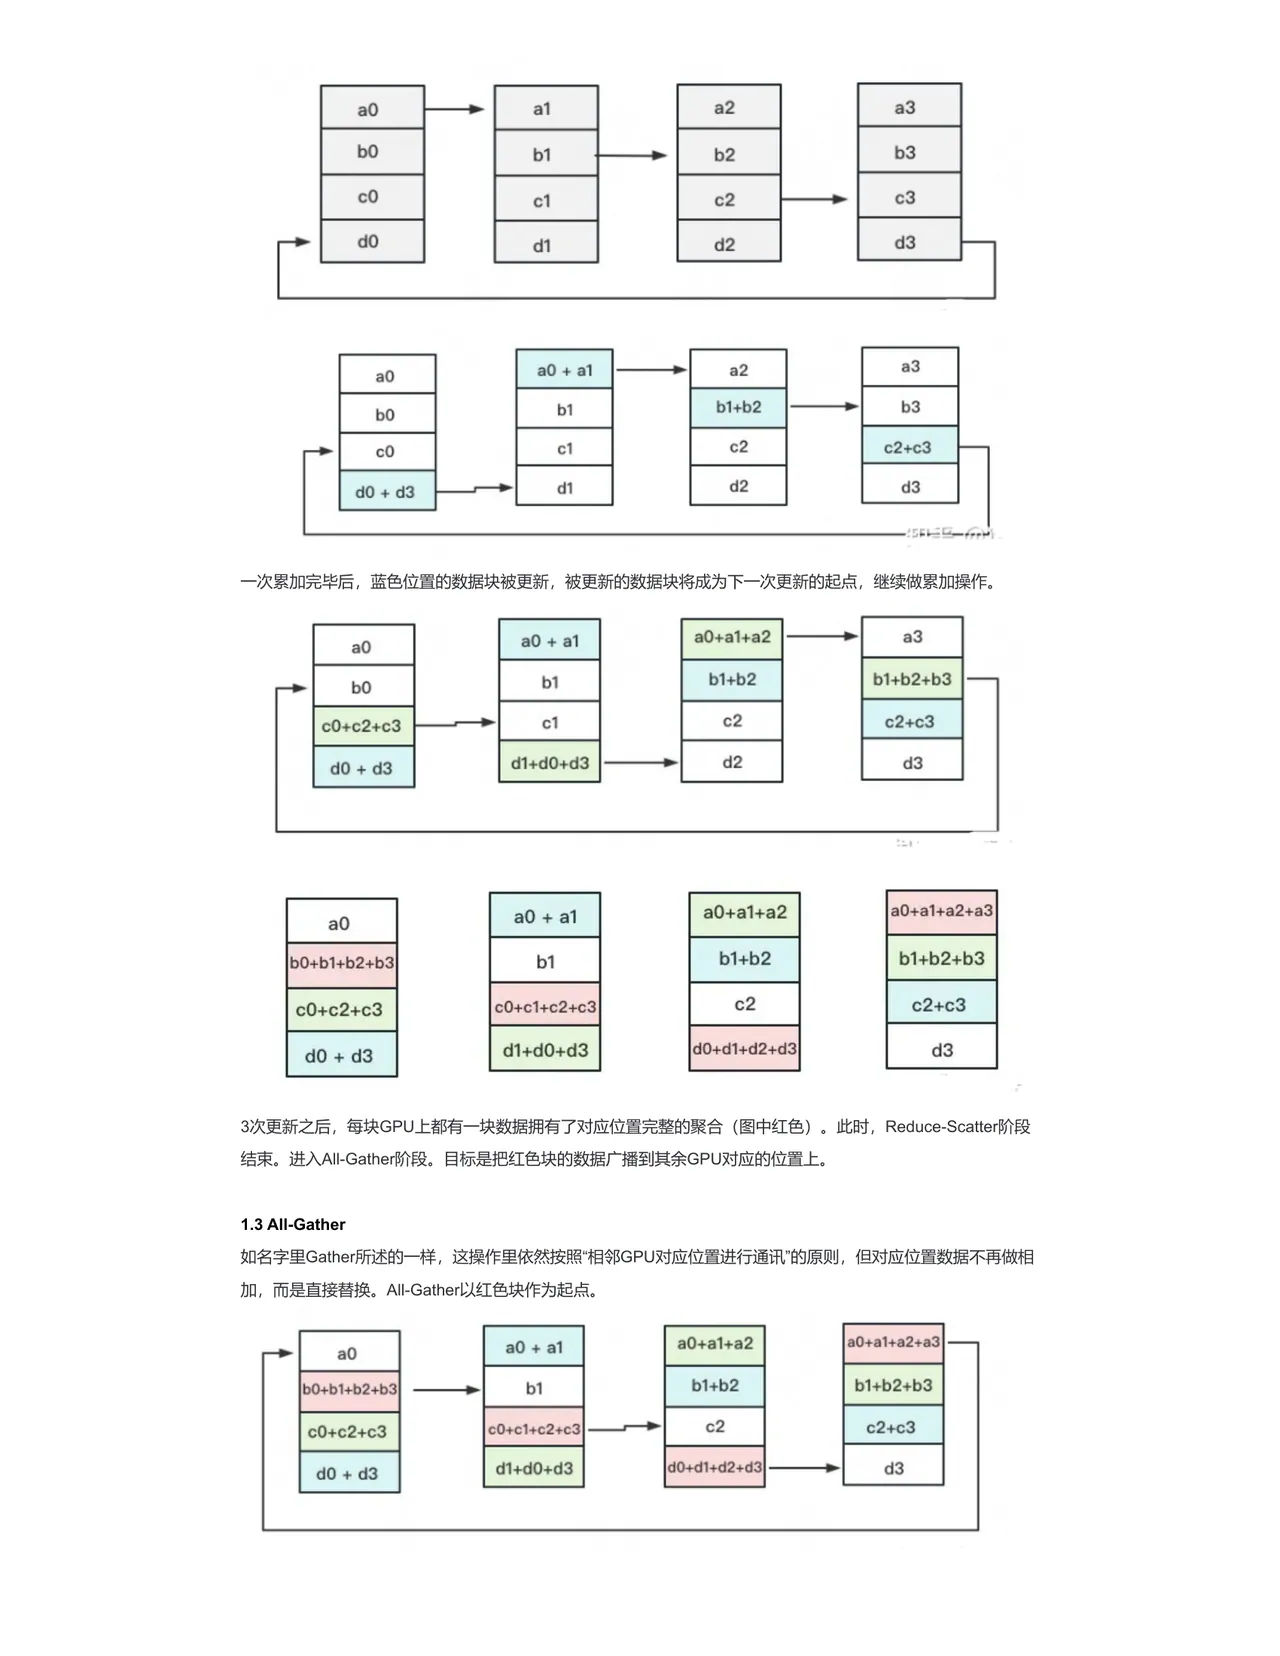
•介绍:定义网络拓扑关系,使得每个 GPU 只和其相邻的两块 GPU 通讯。每次发送对应位置的数据进行累加。 每一次累加更新都形成一个拓扑环,因此被称为 Ring。 然后你对该问题一丝不解,没事,下文将用图例把详细步骤介绍清楚。

a2 b2 c2 d2

a3 b3 c3 d3

b1 c1 d1

022 / 3
第 2 页
第 2 页

一次累加完毕后,蓝色位置的数据块被更…

a3 b3 c3 d3

a3 b3

d3

a3 b1+b2+b3

d3

a0+a1+a2+a3 b1+b2+b3 c2+C3 d3

a0+a1+a2+a3 b1+b2+b3 c2+¢3 d3

a2 b1 b2 c1 c2 d1 d2

a2 b1+b2 b1

c2 c1 d2

d1

a0+a1+a2 b1+b2 b1 c2 c1

d2 d1+d0+d3

a0+al+a2 b1+b2 b1 c2 d0+d1+d2+d3 d1+d0+d3

a0+a1+a2 b1+b2

b1

c2 |do+d1+d2+d3 d1+d0+d3

cO

一次累加完毕后,蓝色位置的数据块被更新,被更新的数据块将成为下一次更新的起点,继续做累加操作。

a0

b0+b1+b2+b3

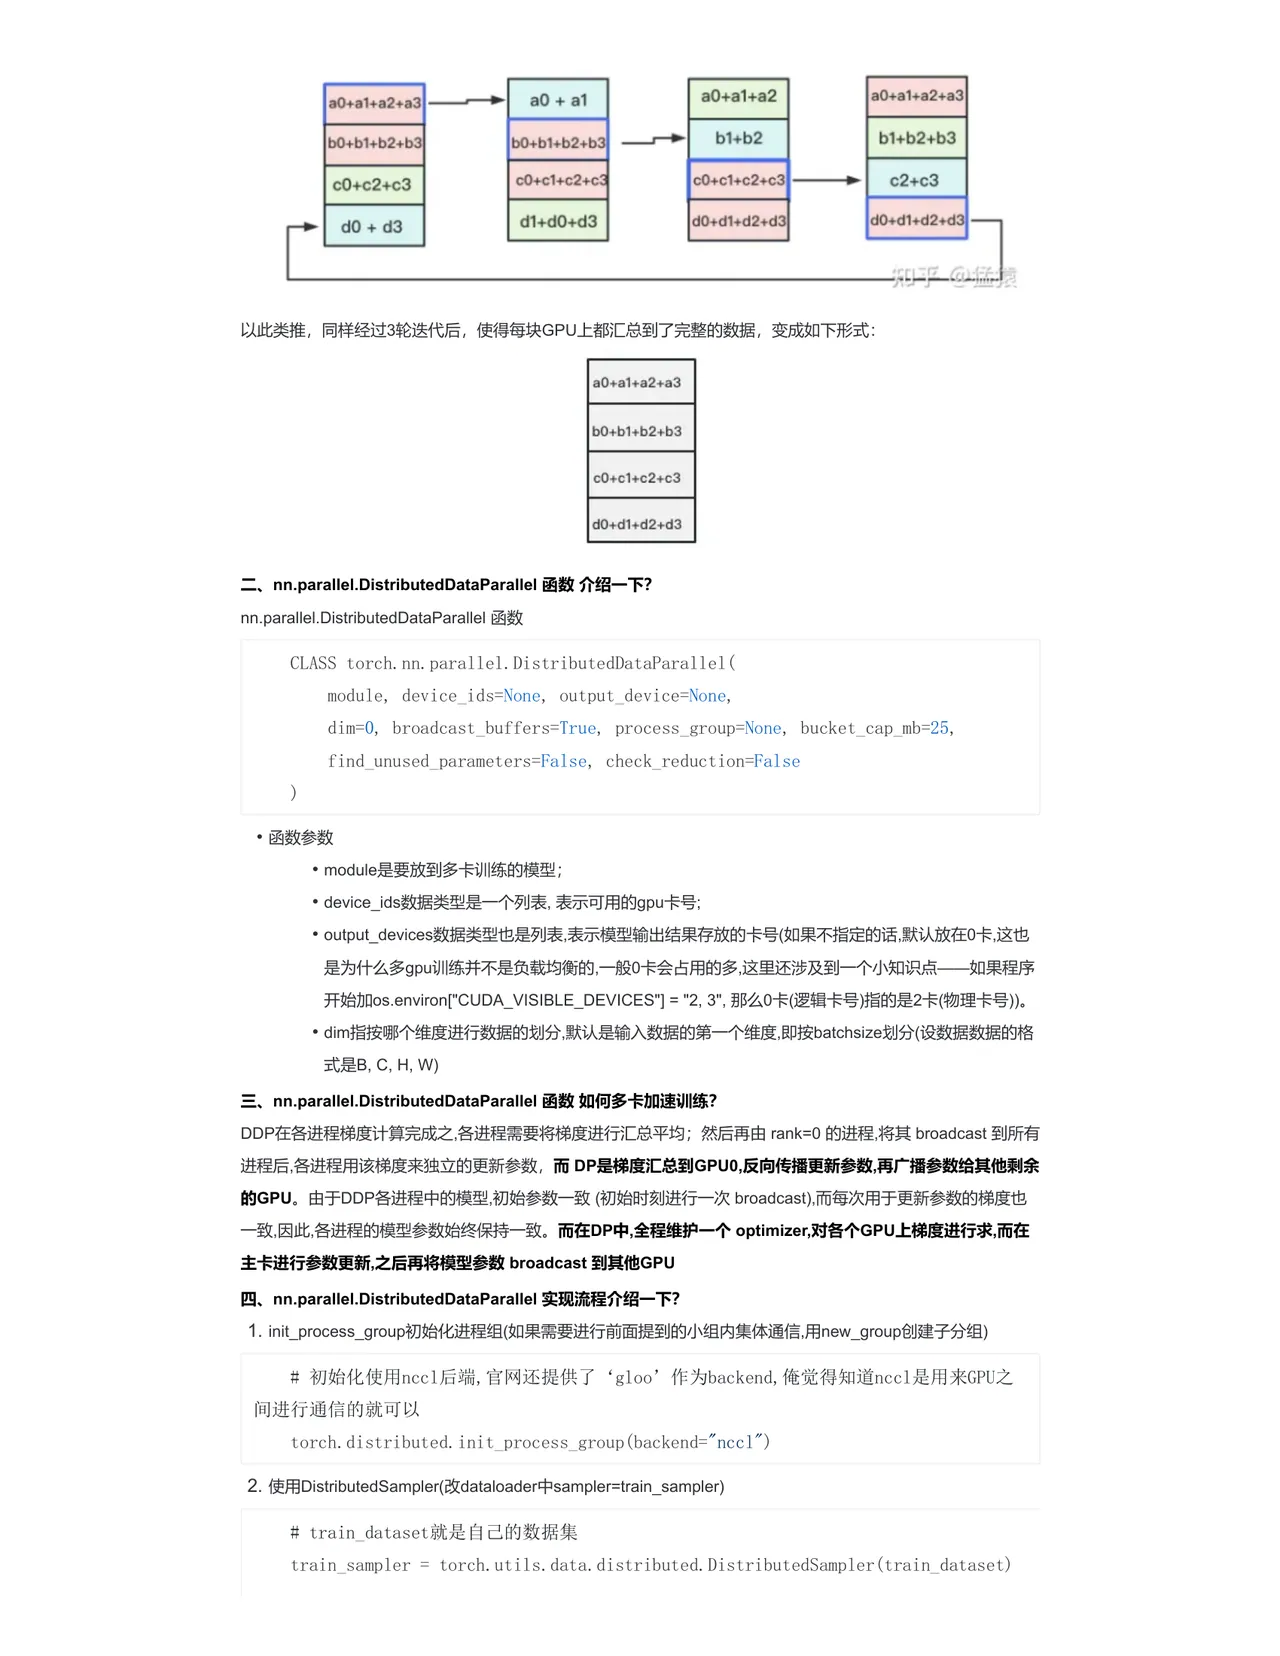
3 次更新之后,每块 GPU 上都有一块数据拥有了对应位置完整的聚合(图中红色)。此时,Reduce-Scatter 阶段 结束。进入 All-Gather 阶段。目标是把红色块的数据广播到其余 GPU 对应的位置上。 1.3 All-Gather 如名字里 Gather 所述的一样,这操作里依然按照“相邻 GPU 对应位置进行通讯”的原则,但对应位置数据不再做相 加,而是直接替换。All-Gather 以红色块作为起点。

b0+b1+b2+b3

033 / 3
第 3 页
第 3 页

以此类推,同样经过 3 轮迭代后,使…

a0+a1+a2+a3 b1+b2+b3

d0+d1+d2+d3

a0+al+a2

b1+b2

b0+b1+b2+b3 c0+C1+C2+C3

d1+d0+d3

d0+d1+d2+d3

a0+al+a2+a3 b0+b1+b2+b3

d0+d1+d2+d3

a0+a1+a2+a3 b0+b1+b2+b3

以此类推,同样经过 3 轮迭代后,使得每块 GPU 上都汇总到了完整的数据,变成如下形式:

二、nn.parallel.DistributedDataParallel 函数介绍一下? nn.parallel.DistributedDataParallel 函数 CLASS torch.nn. parallel.DistributedDataParallel ( module, device_ids=None, output_device=None, dim=0, broadcast_buffers=True, process_group=None, bucket_cap_mb=25, find_unused_parameters=False, check_reduction=False

  • module 是要放到多卡训练的模型;
  • device_ids 数据类型是一个列表,表示可用的 gpu 卡号;
  • output_devices 数据类型也是列表,表示模型输出结果存放的卡号(如果不指定的话,默认放在 0 卡,这也 是为什么多 gpu 训 l 练并不是负载均衡的,一般 0 卡会占用的多,这里还涉及到一个小知识点——如果程序 开始加 os.environ ["CUDA_VISIBLE_DEVICES"] ="2, 3",那么 0 卡(逻辑卡号)指的是 2 卡(物理卡号))。
  • dim 指按哪个维度进行数据的划分,默认是输入数据的第一个维度,即按 batchsize 划分(设数据数据的格 式是 B,C, H,W) 三,nn.parallel.DistributedDataParallel 函数如何多卡加速训练? DDP 在各进程梯度计算完成之,各进程需要将梯度进行汇总平均;然后再由 rank=0 的进程,将其 broadcast 到所有 进程后,各进程用该梯度来独立的更新参数,而 DP 是梯度汇总到 GPUO,反向传播更新参数,再广播参数给其他剩余 的 GPU。由于 DDP 各进程中的模型,初始参数一致(初始时刻进行一次 broadcast),而每次用于更新参数的梯度也 一致,因此,各进程的模型参数始终保持一致。而在 DP 中,全程维护一个 optimizer,对各个 GPU 上梯度进行求,而在 主卡进行参数更新,之后再将模型参数 broadcast 到其他 GPU 四、nn.parallel.DistributedDataParallel 实现流程介绍一下? 1. init_process_group 初始化进程组(如果需要进行前面提到的小组内集体通信,用 new_group 创建子分组) #初始化使用 ncc1 后端,官网还提供了‘gl00’作为 backend,俺觉得知道 nccl 是用来 GPU 之

间进行通信的就可以 torch.distributed.init_process_group (backend="nccl”) 2. 使用 DistributedSampler (改 dataloader 中 sampler=train_sampler) # train_dataset 就是自己的数据集 train_sampler = torch.utils.data.distributed. DistributedSampler (train_dataset)

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求