RAG 与知识库面试题图文讲义8859 字

RAG优化相关面试题

·全库 159 / 611

《RAG优化相关面试题》共 14 页、0.9 万字,通篇围绕 RAG、检索、向量、上下文 展开,归在「RAG 与知识库」这一层。

覆盖RAG检索向量上下文召回prompt

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(1 节)
  1. Prompt+②

原 PDF 已逐页还原成图,共 14 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01一、RAG 基础功能篇
  2. 025.5 如何通过查询重写和扩展提升 …
  3. 03图 2 基于 KG+VS 进行上下文…
011 / 3
第 1 页
第 1 页

一、RAG 基础功能篇

•一、RAG 基础功能篇

  • 1.1 RAG 工作流程
  • 二、RAG 各模块有哪些优化策略?
  • 三、RAG 架构优化有哪些优化策略?
  • 3.1 如何利用知识图谱(KG)进行上下文增强?
  • 3.1.1 典型 RAG 架构中,向量数据库进行上下文增强存在哪些问题?
  • 3.1.2 如何利用知识图谱(KG)进行上下文增强?
  • 3.2 Self-RAG:如何让大模型对召回结果进行筛选?
  • 3.2.1 典型 RAG 架构中,向量数据库存在哪些问题?
  • 3.2.2 Self-RAG:如何让大模型对召回结果进行筛选?
  • 3.2.3 Self-RAG 的创新点是什么?
  • 3.2.4 Self-RAG 的训练过程?
  • 3.2.5 Self-RAG 的推理过程?
  • 3.2.6 Self-RAG 的代码实战?
  • 3.3 多向量检索器多模态 RAG 篇
  • 3.3.1 如何让 RAG 支持多模态数据格式?
  • 3.3.1.1 如何让 RAG 支持半结构化 RAG (文本+表格)?
  • 3.3.1.2 如何让 RAG 支持多模态 RAG (文本+表格+图片)?
  • 3.3.1.3 如何让 RAG 支持私有化多模态 RAG (文本+表格+图片)?
  • 3.4 RAG Fusion 优化策略
  • 3.5 模块化 RAG 优化策略

•3.6 RAG 新模式优化策略

• 3.7 RAG 结合 SFT

  • 3.8 查询转换(Query Transformations)
  • 3.9 bert 在 RAG 中具体是起到了一个什么作用,我刚搜了下 nsp 的内容,但有点没法将这几者 联系起来
  • 四、RAG 索引优化有哪些优化策略?
  • 4.1 嵌入优化策略
  • 4.2 RAG 检索召回率低,一般都有哪些解决方案呀。尝试过不同大小的 chunk,和混合检索。 效果都不太好,然后优化?
  • 4.3 RAG 如何优化索引结构?
  • 4.4 如何通过混合检索提升 RAG 效果?
  • 4.5 如何通过重新排名提升 RAG 效果?
  • 五、RAG 索引数据优化有哪些优化策略?
  • 5.1 RAG 如何提升索引数据的质量?
  • 5.2 如何通过添加元数据提升 RAG 效果?
  • 5.3 如何通过输入查询与文档对齐提升 RAG 效果?
  • 5.4 如何通过提示压缩提升 RAG 效果?
022 / 3
第 2 页
第 2 页

5.5 如何通过查询重写和扩展提升 …

  • 5.5 如何通过查询重写和扩展提升 RAG 效果?
  • RAG 未来发展方向
  • Rag 的垂直优化
  • RAG 的水平扩展

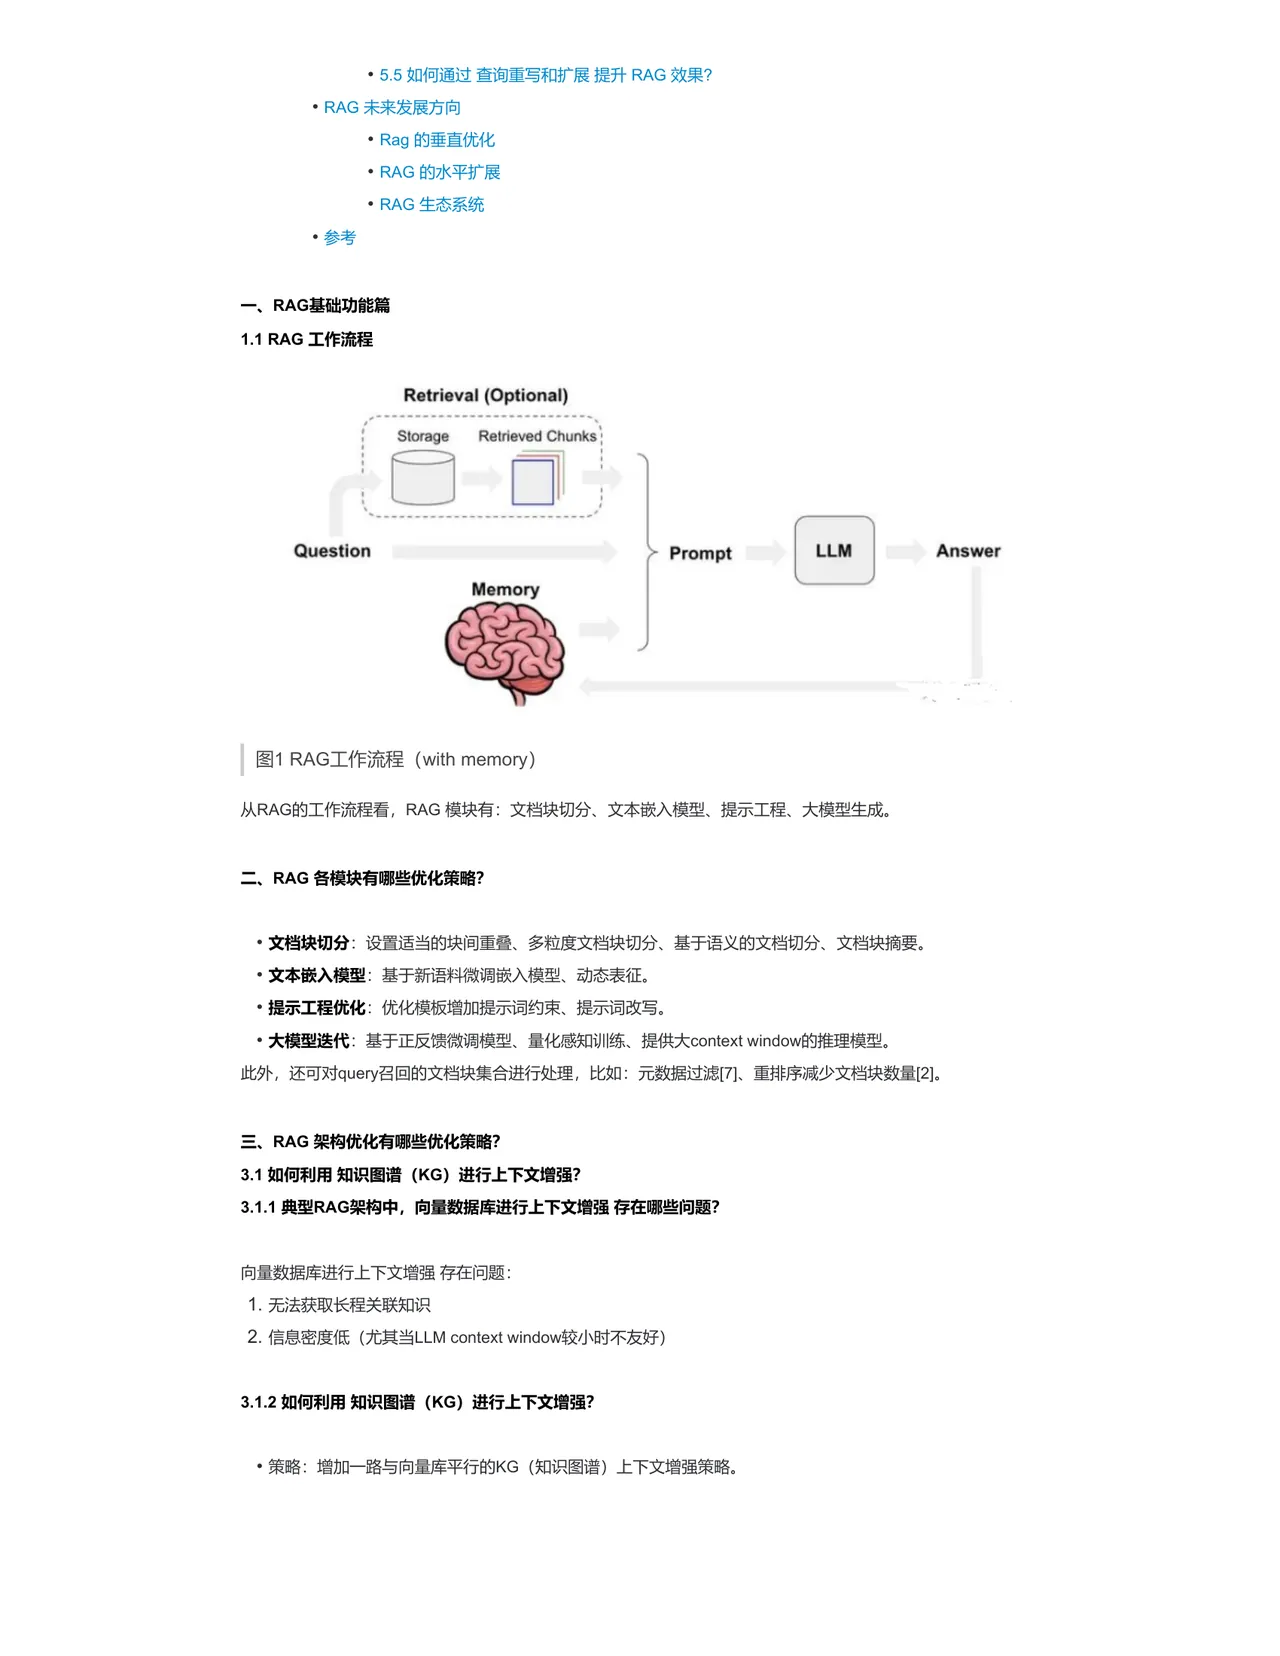
一、RAG 基础功能篇 1.1 RAG 工作流程

Retrieval (Optional) Storage

Question Memory

图 1 RAG 工作流程(with memory) 从 RAG 的工作流程看,RAG 模块有:文档块切分、文本嵌入模型、提示工程、大模型生成。

二、RAG 各模块有哪些优化策略?

  • 文档块切分:设置适当的块间重叠、多粒度文档块切分、基于语义的文档切分、文档块摘要。
  • 文本嵌入模型:基于新语料微调嵌入模型、动态表征。
  • 提示工程优化:优化模板增加提示词约束、提示词改写。
  • 大模型迭代:基于正反馈微调模型、量化感知训练、提供大 context window 的推理模型。 此外,还可对 query 召回的文档块集合进行处理,比如:元数据过滤[ 7、重排序减少文档块数量[ 2 ]。

三、RAG 架构优化有哪些优化策略? 3.1 如何利用知识图谱(KG)进行上下文增强? 3.1.1 典型 RAG 架构中,向量数据库进行上下文增强存在哪些问题?

向量数据库进行上下文增强存在问题: 1.无法获取长程关联知识 2. 信息密度低(尤其当 LLM context window 较小时不友好)

3.1.2 如何利用知识图谱(KG)进行上下文增强?

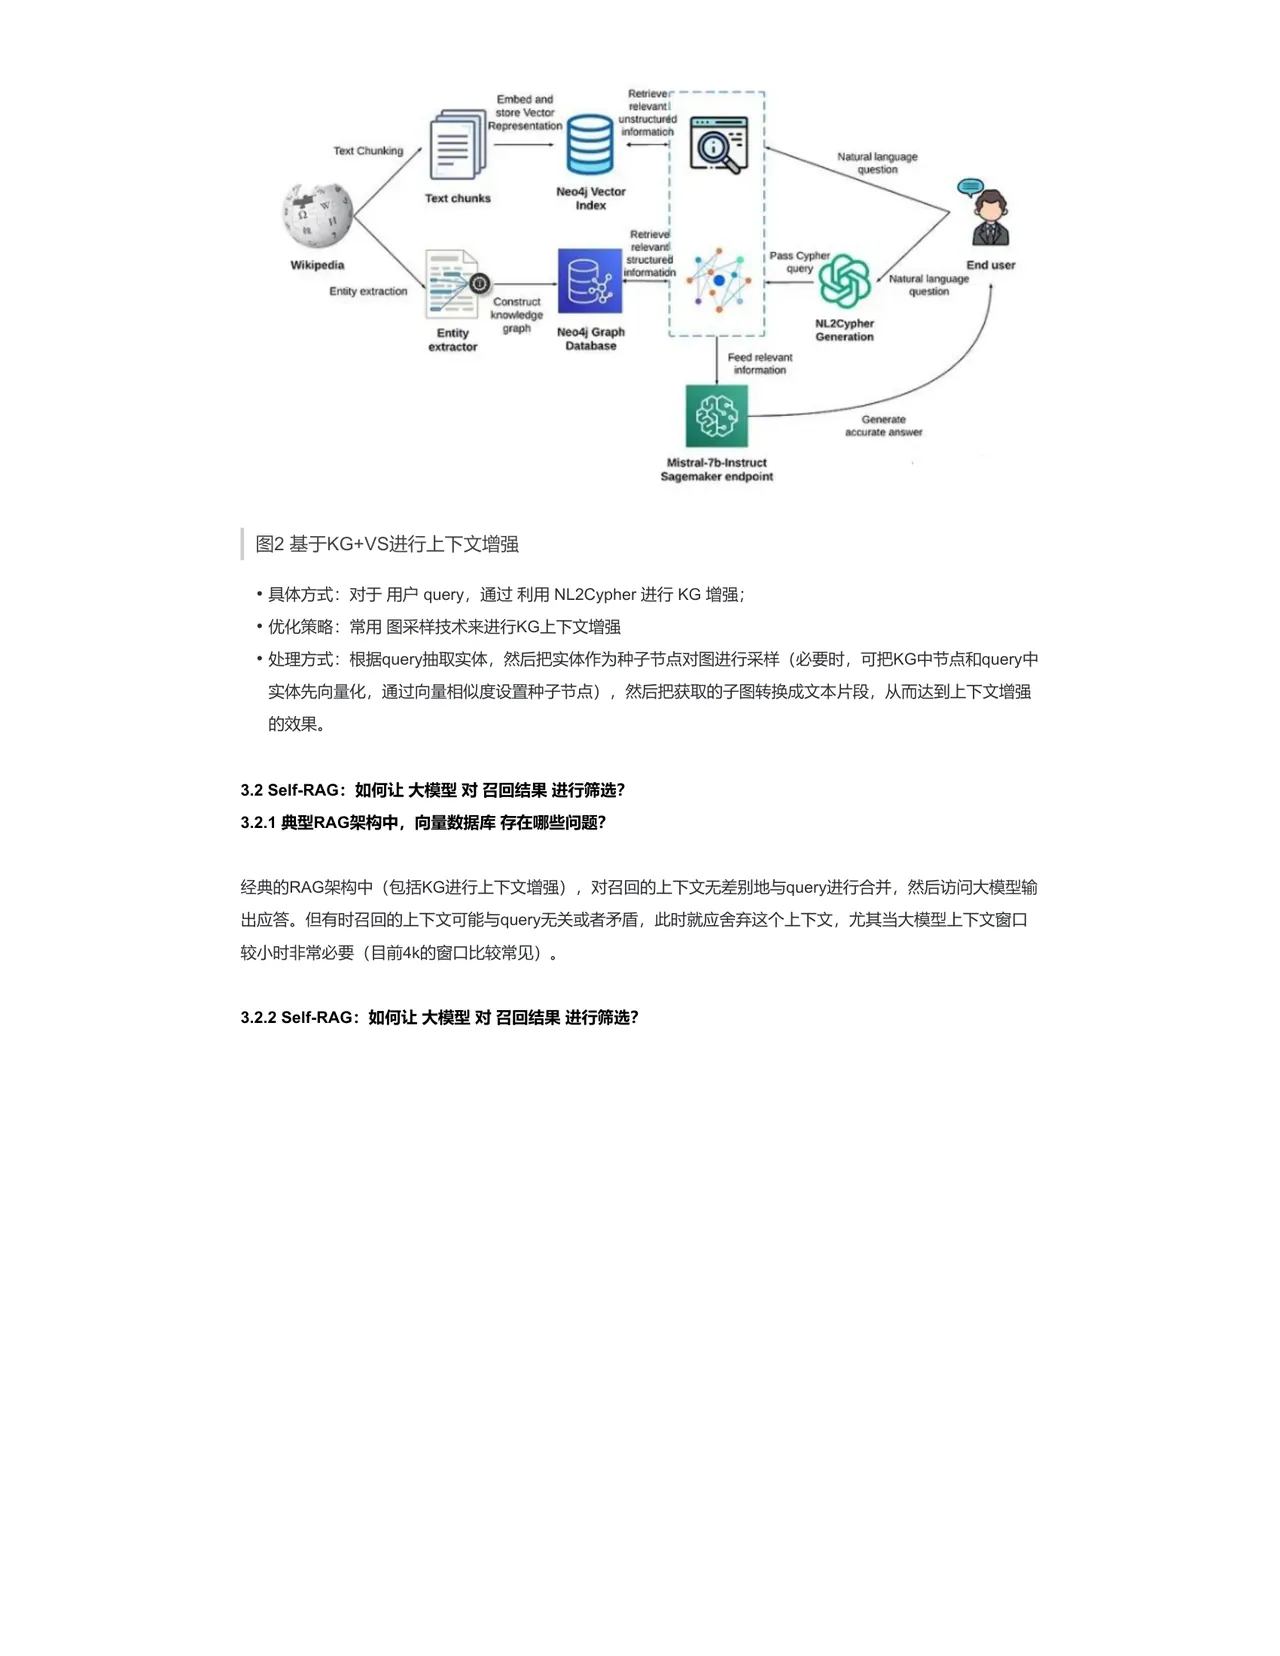
•策略:增加一路与向量库平行的 KG (知识图谱)上下文增强策略。

Answer

LLM

Prompt

033 / 3
第 3 页
第 3 页

图 2 基于 KG+VS 进行上下文…

Retriever Embed and unstructured

Ropresentation Text Chunking Natural language Neo4j Vector Text chunks Index Retrieve iPass Cypher stuctured Wikipedia intormation Natural language question Entity extraction Construct knowiedge NL2Cypher graph Entity Neo4j Graph| Generation

Database extractor Feed relevant

Generate Mistral-7b-Instruct Sagemaker endpoint

  • 图 2 基于 KG+VS 进行上下文增强
  • 具体方式:对于用户 query,通过利用 NL2Cypher 进行 KG 增强;
  • 优化策略:常用图采样技术来进行 KG 上下文增强
  • 处理方式:根据 query 抽取实体,然后把实体作为种子节点对图进行采样(必要时,可把 KG 中节点和 query 中 实体先向量化,通过向量相似度设置种子节点),然后把获取的子图转换成文本片段,从而达到上下文增强

3.2 Self-RAG:如何让大模型对召回结果进行筛选? 3.2.1 典型 RAG 架构中,向量数据库存在哪些问题?

经典的 RAG 架构中(包括 KG 进行上下文增强),对召回的上下文无差别地与 query 进行合并,然后访问大模型输 出应答。但有时召回的上下文可能与 query 无关或者矛盾,此时就应舍弃这个上下文,尤其当大模型上下文窗口 较小时非常必要(目前 4k 的窗口比较常见)。

3.2.2 Self-RAG:如何让大模型对召回结果进行筛选?

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求