
提示工程与上下文面试题2.1 万字
Prompting相关面试题
·全库 172 / 611
《Prompting相关面试题》共 2.1 万字,通篇围绕 prompt、微调、预训练、RLHF 展开,归在「提示工程与上下文」这一层。
覆盖prompt微调预训练RLHF推理对齐
适合天天在写提示词、想把输出调稳的人
目录骨架(8 节)
- 常见面试题
- 2 **开端:当我们发现一个模型做的越大越好之后……**
- 4 **定义Prompting:通往真正大一统语言模型的关键一步**
- 7 **思维链 Chain of Thoughts, CoT(2022.1)**
- 4.1 ***Prompting / Prompt Learning的定义***
- 4.3 ***Prompt的一般工作模式(最General的一款)***
- 5.1 **手动设计提示模版与自动模版学习**
- 6.1 **摘要 Abstract**
常见面试题
- Prompting、Prompt tuning、Prompt Learning
- 参数高效学习 Parameter-Efficient Transfer Learning
- 参数高效的定义
- 部分参数微调:选择法Selective Method
- 基于重参数化的方法 Reparametrization-based PEFT
- Prompting / Prompt Learning的定义
- Prompt Engineering
- 手动设计提示模版与自动模版学习
- 参数化Prompt/自动 Prompt
- 离散提示/硬提示 Discrete Prompt a.k.a Hard Prompt
- 连续提示/软提示 Continuous Prompt a.k.a Soft Prompt
- 软提示真就一定比硬提示好吗?
- 摘要 Abstract
- 基于人类反馈的强化学习
- 模型的效果与评价
- 所以指令微调都做了些什么?
- 思维链 Chain of Thoughts, CoT
- 大语言模型的涌现 Emergent Abilities
- 什么是大语言模型的涌现?
- 涌现是敏锐且不可预测的
- 对涌现的批评
预训练语言模型的新范式:Prompting!
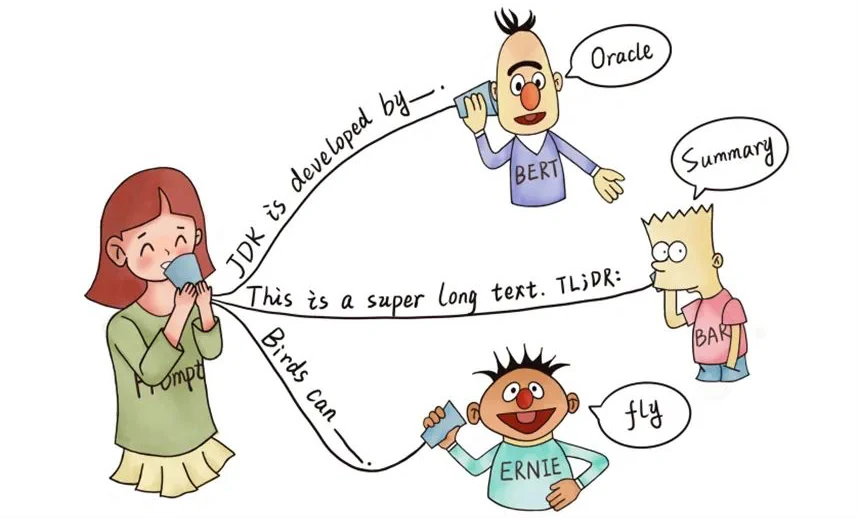
参考12.3,GPT-3提出了一个重要的概念—上下文学习(in-context learning, ICL)。
| ICL其实就是Prompting的祖师爷,其一举把预语言模型实现下游任务应用的范式从Fine-Tuning时代引入到了Prompting时代。紧接着,面向超大预训练语言模型,Prompting出现了三个主要范式:上下文学习ICL,指令精调Instruction-tuning和思维链CoT。 |
|---|
| Now, as of this writing in 2021, we are in the middle of a second sea change, in which the “pre-train, fine-tune” procedure is replaced by one in which we dub “pre-train, prompt, and predict”. In this paradigm, instead of adapting pre-trained LMs to downstream tasks via objective engineering, downstream tasks are reformulated to look more like those solved during the original LM training with the help of a textual prompt. ——Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing |
|---|
| 模型 | 论文 | 模型参数 | 范式与创新点 | 评价与意义 |
|---|---|---|---|---|
| GPT-3 #仅提及,已在12.3讲完 2020.5 | Language Models are Few-Shot Learners | 1750亿参数 | 预训练+Prompt+Predict,创新点在于in-context learning | 开创性提出in-context learning概念,是Prompting真正的祖师爷。 In-context learning(ICL)是第一类适用于大模型的Prompting范式。 |
| InstructGPT 2022.3 | Training language models to follow instructions with human feedback | 13亿参数 | 预训练+SFT+RLHF,本质还是Fine-tune。RLHF应被理解为把生成式任务变成判别式任务的降低标注成本的Fine-tune。 | Instruction-tuning是第二类适用于大模型的Prompting范式。利用SFT+RLHF实现人类价值观的对齐时,可能教会了模型如何去遵循指示。 |
| PaLM 2022.4 | PaLM: Scaling Language Modeling with Pathways | 5400亿参数 | 验证了使用思维链提示能够显著提升模型在算数、常识推理(基于对世界的知识,例如“奶酪放在冰箱里会不会融化”)等挑战性的下游任务的性能 | PaLM的直接目的在于证明继续把参数做大,模型的性能还是可以进一步提升。思维链提示(CoT)是第三类面向大模型的Prompting范式。 |