
入门与全局认知面试题5553 字
自然语言处理与LLM面试题
·全库 173 / 611
《自然语言处理与LLM面试题》共 0.6 万字,通篇围绕 向量、embedding、语料、上下文 展开,归在「入门与全局认知」这一层。
覆盖向量embedding语料上下文Transformer预训练
适合刚接手 AI 项目、需要先把全局图景拼起来的人
目录骨架(8 节)
- 常见面试题
- 1 **为什么机器这么难理解人类语言?**
- 2 **NLP的基本任务**
- 3 **语言模型 Language Model 定义**
- 4 **词嵌入 Word Embedding**
- 5 **基于统计方法的语言生成:N-gram模型**
- 6 **基于前馈神经网络优化n-gram模型**
- 7 **基于循环神经网络的语言模型**
目录 · 3 节
常见面试题
- 为什么机器这么难理解人类语言?
- NLP的基本任务
- 语言模型 Language Model 定义
- 词嵌入 Word Embedding
- 基于统计方法的语言生成:N-gram模型
- 基于前馈神经网络优化n-gram模型
- 基于循环神经网络的语言模型
1 为什么机器这么难理解人类语言?
可以去回想之前我们提到过的语义鸿沟的概念。
人类自然语言的多样性、灵活性、歧义性、上下文依赖性、语言的变化以及世界知识和常识的应用等因素都使得让机器难以理解人的自然语言:
- 多样性和灵活性:包括语法、词汇、语义、上下文等方面。同一个词汇在不同语境中可能有不同的含义,例如“他被杀死了”的“死”和“笑死我了”的死完全是两个含义。人们还经常使用讽刺、隐喻、比喻、口语和俚语等非字面意义的表达方式,比如“潘帕斯雄鹰真是这场盛典中的一匹黑马”,潘帕斯雄鹰指的是阿根廷队而不是一个动物,盛典指的是世界杯,黑马是比喻阿根廷队取得了超乎我们预期的表现。人是可以理解这些语言的,但机器想理解这些就非常困难。
- 语言的歧义性:自然语言中存在丰富的歧义现象,包括词义歧义、语法歧义、指代歧义等。例如,英语中的词汇"bank"可以表示银行,也可以表示河岸,其含义取决于上下文,这是词语歧义;The animal didn't cross the street because it was too tired,对于机器来说,这里的it可以指代animal,也可以指代street。这是一种指代歧义。这种歧义性对于机器来说是一个挑战,因为需要具有推理和语境理解能力才能够正确解析歧义。
- 上下文依赖性:人类自然语言中的表达通常依赖于上下文信息。例如,尽管大多数时候terribly的意思是负面的,但The movie is terribly exciting中,terribly的意义就是积极的。
- 世界知识和常识:人类在语言交流中经常依赖于世界知识和常识,即我们对世界的认知和经验。当我们说"我要花30元去伦敦看电影"时,我们知道电影是什么,知道伦敦是个地名,知道30是个数字而元是货币单位。这种世界知识和常识对于理解自然语言是至关重要的,但对于机器来说,获取和应用这些知识是一项复杂的任务。
2 NLP的基本任务
2.1 文本分类 Text Classification
将文本分为不同的预定义类别,例如情感分类(积极情感还是消极情感,是否具有攻击性和恶意)、主题分类、垃圾邮件分类等。
2.2 命名实体识别 Named Entity Recognition, NER
命名实体识别(Named Entity Recognition, NER)是自然语言处理(NLP)中的一种任务,旨在识别文本中具有特定命名实体的片段,如人名、地名、组织名、时间、日期、货币、数量等。(陈先生和陈醋和陈仓里的陈是不一样的,我们希望机器能知道陈先生是人名,陈醋是个物品,陈仓是个地名,这样模型去做自然语言任务的性能才会提高)NER是许多NLP应用中的重要预处理步骤。
NER通常可以分为以下几种类型:
- 人名(Person):识别文本中的人物名称,如"John Smith"、"张三"等。
- 地名(Location):识别文本中的地理位置名称,如"New York"、"北京市"等。
- 组织名(Organization):识别文本中的组织、公司、机构名称,如"Microsoft"、"中国科学院"等。
- 时间(Time):识别文本中的时间信息,包括日期、时间、季节等,如"2021年10月1日"、"下午3点"等。
- 日期(Date):识别文本中的日期信息,如"2021-10-01"、"10/01/2021"等。
- 货币(Currency):识别文本中的货币信息,如"100美元"、"500元人民币"等。
- 数量(Quantity):识别文本中的数量信息,如"3个苹果"、"10米长"等。
NER任务通常采用监督学习方法,其中标注了已知命名实体类型的大规模标注数据用于训练模型。
2.3 句法分析 Dependency Parsing
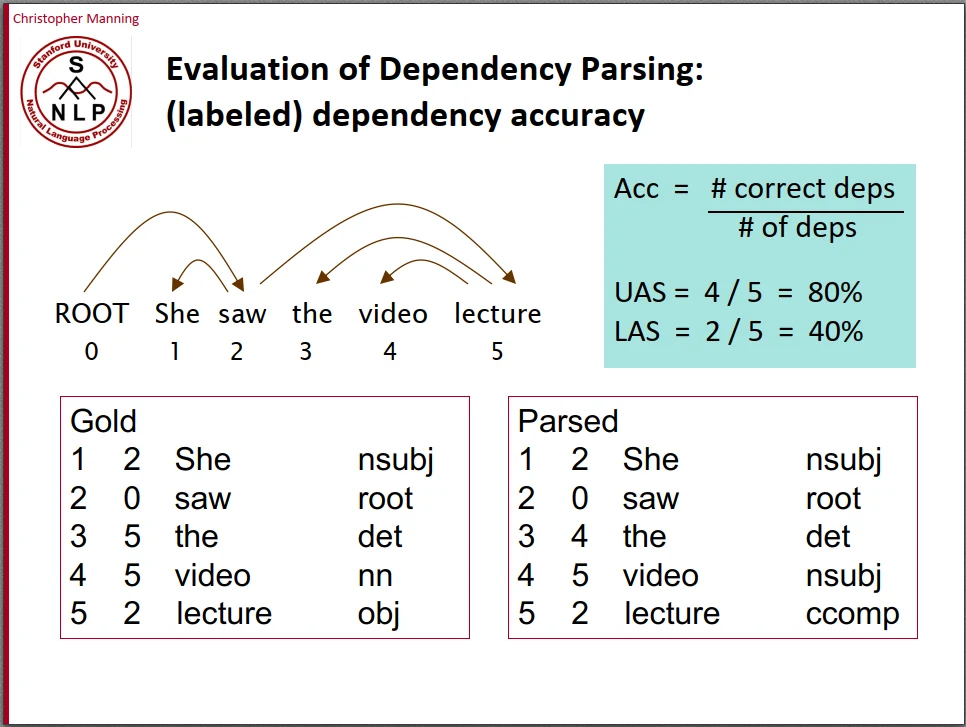
Dependency Parsing是指对句子进行语法分析并画出句子成分的依赖关系,比如对于句子“She saw the video lecture”,首先可以分析出主语、谓语、宾语等句子成分;其次可以分析出依赖关系,比如saw依赖于She等。这就是句法分析。
2.4 语言生成 Language Generation
- 语言生成(Language Generation)是自然语言处理(NLP)领域中的一种任务,指的是使用计算机生成自然语言文本的过程。
- 语言生成可以应用于多种应用场景,如机器翻译、文本摘要、对话系统、自动生成文章、生成代码、音乐和艺术创作等。