
seq2seq与Attention面试题
《seq2seq与Attention面试题》共 0.5 万字,通篇围绕 Attention、向量、语料、架构 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 常见面试题
- 1 **seq2seq结构:以其在NMT中的应用为例**
- 2 **详解Decoder:他就是个语言模型!**
- 3 **注意力机制 Attention**
- 4 **拓展问题**
- 2.1 **为什么训练和预测时的Decoder不一样?**
- 2.2 **计划采样 Scheduled Sampling**
- 2.3 **贪心算法 VS Beam Search**
常见面试题
- seq2seq结构:以其在NMT中的应用为例
- 为什么训练和预测时的Decoder不一样?
- 计划采样 Scheduled Sampling
- 贪心算法 VS Beam Search
- 注意力机制 Attention
- 朴素seq2seq的信息瓶颈
- Attention机制的直观理解
- Attention机制的数学表达
- 向量的点积操作
- Attention机制的步骤
- Attention机制带来的好处
- NMT确实牛,但还有一些问题
- Attention开始变为深度学习的一种通用技术
- Attention机制中点积操作的矩阵
细讲seq2seq对了解大语言模型有重大的意义:它启发了序列自编码器,这对于后来出现的NLP的自监督学习很有意义。而且Encoder-Decoder的架构也在Transformer里出现。
#Attention在一开始是一个对基于RNN的seq2seq模型的改进技巧。当然,后面出现了放弃了RNN,只保留了Attention的剧情,大家应该都提前知道了。
1 seq2seq结构:以其在NMT中的应用为例
seq2seq是一个很强大的模型,不但可以用来做机器翻译,还可以用来做很多NLP任务,比如自动摘要、对话系统等。不过它最早是用来做机器翻译的,而且翻译确实是一个很经典的场景,所以这里我们先拿翻译举例。
神经机器翻译(NMT)用了seq2seq的结构,它的另一个常见的名字是编码-解码器(Encoder-Decoder)结构。
叫seq2seq的原因,在于其输入和输出都是一个词序列。那就是sequence to sequence,即seq2seq。<所以正确读音是 /si:k-tu:-si:k/噢!不要读错了>
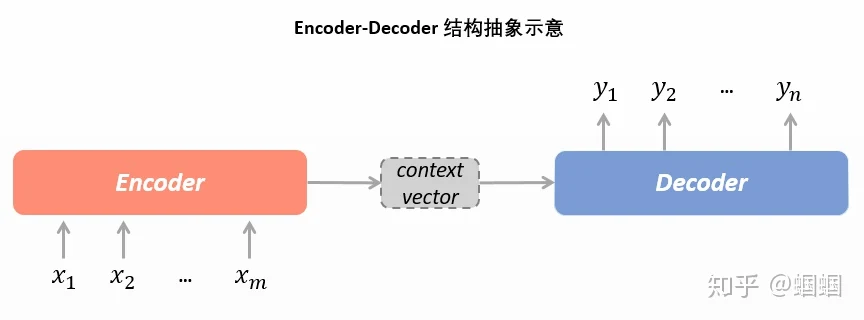
- 编码器Encoder:读取输入文本,将输入的文本(词序列)整体编码成一个表示向量,而后交给Decoder进行解码。在编码器中,输入的词会变成一个one-hot向量,而后经过Embedding层投射到一个(512维的)向量空间,随后输入到RNN的结构里面去(这个RNN一般是LSTM,而且可以是双向等结构,而且可以有很多层,即把神经网络搞的很深,从而可以去提取更高级的特征)。
- Context Vector:经过了编码器中的RNN的一系列计算,输出来的对源文本整体的一个表示向量。
- 解码器Decoder:接受编码器编码出的输入(以及标准答案的词序列),自行生成文字。在NMT中,Decoder的输出是预测出的词的序列,但输入在训练和预测时有所不同。
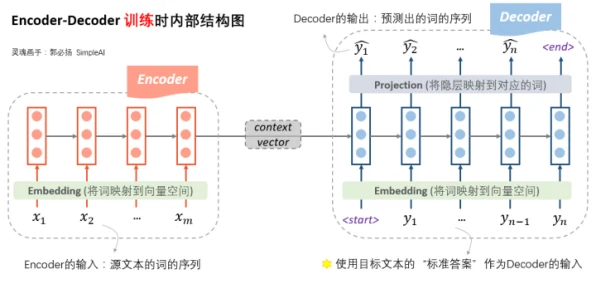 #EncoderRNN负责对源语言进行编码,学习源语言的隐含特征。Encoder RNN的最后一个神经元的隐状态作为Decoder RNN的初始隐状态。 | 训练时:接受编码器给出的表示向量和“标准答案”作为输入。参考左图,根据第一个输入<start>符号和编码器送来的表示向量,先生成了预测结果。而后,根据第二个输入符号(而不是前一步的预测结果),我们生成预测结果. 很好理解,那么损失函数就是前一步最终生成的整个词表的概率分布与标准答案对应的one-hot向量的交叉熵函数,我们基于这个损失函数对RNN网络做梯度下降,从而让模型预测的越来越准。 |
|---|
| 预测时:自产自销,每一步预测的结果,都送给下一步作为输入。这样的输出方法我们称为自回归(Auto-regressive)。参考下图,根据第一个输入<start>符号和编码器送来的表示向量,先生成了预测结果。而后,根据前一步的输出(而不是标准答案),我们生成预测结果.后面我们会知道,GPT就是一个自回归的文本生成模型。自回归形式天然适合Generative的 场景,这不难理解,就像是我们写文章是从左往右边写边想的一样。 | 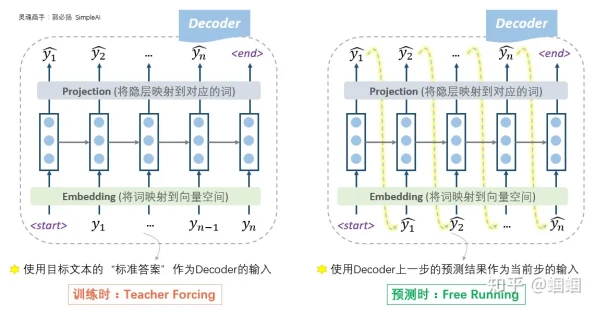 #Decoder的初始隐状态是基于Encoder RNN的输出,所以我们把Decoder称为一个条件语言模型。 |
|---|
2 详解Decoder:他就是个语言模型!
2.1 为什么训练和预测时的Decoder不一样?
Decoder在训练时是根据标准答案做输出,而预测时则是在自产自销。为什么要做这种区分呢?
这里其实涉及到两种不同的Decode方式:
- 根据标准答案来Decode的方式,我们称为Teacher Forcing。
- 根据上一步的输出作为下一步输入的Decode方式,Free Running。
“其实,free running的模式真的不能在训练时使用吗?——当然是可以的!从理论上没有任何的问题,又不是不能跑。但是,在实践中人们发现,这样训练太南了。因为没有任何的引导,一开始会完全是瞎预测,正所谓“一步错,步步错”,而且越错越离谱,这样会导致训练时的累积损失太大(「误差爆炸」问题,exposure bias),训练起来就很费劲。这个时候,如果我们能够在每一步的预测时,让老师来指导一下,即提示一下上一个词的正确答案,decoder就可以快速步入正轨,训练过程也可以更快收敛。因此大家把这种方法称为teacher forcing。所以,这种操作的目的就是为了使得训练过程更容易。”By 知乎用户蝈蝈