
RAG 与知识库1377 字
如何构建领域专属的知识图谱
·全库 239 / 611
《如何构建领域专属的知识图谱》共 0.1 万字,通篇围绕 金融、场景、数据库、推理 展开,归在「RAG 与知识库」这一层。
覆盖金融场景数据库推理需求医疗
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(4 节)
- 一、答题思路
- 二、项目案例
- 三、参考回答
- 四、总结归纳
一、答题思路
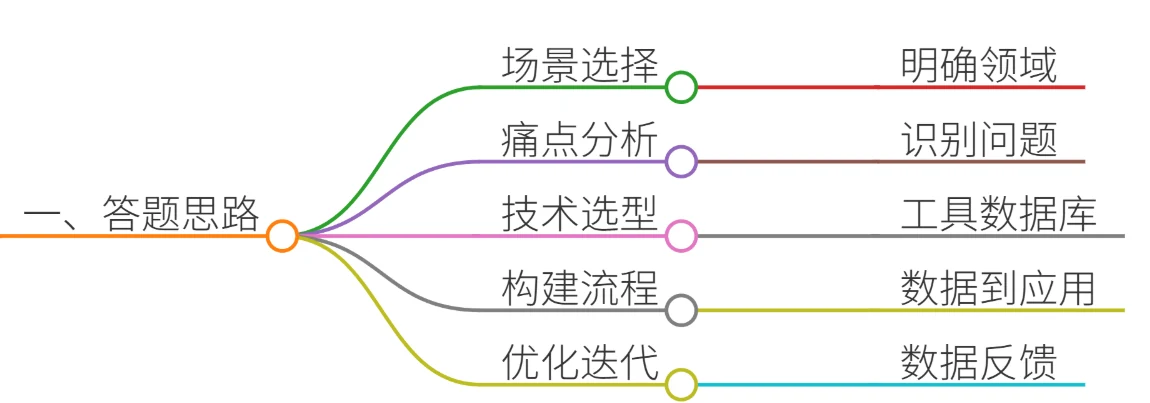
构建领域专属知识图谱需结合具体业务场景,通过系统性流程实现从数据整合到知识应用的闭环。以下为分步解题框架:
- 场景选择:明确领域需求(如金融风控、医疗诊断、智能制造)
- 痛点分析:识别行业数据孤岛、语义异构、知识更新滞后等问题
- 技术选型:根据数据类型选择NLP工具(BERT/ERNIE)、图数据库(Neo4j/JanusGraph)
- 构建流程:数据采集→实体识别→关系抽取→图谱构建→知识融合→应用部署
- 优化迭代:通过持续注入新数据和反馈优化图谱质量
二、项目案例
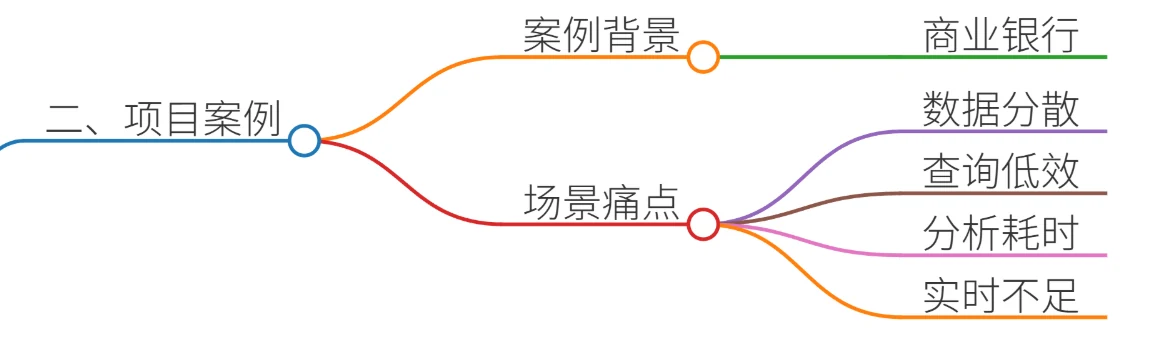
案例背景:某商业银行构建企业风险知识图谱
场景:金融风控场景下,需整合企业工商信息、司法诉讼、舆情动态等多源数据,识别集团客户隐性关联风险。
痛点:
- 数据分散在工商、司法、税务等10+个系统,格式不统一
- 传统关系型数据库无法高效处理复杂关联查询(如股权穿透)
- 人工分析企业关联风险耗时长达3-5天/户
- 监管要求穿透式风险排查,现有系统无法满足实时性需求
三、参考回答
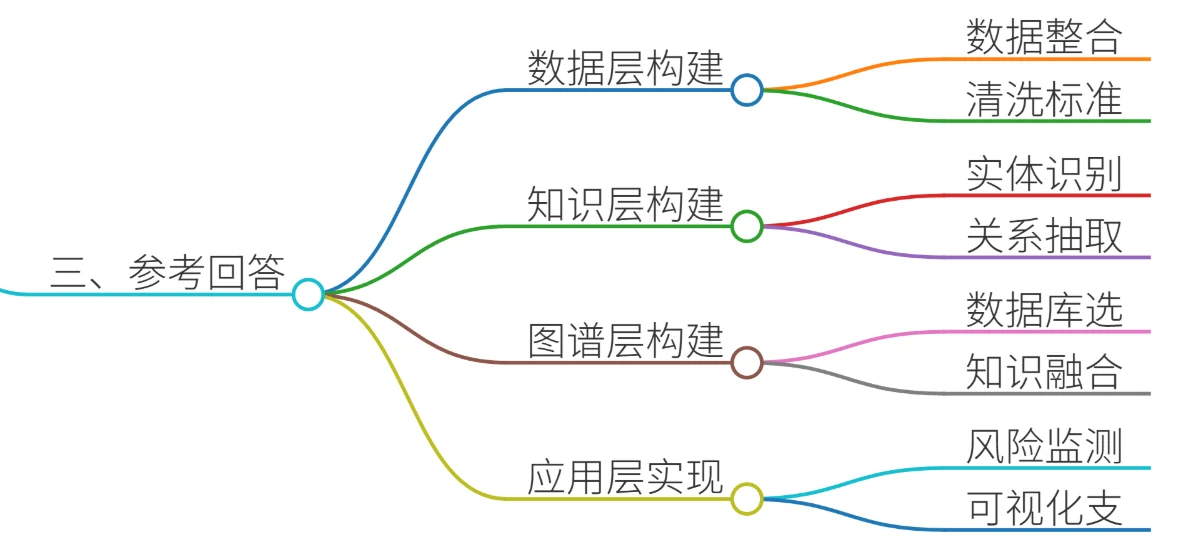
(一)数据层构建:打通多源异构数据
- 数据源整合
- 结构化数据:对接工商总局企业注册信息(1.2亿条)、中国裁判文书网司法判决(5000万+案例)
- 半结构化数据:爬取企业年报(PDF/Word)、招股说明书(XML格式)
- 非结构化数据:采集新闻舆情(新浪财经、东方财富网)
# 示例:使用Scrapy框架爬取企业年报关键字段
class AnnualReportSpider(scrapy.Spider):
    name = "annual_report"
    start_urls = [" http://www.example.com/reports "]

    def parse(self, response):
        item = {
            'company_name': response.css('.company-name::text').get(),
            'revenue': response.xpath('//div[@class="finance"]/span/text()').get()
        }
yield item- 数据清洗与标准化
- 实体消歧:通过BERT模型区分同名实体(如"北京小米科技" vs "小米科技有限责任公司")
- 时序对齐:将季度营收数据统一映射到财政年度
# 示例:使用Dedupe库进行实体去重
import dedupe
fields = [{'field': 'name', 'type': 'String'}, {'field': 'address', 'type': 'String'}]
deduper = dedupe.Dedupe(fields)
deduper.sample(data_d, 15000)
(二)知识层构建:抽取核心要素
- 实体识别(NER)
- 基于FinBERT模型识别金融实体:
from transformers import BertTokenizer, BertForTokenClassification
model = BertForTokenClassification.from_pretrained('bert-base-chinese')
tokenizer = BertTokenizer.from_pretrained('bert-base-chinese')

def extract_entities(text):
    inputs = tokenizer(text, return_tensors="pt")
    outputs = model(**inputs)
    predictions = torch.argmax(outputs.logits, dim=2)
return [(tokenizer.decode(ids), labels[i].item()) for i, ids in enumerate(inputs.input_ids)]- 关系抽取(RE)
- 使用图神经网络(GNN)抽取控股关系:
# 示例:基于PyTorch Geometric实现关系抽取
import torch
from torch_geometric.nn import GATConv

class RelationExtractor(torch.nn.Module):
    def __init__(self, num_node_features, hidden_channels, num_classes):
        super().__init__()
        self.conv1 = GATConv(num_node_features, hidden_channels, heads=8)
        self.conv2 = GATConv(hidden_channels * 8, num_classes, heads=1)

    def forward(self, x, edge_index):
        x = F.dropout(x, p=0.6, training=self.training)
        x = F.elu(self.conv1(x, edge_index))
        x = F.dropout(x, p=0.6, training=self.training)
        x = self.conv2(x, edge_index)
        return x