
基于FSDP实现完全分片数据并行训练
《基于FSDP实现完全分片数据并行训练》共 0.6 万字,通篇围绕 Transformer、推理、微调、CUDA 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(8 节)
- 示例代码
- 前置知识
- 完全分片数据并行 FSDP
- FSDP 简单实现
- 环境准备
- 微调训练
- 模型合并
- 模型推理
示例代码
前置知识
在介绍针对权重数据、优化器数据和梯度数据进行分布式数据并行的算法 FSDP 前,需要一些前置知识,如何执行混精度训练和对显存消耗进行估算,以帮助更好地理解完全分片数据并行算法 FSDP。
精度格式
在深度学习中,常用的精度格式包括 FP32、FP16、BF16 和 TF32。
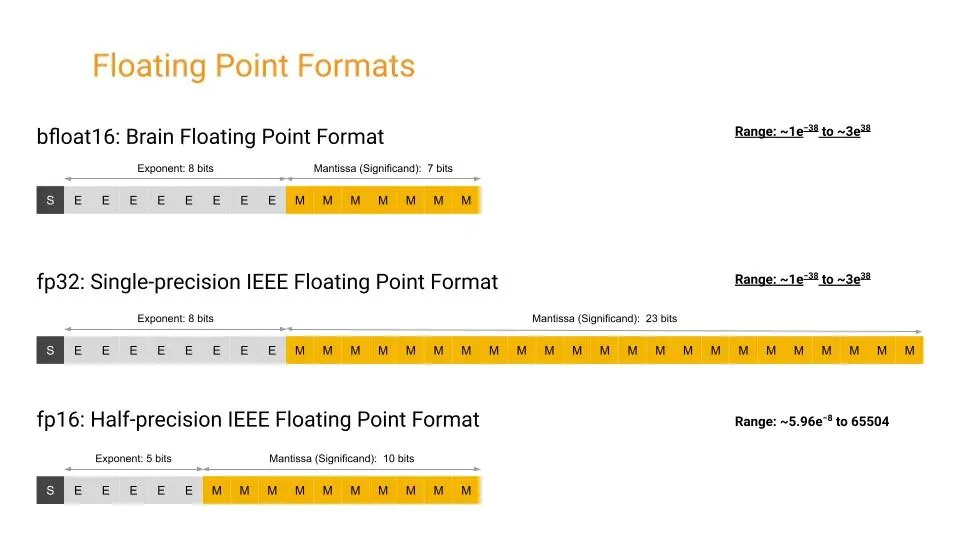
- FP16:同样是 IEEE 754 标准下的半精度浮点格式。随着深度学习的发展,FP16 逐渐取代了 FP32 的地位。因为相较于 FP32,更低的精度并不会对神经网络的性能产生重大影响。额外的精度不会带来任何好处,反而会更慢、占用更多内存并降低通信速度。FP16 通常用于混合精度训练(MindSpore/PyTorch)。也用于训练后量化,以加快推理速度。其他用于量化的格式还有整数 INT8(8 位整数)、INT4(4 位)甚至 INT1(二进制值)。
- BF16:谷歌最初开发的另一种 16 位格式被称为 "Brain Floating Point Format",简称 "bfloat16"。这个名字源于 "谷歌大脑"(谷歌 Brain),谷歌大脑是谷歌的一个 AI 研究小组,这种格式就是在这个小组构思出来的。最开始是被使用在谷歌芯片 TPU 中,后被广泛使用在 GPU、NPU 等 AI 芯片中。由于具有更多的指数位,常被用于处理 FP16 的溢出问题。
- FP32:这种格式在很长一段时间内都是深度学习的主力,它是 IEEE 754 标准下的单精度浮点数。长期以来,它一直是神经网络计算的标准类型。长期以来,神经网络中的权重、激活和其他值都默认用 FP32 表示。
- TF32:这是一种十分特殊的格式(无需显示设置,而是自动执行),它将 FP32 数据截断为 TF32 进行计算,然后再转换回 FP32。这一创新的最大优势在于编译器只需在 AI 编译层提供支持。其他代码部分则可以继续使用动态范围相同但精度较高的 FP32,无需进行修改。TF32 的快速插入性使得利用 AI 计算加速核心的速度成为可能,而无需过多修改现有代码。
TF32 采用与 FP16 相同的 10 位尾数,这满足了 AI 工作负载的精度要求,并且使用了与 FP32 相同的 8 位指数,因此具有相同的数值范围。从技术上讲,它可以视为一种 19 位格式,也可以视为扩展精度的 BF16。
TF32 的优势在于其格式与 FP32 相同。当使用 TF32 进行计算时,输入 FP32 操作数的尾数从 23 位舍入到 10 位,然后进行精确乘法运算,最后以正常的 FP32 格式进行累加。相比之下,FP16 和 BF16 等格式需要更多工作,因为它们涉及不同的位布局。尽管如此,也值得使用这些不同搞得精度格式,因为它们可以减少内存带宽、存储和计算位数,从而提升执行速度。
torch.backends.npu.matmul.allow_tf32 = True
torch.backends.npu.matmul.allow_16 = True
混精训练
在当今大模型训练的背景下,混合精度训练已然成为一种备受推崇的普遍做法。通过采用混合精度训练,能够将训练速度显著提升数倍,而又不会对模型的整体性能产生重大影响。在数据科学领域,精度一直是评判的重要考量因素——在传统的科学计算领域,人们通常追求较高的精度,如 FP128 或 FP64 等。
然而,在深度学习中,所面临的实际上是一个高维函数拟合(或近似)的优化问题,因此并不需要过于精确的数值表示,且使用低精度将会带来显著的计算速度提升。
在深度学习中,使用 FP16 训练有时会出现下溢出的问题:FP16 的有效的动态范围约为 {5.96e}^{-8} \sim 65504 ,在训练后期,例如激活函数的梯度会非常小,甚至在梯度乘以学习率后,值会更加小。由于 FP16 的精度范围有限,过小的梯度可能导致更新无效,这个时候就需要使用混精度训练。
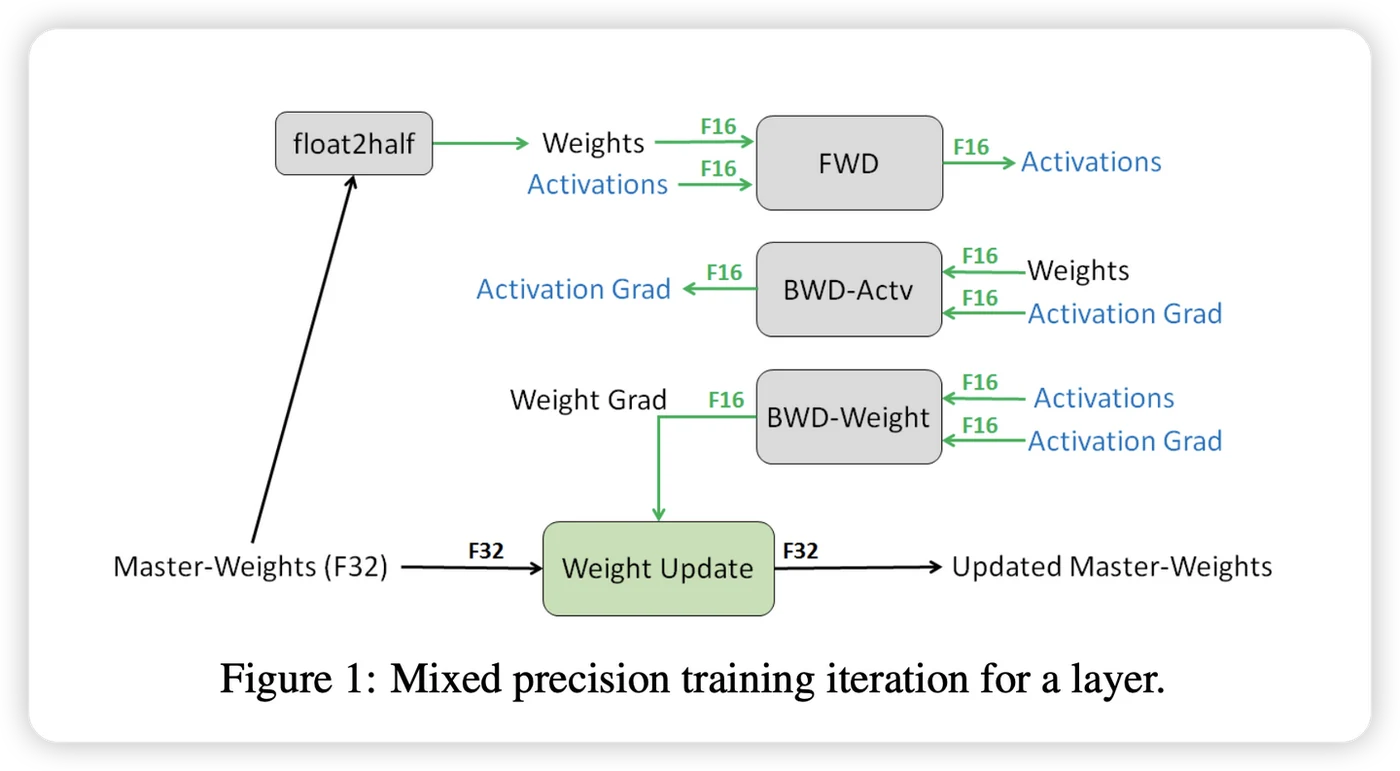
混精度训练可以分为两个部分:半精度 和 权重备份,如图所示,这里使用 FP16 和 FP32 来举例。在训练开始时,准备两套模型状态,其中一套为 FP32 类型(优化器状态和模型参数),另一套为 FP16 类型(模型参数),在前向传播、反向传播时,都使用 FP16 类型的模型参数进行计算;而在参数更新时,将梯度成与学习率 \eta 相乘,更新到 FP32 类型的模型状态上,在新一轮的训练中,再次将 FP32 类型的模型拷贝为 FP16 类型的模型。这个过程就是混精度训练。
image
由于在计算密集的前向传播、反向传播中,使用了 FP16 进行计算,与单精度相比,训练的速度会大幅度提升。另外,由于激活值在训练过程中占用内存的很大部分,使用 FP16 储存激活值在大批量训练时也会节省内存。同时,在分布式环境下使用 FP16 梯度通信量也会降低。