
训练、微调与数据2019 字
基于DeepSpeed加速大模型训练
·全库 303 / 611
《基于DeepSpeed加速大模型训练》共 0.2 万字,通篇围绕 微调、推理、LoRA、GPU 展开,归在「训练、微调与数据」这一层。
覆盖微调推理LoRAGPUSFT显存
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(8 节)
- 分布式背景介绍
- deepspeed 介绍
- 环境准备
- Merge LoRA
- 推理(微调后模型)
- 使用CLI
- deepspeed Zero2微调
- deepspeed分布式微调
示例代码
DeepSpeed 介绍
分布式背景介绍
- 分布式计算环境中,主节点负责协调其他节点和进程的工作
- pytorch 官方提供的分布式训练工具 Accelerate 只支持 nvlink,而 T4,3090 这类显卡是 PIX ,检测方式:nvidia-smi topo -m;deepspeed 支持更大规模的模型训练
- 混合精度训练
- ZeRO 可以减少内存占用,优化大模型训练,将模型参数分成了三个部分:Optimizer States、Gradient 和 Model Parameter。在使用 ZeRO 进行分布式训练时,可以选择 ZeRO-Offload 和 ZeRO-Stage3 等不同的优化技术。
deepspeed 介绍
DeepSpeed 是一个为速度和规模而设计的库,用于大规模模型的分布式训练,模型参数可达数十亿。其核心是零冗余优化器 (ZeRO),它跨数据并行进程分片优化器状态 (ZeRO-1)、梯度 (ZeRO-2) 和参数 (ZeRO-3)。这大大减少了内存使用量,使您可以将训练扩展到数十亿参数的模型。为了释放更高的内存效率,ZeRO-Offload 通过在优化期间利用 CPU 资源来减少 GPU
- 在 DeepSpeed 中,可以通过在配置文件中设置 “bf16.enabled”: true 来启用 BF16 混合精度训练,减少占用内存。
- 混合精度训练是指在训练过程中同时使用 FP16(半精度浮点数)和 FP32(单精度浮点数)两种精度的技术。
- deepspeed 可以根据具体情况选择合适的通信库,例如在 CPU 集群上进行分布式训练,可以选择 mpi 和 gloo;如果是在 GPU 上进行分布式训练,可以选择 nccl。
- mpi 是一种跨节点通信库,常用于 CPU 集群上的分布式训练;
- gloo 是一种高性能的分布式训练框架,支持 CPU 和 GPU 上的分布式训练;
- nccl 是 NVIDIA 提供的 GPU 专用通信库,被广泛应用于 GPU 上的分布式训练。
- DeepSpeed 的核心技术:
- Zero(Zero Redundancy Optimizer,3D 优化与卸载):在 deepspeed 中通过zero_optimization.stage=0/1/2/3 设置,卸载通过zero_optimization.offload_optimizer.device设置
- DeepSpeed 的推理优化技术:
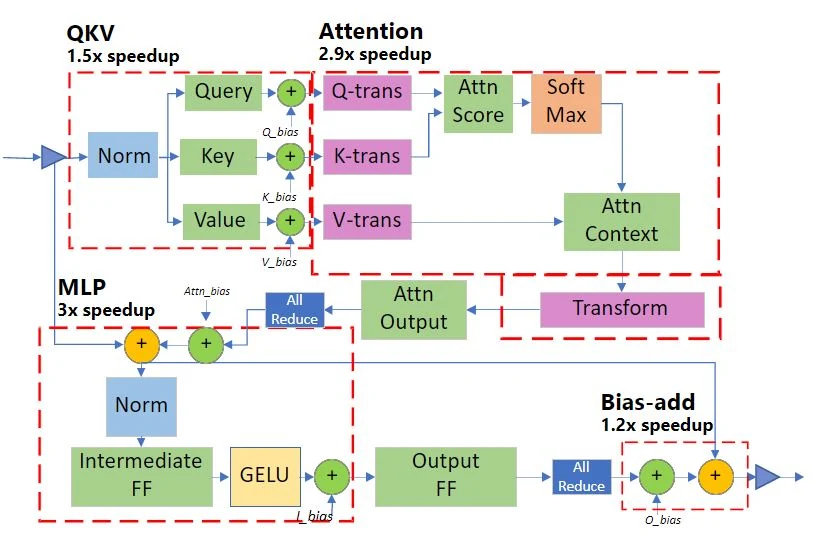
- Deep fusion:如下图,红色虚线框是以该单位为优化 Kernel,对应的数字是优化的效率倍数
- Inference-customized GeMM
微调训练
环境准备
推荐的第三方库版本参考SWIFT安装文档
pip install ms-swift -U

# deepspeed zero2/zero3
pip install deepspeed -U
微调
ms-swift使用了分层式的设计思想,用户可以使用命令行界面、Web-UI界面和直接使用Python的方式进行微调。
使用CLI
我们提供了10分钟在单卡A10上对Qwen2-1.5B进行自我认知微调的最佳实践,具体参考这里,这可以帮助您快速了解SWIFT。
此外,我们给出了一系列脚本帮助您了解SWIFT的训练能力:
- DeepSpeed ZeRO2/ZeRO3: 节约显存资源,但训练速度下降。ZeRO2将对优化器状态、模型梯度进行分片。ZeRO3在ZeRO2基础上,对模型参数进行分片,更加节约显存,但训练速度更慢。参考这里。
- 多机多卡训练: 我们书写了使用swift、torchrun、dlc、deepspeed、accelerate启动多节点运行的shell脚本示例。除了dlc和deepspeed,其他启动脚本都需要在所有节点中启动才可运行。具体参考这里。
小帖士:
- 在使用swift sft通过LoRA技术微调base模型为chat模型时,有时需要手动设置模板。通过添加--template default参数来避免base模型因未见过对话模板中的特殊字符而无法正常停止的情况。具体参考这里。
- 如果使用NPU进行训练,只需要将shell中的CUDA_VISIBLE_DEVICES修改为ASCEND_RT_VISIBLE_DEVICES。
- SWIFT默认在训练时设置--gradient_checkpointing true来节约显存,这会略微降低训练速度。
- 如果要使用deepspeed,你需要安装deepspeed:pip install deepspeed -U。使用deepspeed可以节约显存,但会略微降低训练速度。