
基于Swift框进行量化训练
《基于Swift框进行量化训练》共 0.7 万字,通篇围绕 量化、推理、LoRA、微调 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(8 节)
- 示例代码
- 量化是什么
- **总结**
- **应用**
- **GPTQ 量化**
- **AWQ 量化**
- **HQQ 量化**
- 微调训练
示例代码
量化是什么
模型的推理过程是一个复杂函数的计算过程,这个计算一般以矩阵乘法为主,也就是涉及到了并行计算。一般来说,单核CPU可以进行的计算种类更多,速度更快,但一般都是单条计算;而显卡能进行的都是基础的并行计算,做矩阵乘法再好不过。如果把所有的矩阵都加载到显卡上,就会导致显卡显存的占用大量增加,尤其是LLM模型大小从7b、14b、34b到几百b不等,占用显存的大小就是惊人的数字,如何在减少运算量和显存占用的条件下,做到推理效果不下降太多呢?在这里需要引入浮点数和定点数的概念。
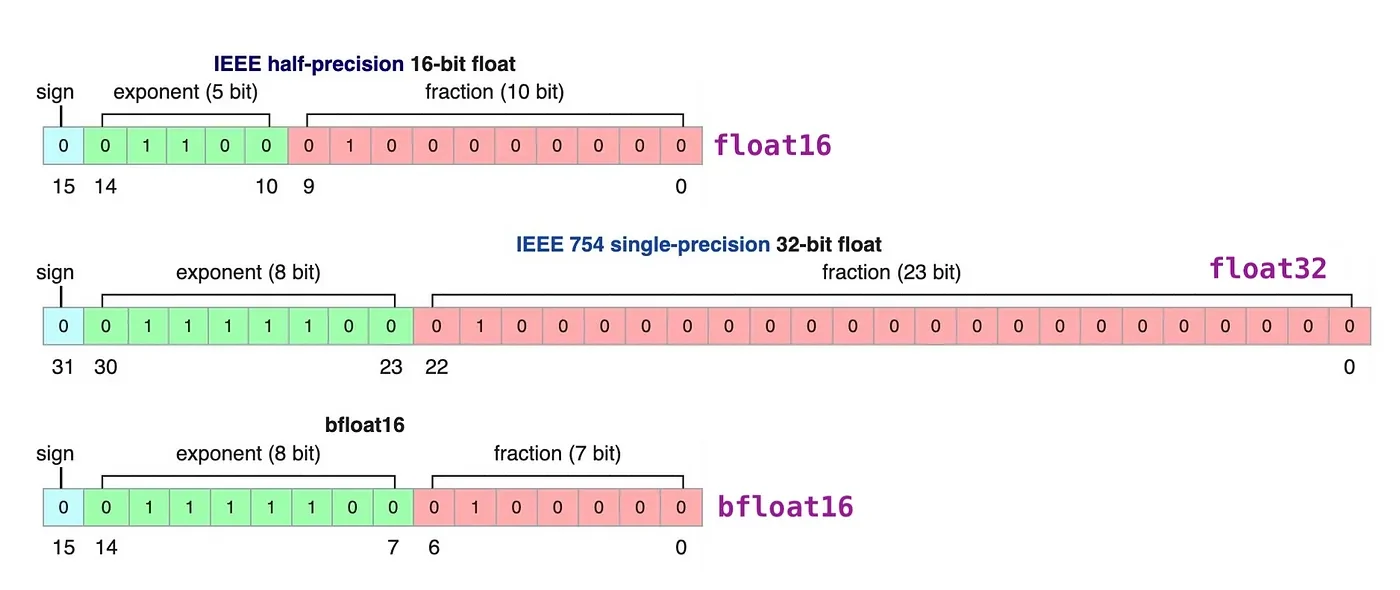
双精度浮点数:在PyTorch中用torch.float64表示,或者在其他语言中也称为double类型,在LLM训练中一般比较少用
全精度浮点数:在PyTorch中用torch.float32表示
低精度浮点数:在PyTorch中用torch.bfloat16和torch.float16表示。这两个浮点数的差别在上图中可以表示:
- bfloat16的小数部分较短,整数部分较长,这会有利于在训练中减少梯度爆炸的情况(即梯度累加值超过了最大值),但是这种数据类型是在N系列显卡Ampere系列才支持的,即30系列显卡。
- float16的小数部分较长,这意味着在精度控制上float16更好,但整数部分较短,比较容易梯度爆炸。
那么是否有更加减少显存占用和计算量的数值表达方式呢?那么可以考虑是否把浮点数转换为定点数(整数),整数计算更快更省显存,如果计算精度下降不大就很完美了。这种用整数计算代替浮点数计算的方法就是量化。
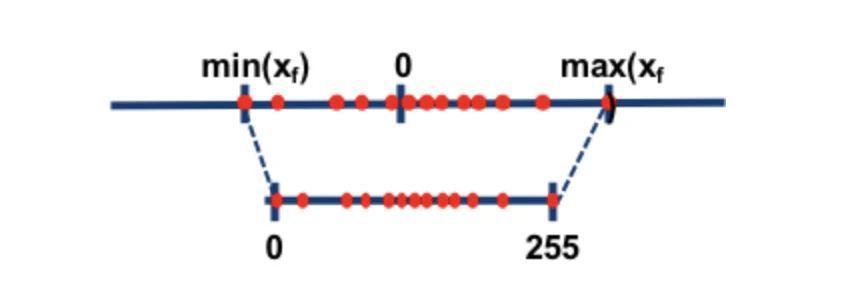
量化的基本原理是根据每个tensor的浮点型最大值和最小值,将其映射为一个固定范围的整形数值集合,比如[-127~127]。假设一个简单的公式:qweight=round(weight/scale),其中qweight代表量化后权重,weight代表量化前权重,scale代表缩放因子,可以看到在进行缩放后为了将浮点型转换为整数过程中增加了round操作丢失了小数部分。在后续计算或反量化为浮点型时存在无法完全还原的情况,这就是精度损失。
按照量化发生的步骤区分,可以划分为PTQ(训练后量化,或离线量化)和QAT(训练感知型量化,或在线量化)。PTQ量化可以分为data-free和calibration两种,前者不使用数据集进行校准直接计算量化因子,后者会根据少量真实数据进行统计分析并对量化因子进行额外校准,但耗费的时间更长。QAT量化会先在待量化的算子上增加一个伪量化结构,并在训练时模拟量化过程并实时更新计算量化因子(类似反向传播过程)及原始权重。QAT由于较为复杂一般作为辅助措施存在,用于改进PTQ量化的技术手段。
按照量化方法可以划分为线性量化、非线性量化(如对数量化)等多种方式,目前较为常用的是线性量化。其中线性量化又可以按照对称性划分为对称量化和非对称量化,非对称量化为了解决weight分布不均匀问题,其在公式中增加了zero_point项:qweight=round(weight/scale + zero_point),使稠密数据部分可以得到更宽泛的数值范围。
按照量化粒度划分可以分为逐层量化(每层使用一套量化因子)、逐组量化(在每层中按照group使用一套量化因子)、逐通道量化(按channel划分量化因子)等几种方式。
按照量化最大值的阈值区分,可以分为饱和量化和不饱和量化两种。不饱和量化按照浮点数最大值和量化后最大值的比例计算量化因子,由于原始weight的非均匀性会导致某些整形数值范围存在权重空缺。饱和量化会计算一个中间值以计算出量化因子,因此会舍弃一部分不重要数据,将重要数据尽量均匀的分布到量化数值范围内。
按照量化后的比特数划分,可以分为2比特量化,4比特量化,8比特量化等类型。
一般来说,PyTorch中量化模块的forward过程会先对量化权重进行反量化后使用浮点数进行计算。
下面介绍几种常用的量化库。
量化库
BnB 量化
BnB 全称是 BitsAndBytes,是几乎最早集成到 transformers 框架中的量化算法。
BitsandBytes 是一个将模型量化为 8 位或 4 位的量化库。由于其方便性和有效性,它是最常见的量化库。