
RAG 与知识库1502 字
LangChain基于RAG实现文档问答
·全库 432 / 611
《LangChain基于RAG实现文档问答》共 0.2 万字,通篇围绕 检索、RAG、Agent、LangChain 展开,归在「RAG 与知识库」这一层。
覆盖检索RAGAgentLangChain推理embedding
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(7 节)
- RAG是什么?
- RAG工作流
- 文档问答
- 索引(Indexing)
- 检索和生成(Retrieval and generation)
- 实现流程
- 代码实现
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
RAG是什么?
大语言模型所实现的最强大应用之一是复杂的问答(Q&A)聊天机器人。这些应用能够回答关于特定源信息的问题。这些应用使用一种称为检索增强生成(RAG)的技术。
RAG是一种用额外数据增强大语言模型知识的技术。
大语言模型可以对广泛的主题进行推理,但它们的知识仅限于训练时截止日期前的公开数据。如果你想构建能够对私有数据或模型截止日期后引入的数据进行推理的人工智能应用,你需要用特定信息来增强模型的知识。检索适当信息并将其插入模型提示的过程被称为检索增强生成(RAG)。
LangChain有许多组件旨在帮助构建问答应用,以及更广泛的RAG应用。
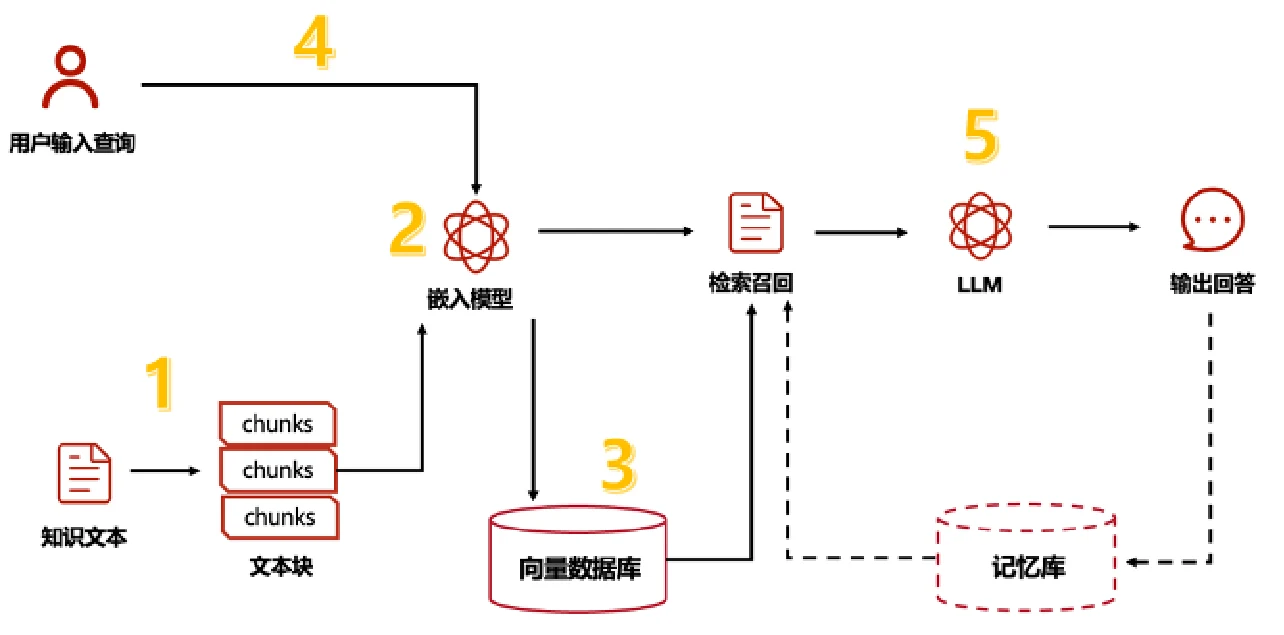
RAG工作流
一个典型的RAG应用有两个主要组成部分:
索引(Indexing):从数据源获取数据并建立索引的管道(pipeline)。这通常在离线状态下进行。
检索和生成(Retrieval and generation):实际的RAG链,在运行时接收用户查询,从索引中检索相关数据,然后将其传递给模型。
从原始数据到答案的最常见完整顺序如下:
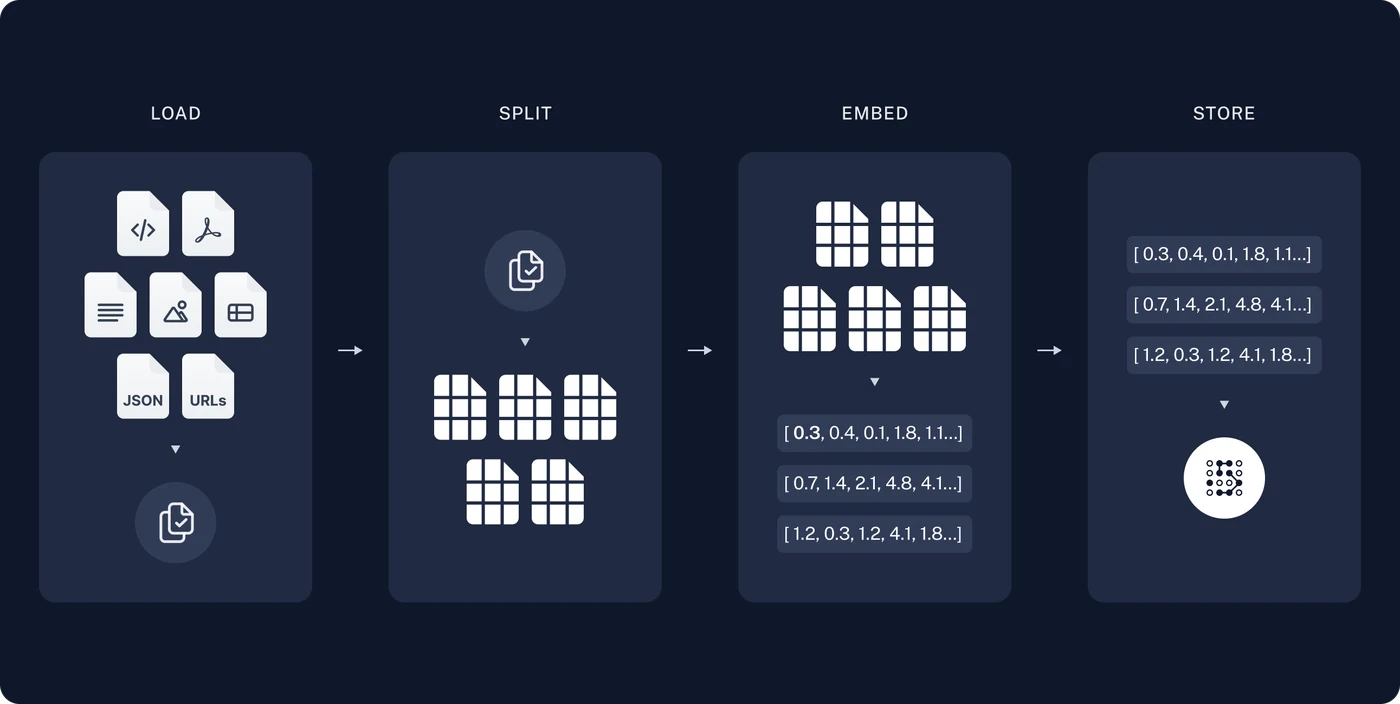
索引(Indexing)
- 加载(Load):首先我们需要加载数据。这是通过文档加载器Document Loaders完成的。
- 分割(Split):文本分割器Text splitters将大型文档(Documents)分成更小的块(chunks)。这对于索引数据和将其传递给模型都很有用,因为大块数据更难搜索,而且不适合模型有限的上下文窗口。
- 存储(Store):我们需要一个地方来存储和索引我们的分割(splits),以便后续可以对其进行搜索。这通常使用向量存储VectorStore和嵌入模型Embeddings model来完成。
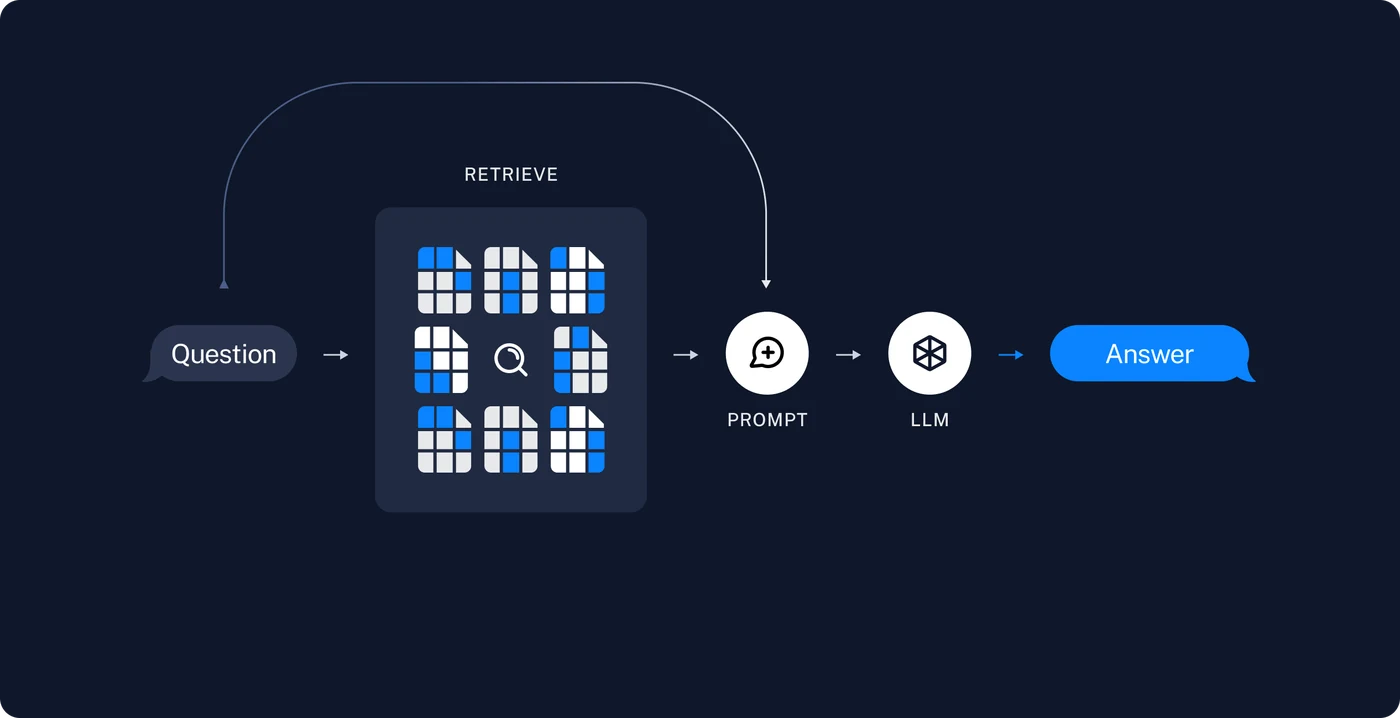
检索和生成(Retrieval and generation)
- 检索(Retrieve):给定用户输入,使用检索器Retriever从存储中检索相关的文本片段。
- 生成(Generate): ChatModel使用包含问题和检索到的数据的提示来生成答案。
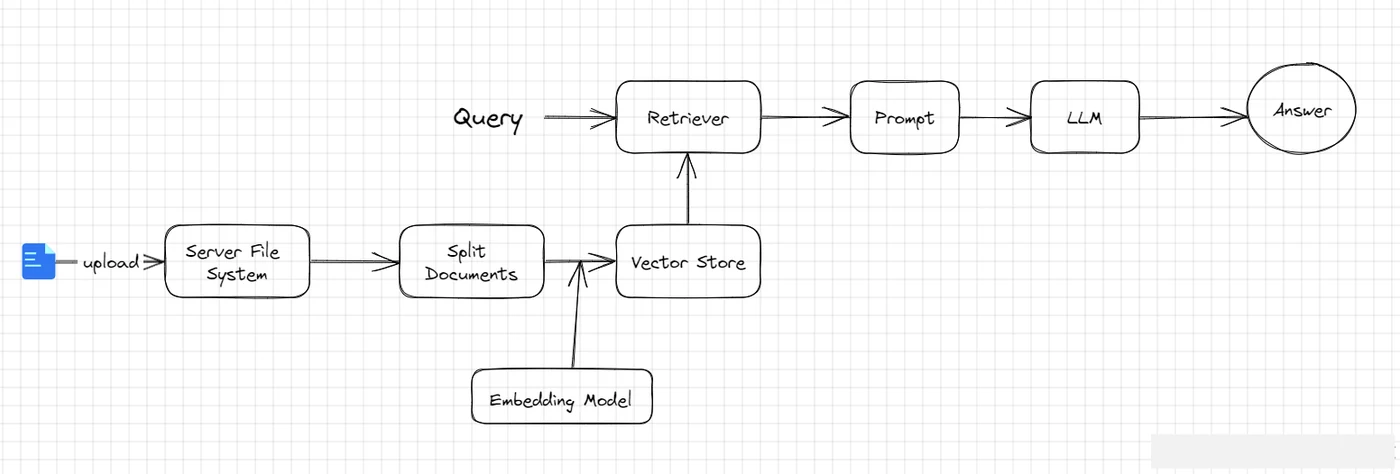
文档问答
实现流程
一个 RAG 程序的 APP 主要有以下流程:
- 用户在 RAG 客户端上传一个txt文件
- 服务器端接收客户端文件,存储在服务端
- 服务器端程序对文件进行读取
- 对文件内容进行拆分,防止一次性塞给 Embedding 模型超 token 限制
- 把 Embedding 后的内容存储在向量数据库,生成检索器
- 程序准备就绪,允许用户进行提问
- 用户提出问题,大模型调用检索器检索文档,把相关片段找出来后,组织后,回复用户。
代码实现
使用 Streamlit 实现文件上传,我这里只实现了 txt 文件上传,其实这里可以在 type 参数里面设置多个文件类型,在后面的检索器方法里面针对每个类型进行处理即可。
实现文件上传
import streamlit as st

# 上传txt文件,允许上传多个文件
uploaded_files = st.sidebar.file_uploader(
    label="上传txt文件", type=["txt"], accept_multiple_files=True
)
if not uploaded_files:
    st.info("请先上传按TXT文档。")
    st.stop()
实现检索器
注意 chunk_size 最大设置数值取决于 Embedding 模型允许单词的最大字符数限制。
import tempfile
import os
from langchain.document_loaders import TextLoader
from langchain_community.embeddings import QianfanEmbeddingsEndpoint
from langchain_chroma import Chroma
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 实现检索器
@st.cache_resource(ttl="1h")
def configure_retriever(uploaded_files):
    # 读取上传的文档,并写入一个临时目录
    docs = []
    temp_dir = tempfile.TemporaryDirectory(dir=r"D:\\")
    for file in uploaded_files:
        temp_filepath = os.path.join(temp_dir.name, file.name)
        with open(temp_filepath, "wb") as f:
            f.write(file.getvalue())
        loader = TextLoader(temp_filepath, encoding="utf-8")
        docs.extend(loader.load())