RAG 与知识库795 字
LangGraph基于RAG构建智能客服应用
·全库 436 / 611
《LangGraph基于RAG构建智能客服应用》共 0.1 万字,通篇围绕 RAG、检索、上下文、LangChain 展开,归在「RAG 与知识库」这一层。
覆盖RAG检索上下文LangChain工作流Agent
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(8 节)
- 索引(Indexing)
- 检索和生成(Retrieval and generation)
- 客服界面
- 运行环境
- 安装依赖
- 配置OpenAI 环境变量
- 运行项目
- 验证效果
目录 · 11 节
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.10
AI 领域正从基础的 RAG 系统向更智能的 AI 智能体进化,后者能处理更复杂的任务并适应新信息。LangGraph 作为 LangChain 库的扩展,助力开发者构建具有状态管理和循环计算能力的先进 AI 系统。
LangGraph流程
LangGraph 是 LangChain 的高级库,为大型语言模型(LLM)带来循环计算能力。它超越了 LangChain 的线性工作流,通过循环支持复杂的任务处理。
- 状态:维护计算过程中的上下文,实现基于累积数据的动态决策。
- 节点:代表计算步骤,执行特定任务,可定制以适应不同工作流。
- 边:连接节点,定义计算流程,支持条件逻辑,实现复杂工作流。
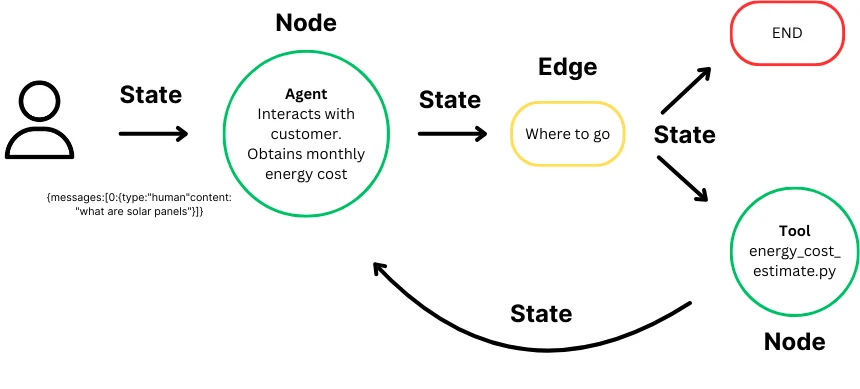
LangGraph 简化了 AI 开发,自动管理状态,保持上下文,使 AI 能智能响应变化。它让开发者专注于创新,而非技术细节,同时确保应用程序的高性能和可靠性。
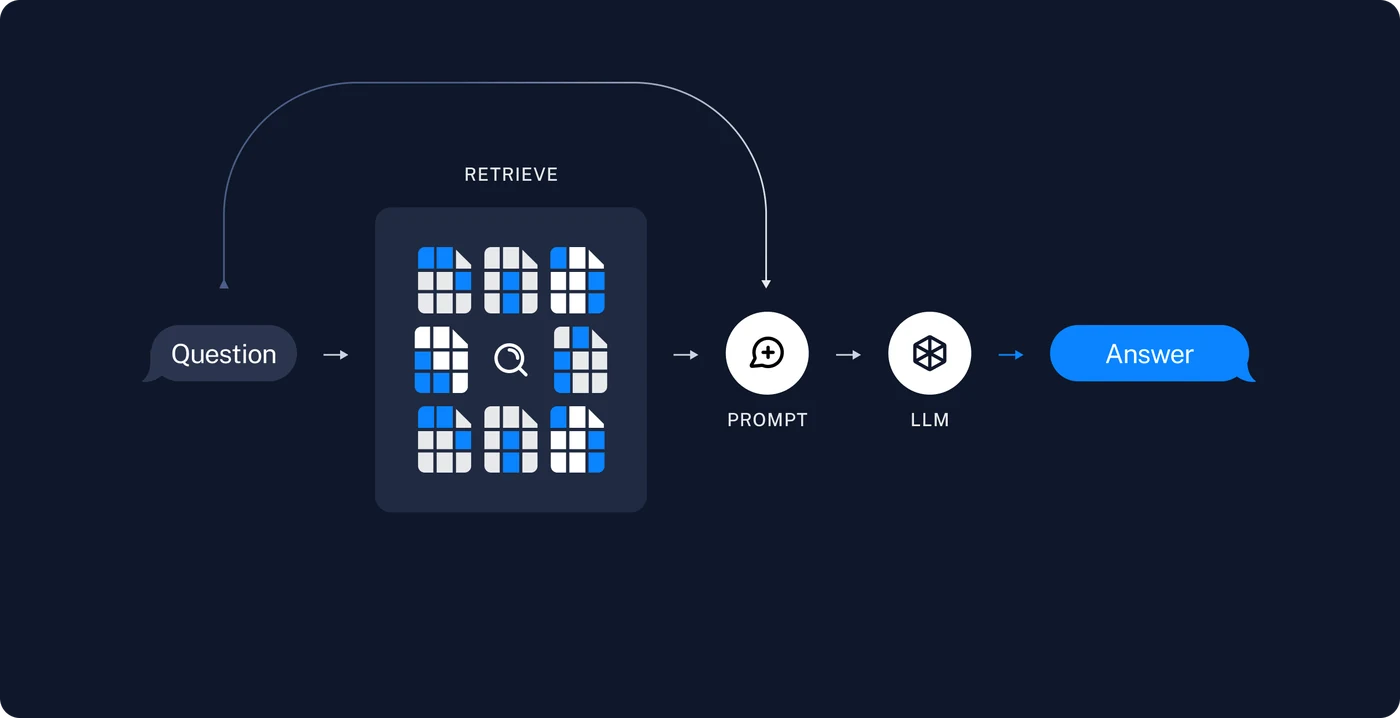
RAG流程
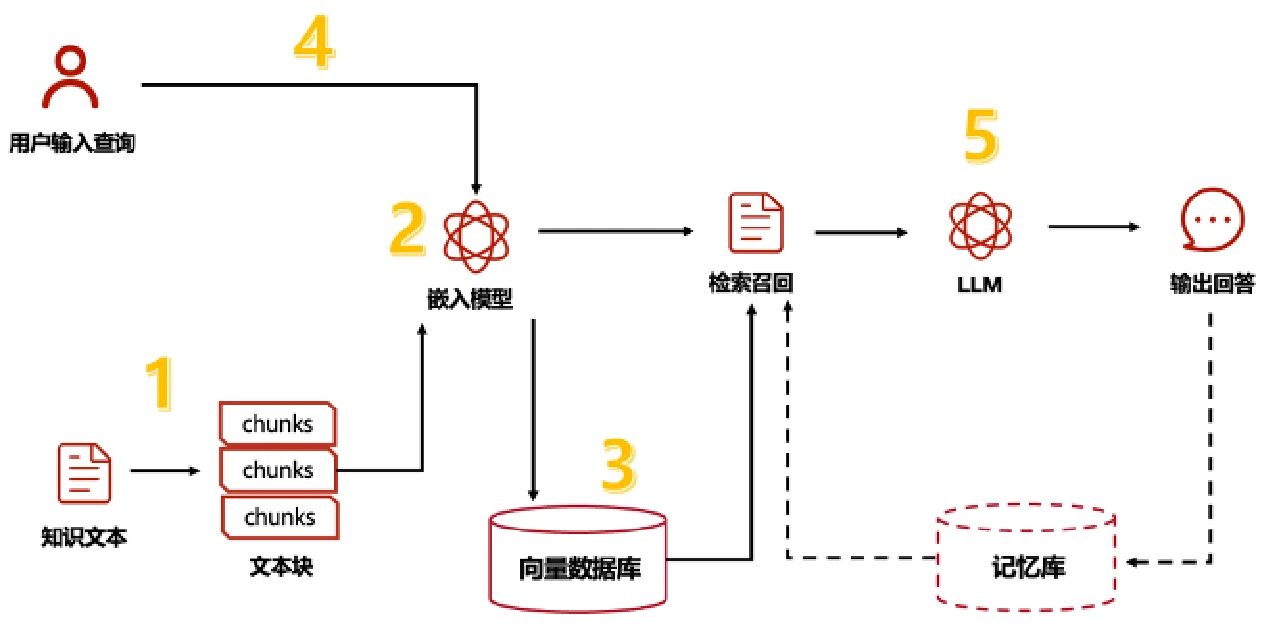
一个典型的RAG应用有两个主要组成部分:
索引(Indexing):从数据源获取数据并建立索引的管道(pipeline)。这通常在离线状态下进行。
检索和生成(Retrieval and generation):实际的RAG链,在运行时接收用户查询,从索引中检索相关数据,然后将其传递给模型。
从原始数据到答案的最常见完整顺序如下:
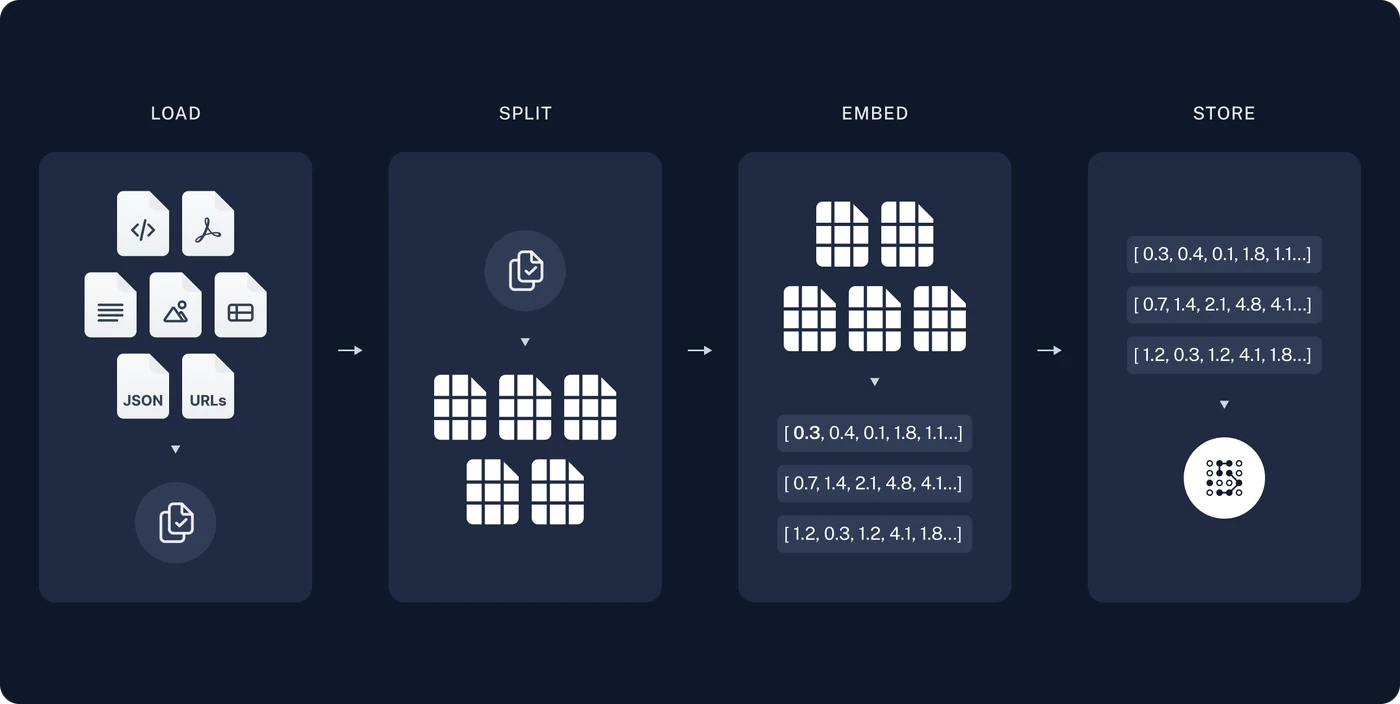
索引(Indexing)
- 加载(Load):首先我们需要加载数据。这是通过文档加载器Document Loaders完成的。
- 分割(Split):文本分割器Text splitters将大型文档(Documents)分成更小的块(chunks)。这对于索引数据和将其传递给模型都很有用,因为大块数据更难搜索,而且不适合模型有限的上下文窗口。
- 存储(Store):我们需要一个地方来存储和索引我们的分割(splits),以便后续可以对其进行搜索。这通常使用向量存储VectorStore和嵌入模型Embeddings model来完成。
检索和生成(Retrieval and generation)
- 检索(Retrieve):给定用户输入,使用检索器Retriever从存储中检索相关的文本片段。
- 生成(Generate): ChatModel使用包含问题和检索到的数据的提示来生成答案。
LangGraph基于RAG构建智能客服
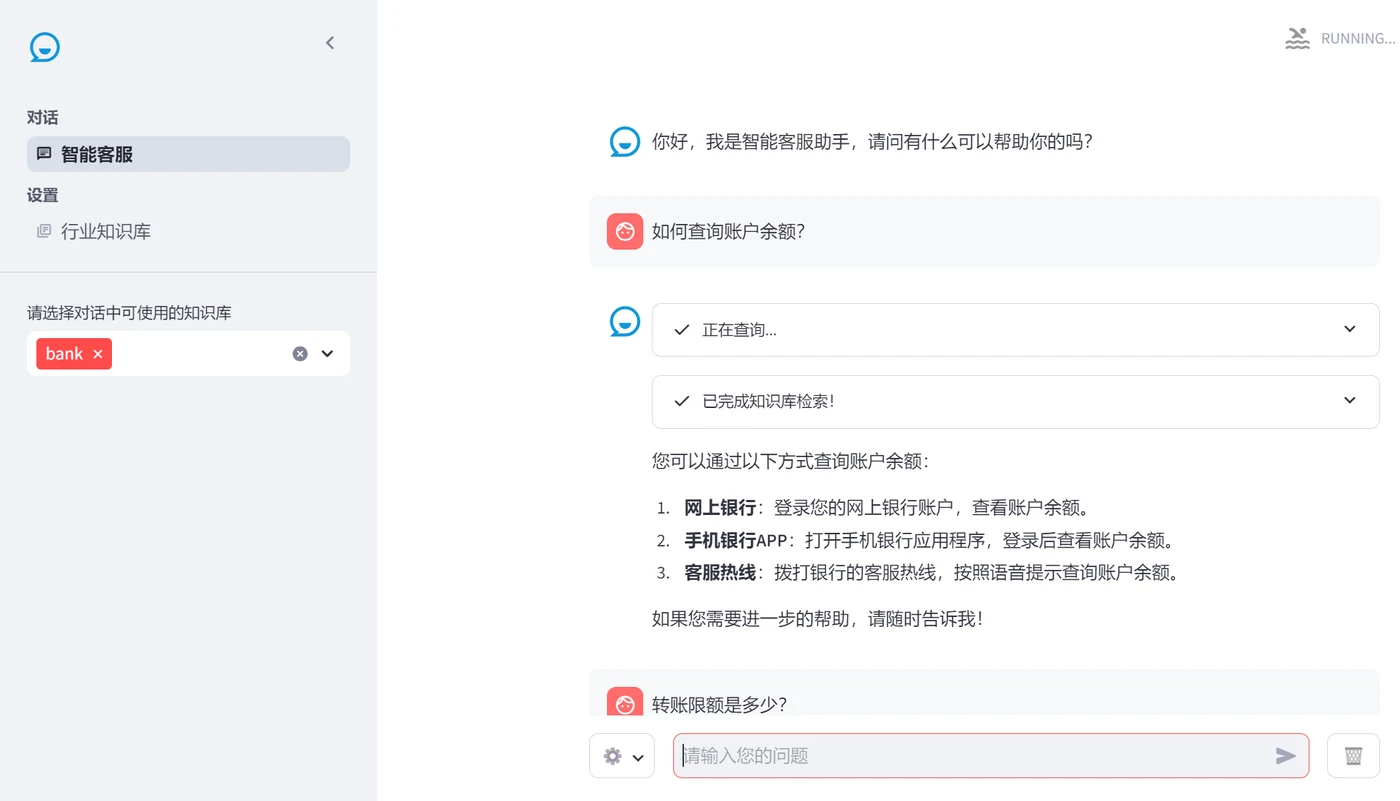
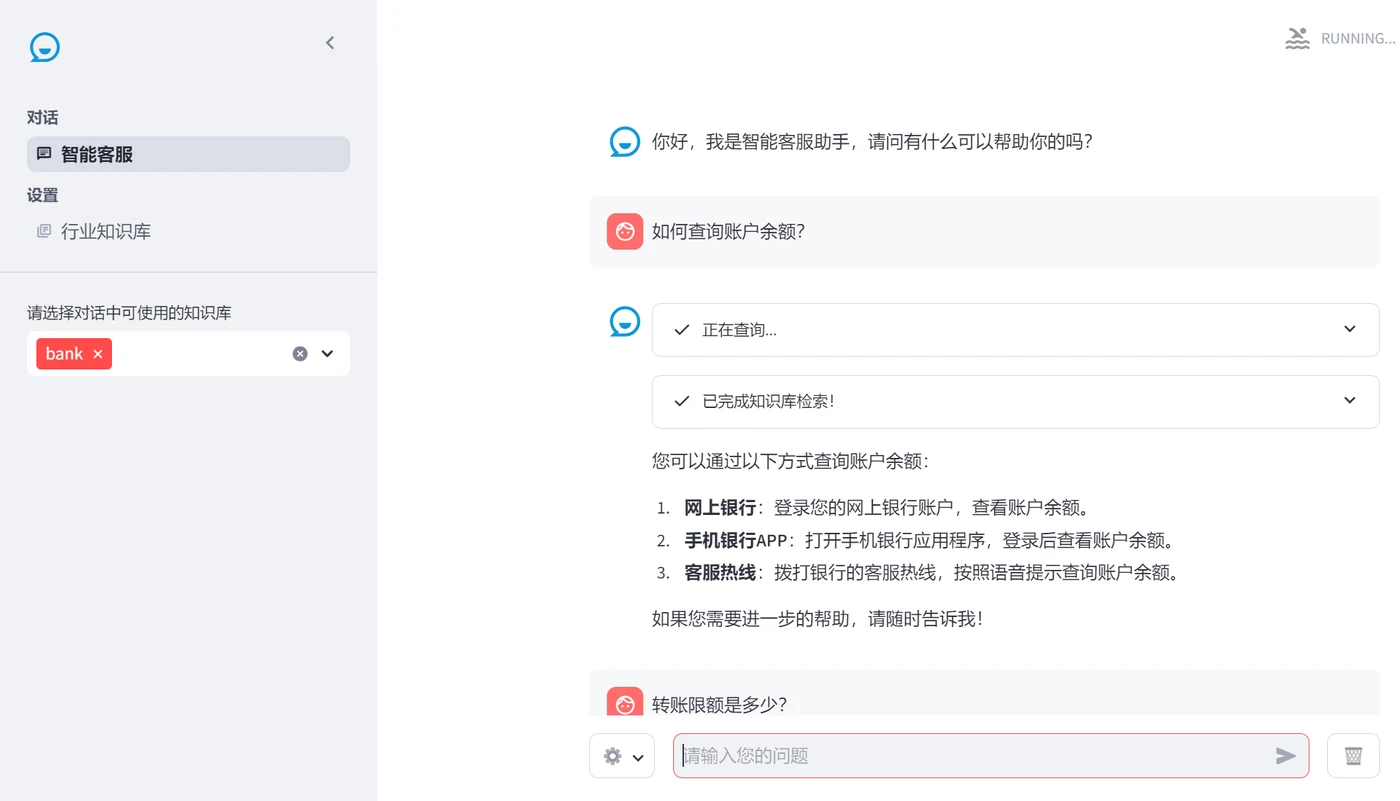
客服界面
运行环境
建议使用 Python>=3.10
可参考如下命令进行环境创建
conda create -n agent python=3.10 -y
conda activate agent
安装依赖
pip install -r requirements.txt配置OpenAI 环境变量
Windows 导入环境变量
注意:每次执行完,需要重启PyCharm才能生效
setx OPENAI_BASE_URL "https://api.openai.com/v1"
setx OPENAI_API_KEY "sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"
Mac 导入环境变量
export OPENAI_BASE_URL='https://api.openai.com/v1'
export OPENAI_API_KEY='sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx'
运行项目
使用以下命令行运行webui
streamlit run rag.py验证效果
如何查询账户余额?