
大模型时代为什么需要向量数据库?
《大模型时代为什么需要向量数据库?》共 0.5 万字,通篇围绕 向量、数据库、embedding、检索 展开,归在「RAG 与知识库」这一层。
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(8 节)
- 向量嵌入
- 特征和向量
- 相似性测量
- 相似性搜索
- 嵌入模型
- 嵌入文本列表
- 嵌入单个查询
- 问答助手
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.10
向量数据库
向量数据库(Vector Database),也叫矢量数据库,主要用来存储和处理向量数据。
在数学中,向量是有大小和方向的量,可以使用带箭头的线段表示,箭头指向即为向量的方向,线段的长度表示向量的大小。两个向量的距离或者相似性可以通过欧式距离或者余弦距离得到。
图像、文本和音视频这种非结构化数据都可以通过某种变换或者嵌入学习转化为向量数据存储到向量数据库中,从而实现对图像、文本和音视频的相似性搜索和检索。这意味着您可以使用向量数据库根据语义或上下文含义查找最相似或相关的数据,而不是使用基于精确匹配或预定义标准查询数据库的传统方法。
向量数据库的主要特点是高效存储与检索。利用索引技术和向量检索算法能实现高维大数据下的快速响应。向量数据库也是一种数据库,除了要管理向量数据外,还是支持对传统结构化数据的管理。实际使用时,有很多场景会同时对向量字段和结构化字段进行过滤检索,这对向量数据库来说也是一种挑战。
向量嵌入
向量嵌入(Vector Embeddings),对于传统数据库,搜索功能都是基于不同的索引方式(B Tree、倒排索引等)加上精确匹配和排序算法(BM25、TF-IDF)等实现的。本质还是基于文本的精确匹配,这种索引和搜索算法对于关键字的搜索功能非常合适,但对于语义搜索功能就非常弱。
例如,如果你搜索 “小狗”,那么你只能得到带有“小狗” 关键字相关的结果,而无法得到 “柯基”、“金毛” 等结果,因为 “小狗” 和“金毛”是不同的词,传统数据库无法识别它们的语义关系,所以传统的应用需要人为的将 “小狗” 和“金毛”等词之间打上特征标签进行关联,这样才能实现语义搜索。而如何将生成和挑选特征这个过程,也被称为 Feature Engineering (特征工程),它是将原始数据转化成更好的表达问题本质的特征的过程。
但是如果你需要处理非结构化的数据,就会发现非结构化数据的特征数量会开始快速膨胀,例如我们处理的是图像、音频、视频等数据,这个过程就变得非常困难。例如,对于图像,可以标注颜色、形状、纹理、边缘、对象、场景等特征,但是这些特征太多了,而且很难人为的进行标注,所以我们需要一种自动化的方式来提取这些特征,而这可以通过 Vector Embedding 实现。
Vector Embedding 是由 AI 模型(例如大型语言模型 LLM)生成的,它会根据不同的算法生成高维度的向量数据,代表着数据的不同特征,这些特征代表了数据的不同维度。例如,对于文本,这些特征可能包括词汇、语法、语义、情感、情绪、主题、上下文等。对于音频,这些特征可能包括音调、节奏、音高、音色、音量、语音、音乐等。
例如对于目前来说,文本向量可以通过 OpenAI 的 text-embedding-ada-002 模型生成,图像向量可以通过 clip-vit-base-patch32 模型生成,而音频向量可以通过 wav2vec2-base-960h 模型生成。这些向量都是通过 AI 模型生成的,所以它们都是具有语义信息的。
例如我们将这句话 “Your text string goes here” 用 text-embedding-ada-002 模型进行文本 Embedding,它会生成一个 1536 维的向量,得到的结果是这样:“-0.006929283495992422, -0.005336422007530928, ... -4547132266452536e-05,-0.024047505110502243”,它是一个长度为 1536 的数组。这个向量就包含了这句话的所有特征,这些特征包括词汇、语法,我们可以将它存入向量数据库中,以便我们后续进行语义搜索。
特征和向量
虽然向量数据库的核心在于相似性搜索 (Similarity Search),但在深入了解相似性搜索前,我们需要先详细了解一下特征和向量的概念和原理。
我们先思考一个问题?为什么我们在生活中区分不同的物品和事物?
如果从理论角度出发,这是因为我们会通过识别不同事物之间不同的特征来识别种类,例如分别不同种类的小狗,就可以通过体型大小、毛发长度、鼻子长短等特征来区分。如下面这张照片按照体型排序,可以看到体型越大的狗越靠近坐标轴右边,这样就能得到一个体型特征的一维坐标和对应的数值,从 0 到 1 的数字中得到每只狗在坐标系中的位置。
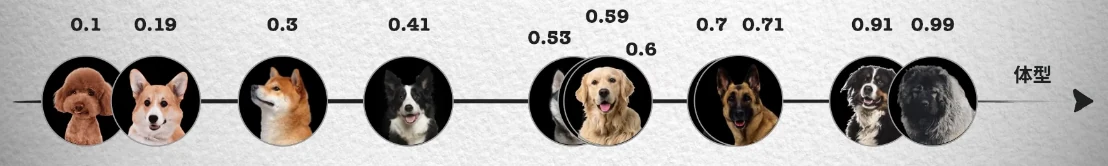
然而单靠一个体型大小的特征并不够,像照片中哈士奇、金毛和拉布拉多的体型就非常接近,我们无法区分。所以我们会继续观察其它的特征,例如毛发的长短。
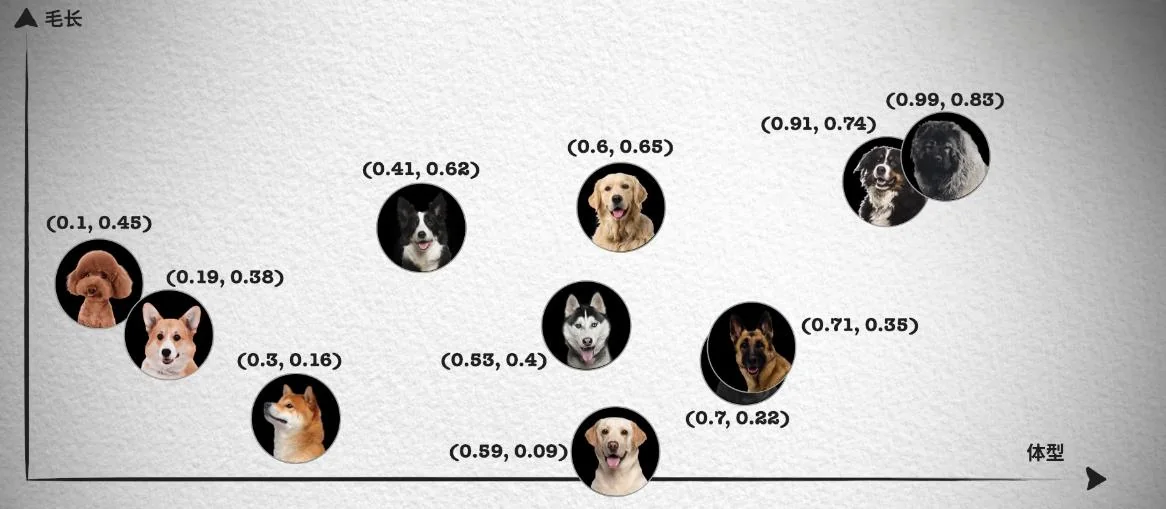
这样每只狗对应一个二维坐标点,我们就能轻易的将哈士奇、金毛和拉布拉多区分开来,如果这时仍然无法很好的区分德牧和罗威纳犬。我们就可以继续再从其它的特征区分,比如鼻子的长短,这样就能得到一个三维的坐标系和每只狗在三维坐标系中的位置。