
如何使用AutoDL高效训练大模型
《如何使用AutoDL高效训练大模型》共 0.5 万字,通篇围绕 GPU、算力、显存、架构 展开,归在「训练、微调与数据」这一层。
适合要自己训模型、或者判断这一版该不该训的人
目录骨架(3 节)
- 创建实例 [](#_2)
- 上传数据
- 终端训练 [](#_4)
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.10
分享内容
- AutoDL介绍与快速开始
- 如何选择GPU服务器
- 如何使用JupyterLab和SSH远程连接
- Conda环境安装与PyCharm远程开发
快速开始
AutoDL 是一个专注于提供深度学习算力的云平台。它通过提供高性能的 GPU 资源,帮助用户轻松应对复杂的深度学习任务,同时保持成本的可控性。
为什么选择 AutoDL 云平台?
平价好用:相比其他云平台,AutoDL 提供的算力价格更加亲民,适合预算有限的研究者和开发者。
高性能:支持多种高性能 GPU,如 NVIDIA Tesla V100、A100 等,确保训练速度和模型性能。
易用性:简洁的界面和丰富的文档,即使是初学者也能快速上手。
灵活性:支持按需付费和包年包月等多种计费方式,满足不同用户的需求。
如何使用 AutoDL 云平台?
注册账号:访问 AutoDL 官网,注册并登录账号。
选择算力:根据你的需求选择合适的 GPU 配置。
上传数据:将你的数据集上传到 AutoDL 云平台。
启动训练:编写或上传你的训练脚本,启动训练任务。
监控进度:通过平台提供的监控工具,实时查看训练进度和资源使用情况。
AutoDL 实例中的数据(包括环境)在关机后将全部保存,开机后无需再次配置和上传数据。总而言之,实例在数据在,但是连续关机 15 天实例将被释放。
创建实例
注册后进入控制台,在我的实例菜单下,点击租用新实例
(原文配图已失效)
在租用实例页面:选择计费方式,选择合适的主机,选择要创建实例中的 GPU 数量,选择镜像(内置了不同的深度学习框架),最后创建即可
如果你需要更大的硬盘用于存放数据,那么请留意「硬盘」这列「最大可扩容」大小。数据盘等的路径请参考文档
(原文配图已失效)
创建完成后等待开机,今后主要用到的操作入口见截图中
(原文配图已失效)
上传数据
开机后在这个正在运行中的实例上找到快捷工具:JupyterLab,点击打开,在下面的截图中找到上传按钮,即可上传数据。如需上传文件夹或更高级的上传方式等,请查阅上传数据文档
(原文配图已失效)
终端训练
在打开的 JupyterLab 页面中打开终端。如需使用其他 IDE 远程开发,请参考 VSCode(推荐) 和 PyCharm
(原文配图已失效)
在终端中执行您的 Python 命令等完成训练
(原文配图已失效)
如何选择GPU
如何排查性能瓶颈参考文档。此外需注意3060、3090、3080Ti、A4000、A5000、A40、A100、A5000等安培架构的卡需要cuda11.1及以上才能使用(TitanXp、1080Ti、2080Ti、P40、V100没有要求),请使用较高版本的框架。
AutoDL平台分配GPU、CPU、内存的机制为:按租用的GPU数量成比例分配CPU和内存,算力市场显示的CPU和内存均为每GPU分配的CPU和内存,如果租用两块GPU,那么CPU和内存就x2。此外GPU非共享,每个实例对GPU是独占的。
一. 选择CPU
CPU非常重要!尽管CPU并不直接参与深度学习模型计算,但CPU需要提供大于模型训练吞吐的数据处理能力。比如,一台8卡NVIDIA V100的DGX服务器,训练ResNet-50 ImageNet图像分类的吞吐就达到8000张图像/秒,而扩展到16卡V100的DGX2服务器却没达到2倍的吞吐,说明这台DGX2服务器的CPU已经成为性能瓶颈了。
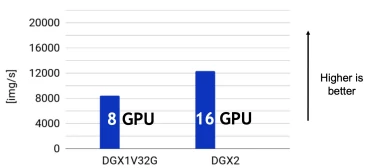
我们通常为每块GPU分配固定数量的CPU逻辑核心。理想情况下,模型计算吞吐随GPU数量线性增长,单GPU的合理CPU逻辑核心数分配可以直接线性扩展到多GPU上。AutoDL平台的算力实例提供了多种CPU分配规格。每块GPU应配备至少4~8核心的CPU,以满足多线程的异步数据读取。分配更多的核心通常不会再有很大的收益,此时的数据读取瓶颈通常源于Python的多进程切换与数据通信开销(如使用PyTorch DataLoader)。那么怎么省钱克服数据读取瓶颈呢,不妨在AutoDL平台试试C++和CUDA编写的NVIDIA DALI数据读取加速库吧。在我们的测试中,单核CPU实例的数据读取能力就超过了基于Python的八核心实例,真正做到了为模型训练保驾护航。