
模型架构与原理4058 字
如何针对超长文本进行微调训练
·全库 444 / 611
《如何针对超长文本进行微调训练》共 0.4 万字,通篇围绕 数据集、预训练、CUDA、微调 展开,归在「模型架构与原理」这一层。
覆盖数据集预训练CUDA微调需求Attention
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 1. 评论分析任务概述
- 2. 资讯评论数据集介绍
- 3. 处理超长文本的训练问题
- 4. 扩展词汇表并匹配模型
- 5. 修改模型配置信息
- 1.1 数据集更换
- 1.2 预训练模型更换
- 1.3 训练与测试
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.10
分享内容
- 新闻评论分析任务训练流程
- 加载自定义数据集
- 处理超长文本的训练问题
- 扩展词汇表并匹配模型
- 修改模型配置信息
1. 评论分析任务概述
评论分析是情感分析的一个应用场景,旨在通过文本分类技术识别评论的情感倾向。本次将详细介绍如何更换数据集和模型来实现这一任务。
训练流程
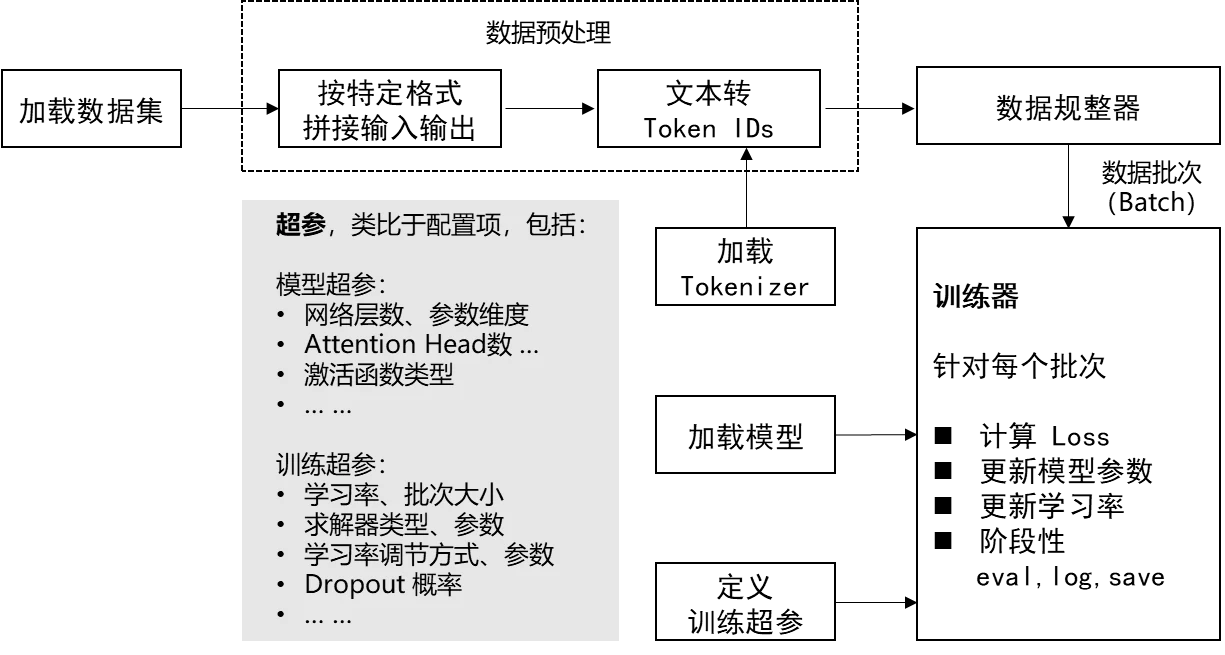
1.1 数据集更换
在自然语言处理(NLP)任务中,数据集通常包含文本和对应的标签。文章评论分析的数据集可以采用CSV格式,其中一列存储评论文本,另一列存储情感标签(如正面或负面)。
加载CSV格式的数据
我们可以使用datasets库来加载本地的CSV文件。以下是一个示例代码:
# CustomData.py
from torch.utils.data import Dataset  # 从torch库中导入Dataset类,用于创建自定义数据集类
from datasets import load_dataset  # 从datasets库中导入load_dataset函数,用于加载数据集

class CustomDataset(Dataset):  # 定义一个名为MyDataset的类,继承自Dataset类
    def __init__(self,split):  # 定义类的初始化方法,接收一个参数split,表示数据集的分割类型
        #使用load_dataset函数加载csv文件,路径为"./data/{split}.csv",并指定数据集分割为"train"
        self.dataset = load_dataset(path="csv",data_files=f"./data/{split}.csv",split="train")
    def __len__(self):  # 定义一个方法用于返回数据集的长度
        return len(self.dataset)  # 返回加载的数据集的长度,即数据集中的样本数量

    def __getitem__(self, item):  # 定义一个方法用于获取数据集中的某个样本
        text = self.dataset[item]["text"]  # 获取数据集中第item个样本的"text"字段
        label = self.dataset[item]["label"]  # 获取数据集中第item个样本的"label"字段

        return text,label  # 返回获取的文本和标签
if __name__ == '__main__':  # 判断是否在主程序中运行
    dataset = CustomDataset("test")  # 创建MyDataset类的实例,传入"test"作为split参数
    for data in dataset:  # 遍历数据集中的每个样本
        print(data)  # 打印每个样本的内容
代码解析
- load_dataset:用于从磁盘加载数据集,支持多种格式(如CSV、JSON等)。
- __len__:返回数据集的大小,便于在训练中使用。
- __getitem__:根据索引返回单个数据条目(文本和标签),符合PyTorch的Dataset类标准。
注意事项
- 数据集路径应根据实际情况调整,如data/Article/{split}.csv。
- 确保CSV文件中的列名与代码中的字段匹配(如"text"和"label")。
1.2 预训练模型更换
文章评论分析任务可以通过微调预训练的BERT模型来完成。可以选择不同的中文预训练模型,如bert-base-chinese或hfl/chinese-roberta-wwm-ext。
代码示例
# net.py
from transformers import BertModel, BertConfig  # 导入Bert模型和Bert配置类

import torch  # 导入PyTorch库

DEVICE = torch.device("cuda" if torch.cuda.is_available() else "cpu")  # 设置设备为CUDA(如果可用),否则为CPU

# pretrained = BertModel.from_pretrained(r"bert-base-chinese").to(DEVICE)
# pretrained.embeddings.position_embeddings = torch.nn.Embedding(1500,768).to(DEVICE)
# print(pretrained)
# config = pretrained.config
configuration = BertConfig.from_pretrained(r"bert-base-chinese")  # 从预训练模型加载配置
configuration.max_position_embeddings = 1500  # 设置最大位置嵌入为1500
print(configuration)  # 打印配置信息