
DeepSeek R1打造本地化RAG知识库
《DeepSeek R1打造本地化RAG知识库》共 0.3 万字,通篇围绕 Docker、Dify、知识库、RAG 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 回答网友的问题
- 分享内容
- RAG 工作原理与技术架构深度剖析
- Dify入门与私有化部署
- Dify 构建知识库
- Dify接入Deepseek R1构建Agent应用
- 索引(Indexing)
- 检索和生成(Retrieval and generation)
回答网友的问题
来自《基于DeepSeek R1搭建企业级知识库》
分享内容
- RAG 工作原理与技术架构深度剖析
- Dify入门与私有化部署
- Dify 构建知识库
- Dify接入Deepseek R1构建Agent应用
RAG 工作原理与技术架构深度剖析
大语言模型所实现的最强大应用之一是复杂的问答(Q&A)聊天机器人。这些应用能够回答关于特定源信息的问题。这些应用使用一种称为检索增强生成(RAG)的技术。
RAG是一种用额外数据增强大语言模型知识的技术。
大语言模型可以对广泛的主题进行推理,但它们的知识仅限于训练时截止日期前的公开数据。如果你想构建能够对私有数据或模型截止日期后引入的数据进行推理的人工智能应用,你需要用特定信息来增强模型的知识。检索适当信息并将其插入模型提示的过程被称为检索增强生成(RAG)。
LangChain有许多组件旨在帮助构建问答应用,以及更广泛的RAG应用。
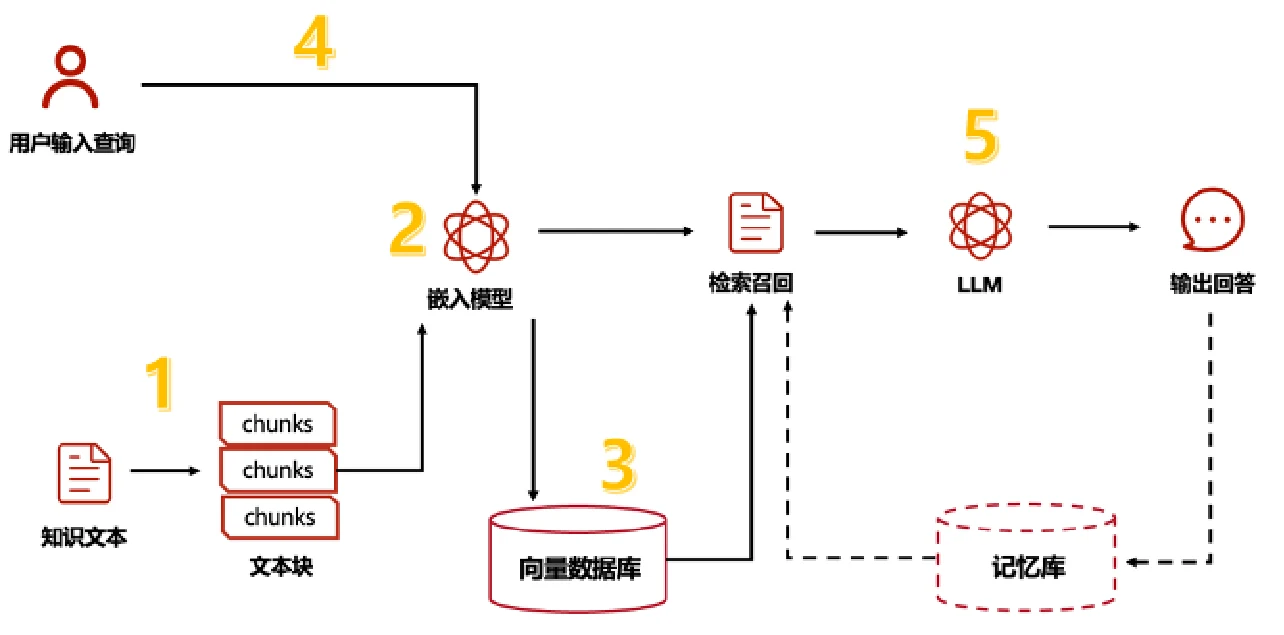
一个典型的RAG应用有两个主要组成部分:
索引(Indexing):从数据源获取数据并建立索引的管道(pipeline)。这通常在离线状态下进行。
检索和生成(Retrieval and generation):实际的RAG链,在运行时接收用户查询,从索引中检索相关数据,然后将其传递给模型。
从原始数据到答案的最常见完整顺序如下:
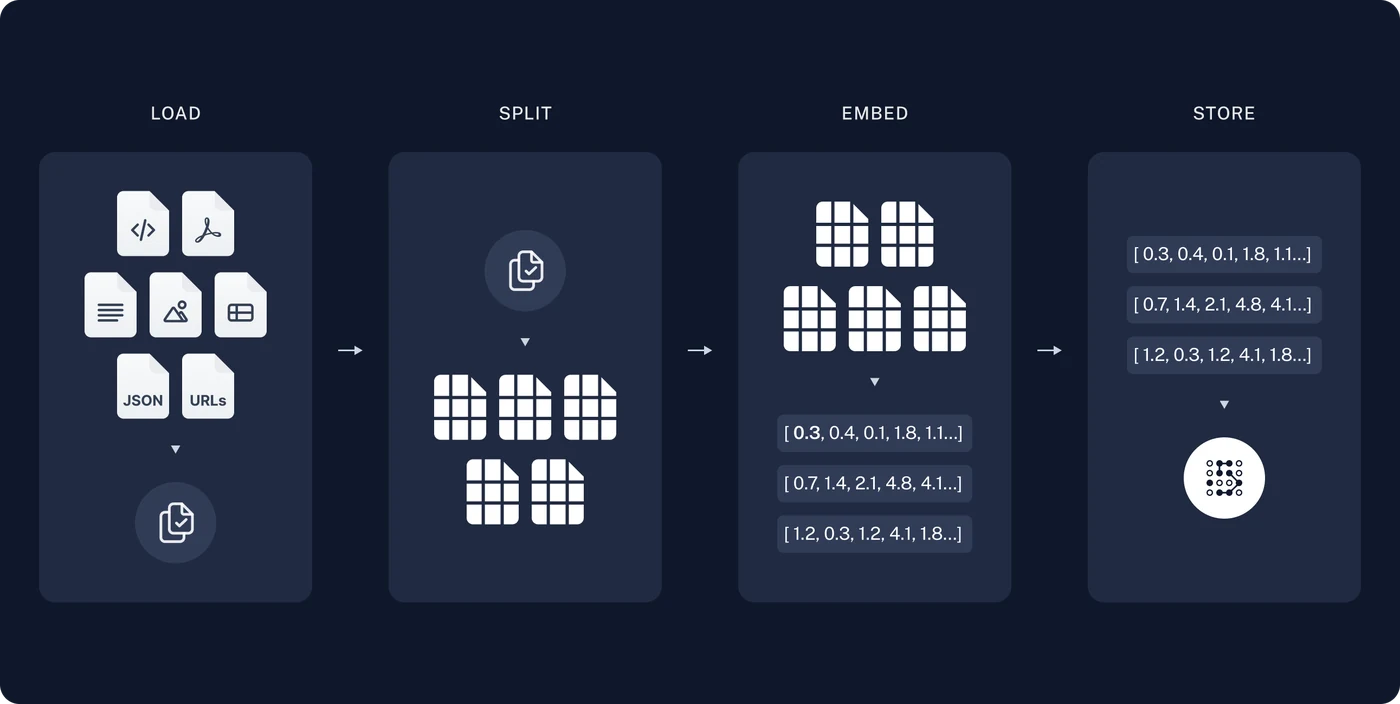
索引(Indexing)
- 加载(Load):首先我们需要加载数据。这是通过文档加载器Document Loaders完成的。
- 分割(Split):文本分割器Text splitters将大型文档(Documents)分成更小的块(chunks)。这对于索引数据和将其传递给模型都很有用,因为大块数据更难搜索,而且不适合模型有限的上下文窗口。
- 存储(Store):我们需要一个地方来存储和索引我们的分割(splits),以便后续可以对其进行搜索。这通常使用向量存储VectorStore和嵌入模型Embeddings model来完成。
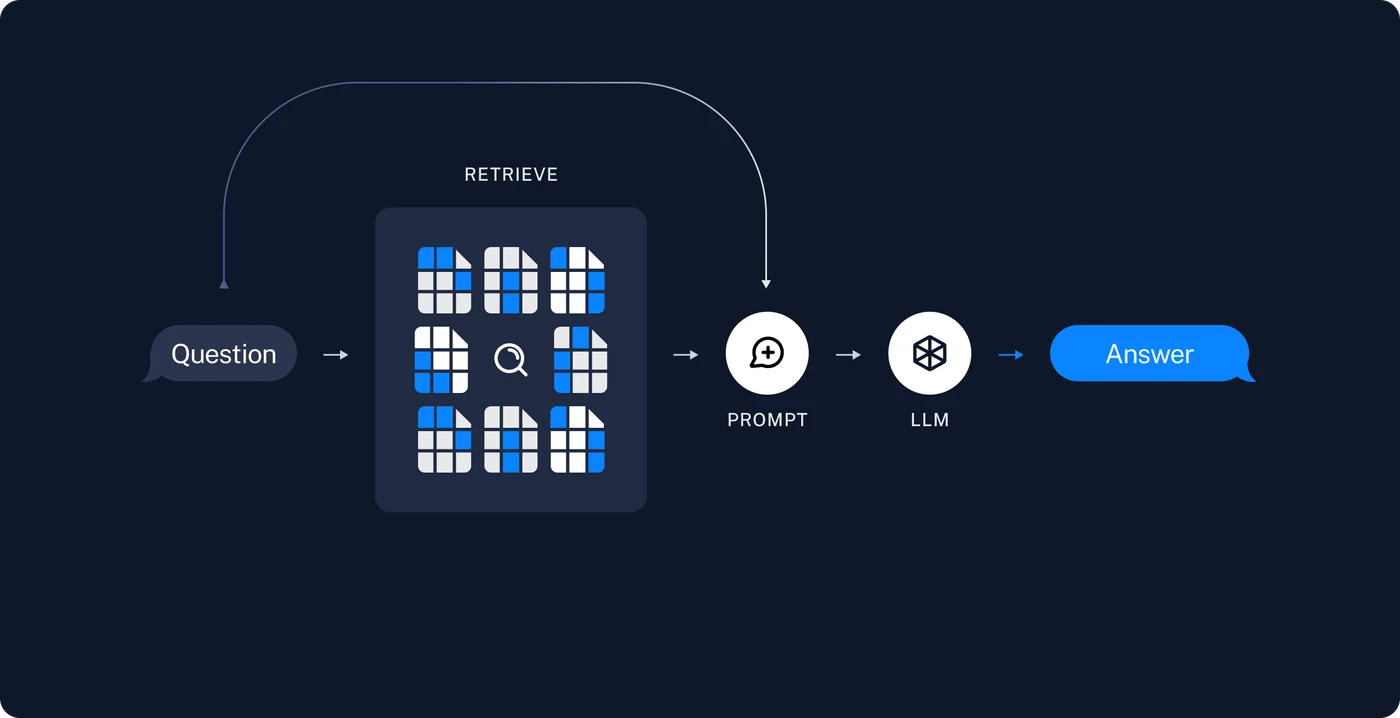
检索和生成(Retrieval and generation)
- 检索(Retrieve):给定用户输入,使用检索器Retriever从存储中检索相关的文本片段。
- 生成(Generate): ChatModel使用包含问题和检索到的数据的提示来生成答案。
Dify入门与私有化部署
官网:https://cloud.dify.ai/apps
Dify 是一款开源的大语言模型(LLM) 应用开发平台。它融合了后端即服务(Backend as Service)和 LLMOps 的理念,使开发者可以快速搭建生产级的生成式 AI 应用。即使你是非技术人员,也能参与到 AI 应用的定义和数据运营过程中。
由于 Dify 内置了构建 LLM 应用所需的关键技术栈,包括对数百个模型的支持、直观的 Prompt 编排界面、高质量的 RAG 引擎、稳健的 Agent 框架、灵活的流程编排,并同时提供了一套易用的界面和 API。这为开发者节省了许多重复造轮子的时间,使其可以专注在创新和业务需求上。
为什么使用 Dify?
你或许可以把 LangChain 这类的开发库(Library)想象为有着锤子、钉子的工具箱。与之相比,Dify 提供了更接近生产需要的完整方案,Dify 好比是一套脚手架,并且经过了精良的工程设计和软件测试。
重要的是,Dify 是开源的,它由一个专业的全职团队和社区共同打造。你可以基于任何模型自部署类似 Assistants API 和 GPTs 的能力,在灵活和安全的基础上,同时保持对数据的完全控制。
我们的社区用户对 Dify 的产品评价可以归结为简单、克制、迭代迅速。 ——
希望以上信息和这份指南可以帮助你了解这款产品,我们相信 Dify 是为你而做的(Do It For You)。
Dify 能做什么?