
DeepSeek结合LlamaIndex构建RAG应用
《DeepSeek结合LlamaIndex构建RAG应用》共 0.4 万字,通篇围绕 向量、检索、RAG、LlamaIndex 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 一、概念介绍
- 二、llama_index 加载本地大模型
- 三、复现幻觉
- 四、使用 RAG
- 五、总结
- 1. LlamaIndex
- 2. RAG
- 索引(Indexing)
目录 · 3 节
前言
在大模型(如 GPT、LLaMA 等)快速发展的今天,生成式 AI 的能力已经令人惊叹,但其固有的 “幻觉问题” 仍然是一个重要挑战。大模型在生成文本时,可能会输出与事实不符、逻辑错误或无关的内容,这严重限制了其在关键场景(如问答系统、知识检索等)中的可靠性和实用性。
为了解决这一问题,检索增强生成(Retrieval-Augmented Generation, RAG) 技术应运而生。RAG 通过将大模型与外部知识库结合,在生成答案前先检索相关事实信息,从而显著提升生成内容的准确性和可信度。而 LlamaIndex 作为一个强大的工具,能够快速构建 RAG 系统,帮助开发者高效地将大模型与外部数据源(如文档、数据库)连接,实现更精准的知识检索与生成。
本次将通过 LlamaIndex,展示如何快速构建 RAG 系统,有效缓解大模型的幻觉问题,为生成式 AI 的应用提供更可靠的解决方案。
一、概念介绍
1. LlamaIndex
LlamaIndex 是一个开源框架,用于快速构建检索增强生成(RAG)应用。它可以帮助开发者将检索组件(如向量数据库)与语言生成模型(如 LLM)结合,高效地处理和检索文档数据,从而生成更准确、更有依据的内容
官方文档:https://docs.llamaindex.ai/en/stable/
中文文档:https://www.aidoczh.com/llamaindex/
2. RAG
RAG是一种用额外数据增强大语言模型知识的技术。
大语言模型可以对广泛的主题进行推理,但它们的知识仅限于训练时截止日期前的公开数据。如果你想构建能够对私有数据或模型截止日期后引入的数据进行推理的人工智能应用,你需要用特定信息来增强模型的知识。检索适当信息并将其插入模型提示的过程被称为检索增强生成(RAG)。
LangChain有许多组件旨在帮助构建问答应用,以及更广泛的RAG应用。
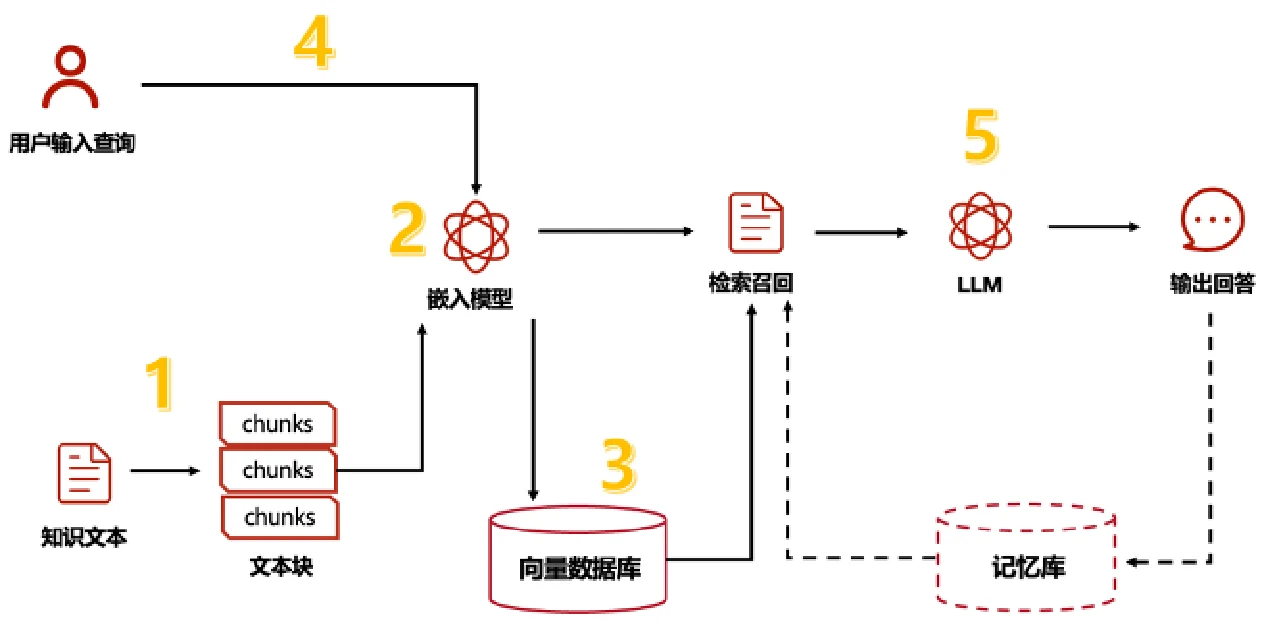
一个典型的RAG应用有两个主要组成部分:
索引(Indexing):从数据源获取数据并建立索引的管道(pipeline)。这通常在离线状态下进行。
检索和生成(Retrieval and generation):实际的RAG链,在运行时接收用户查询,从索引中检索相关数据,然后将其传递给模型。
从原始数据到答案的最常见完整顺序如下:
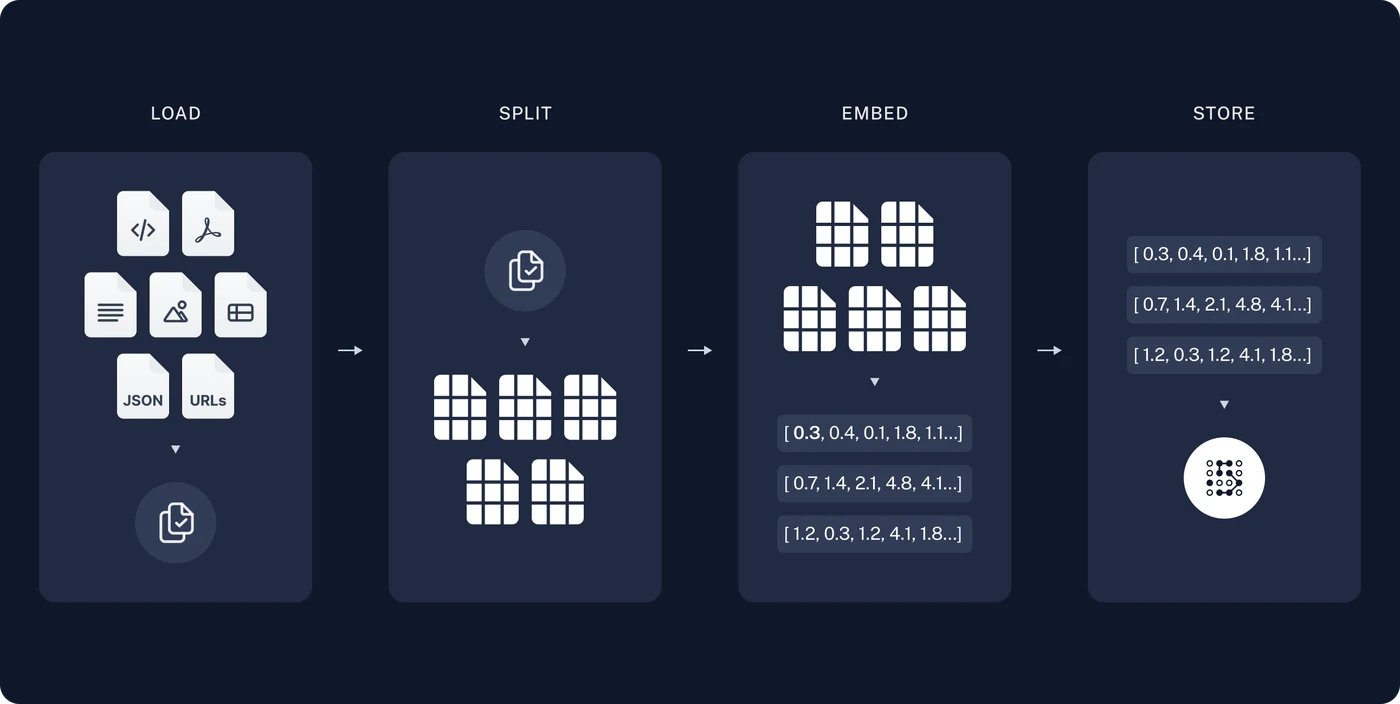
索引(Indexing)
- 加载(Load):首先我们需要加载数据。这是通过文档加载器Document Loaders完成的。
- 分割(Split):文本分割器Text splitters将大型文档(Documents)分成更小的块(chunks)。这对于索引数据和将其传递给模型都很有用,因为大块数据更难搜索,而且不适合模型有限的上下文窗口。
- 存储(Store):我们需要一个地方来存储和索引我们的分割(splits),以便后续可以对其进行搜索。这通常使用向量存储VectorStore和嵌入模型Embeddings model来完成。
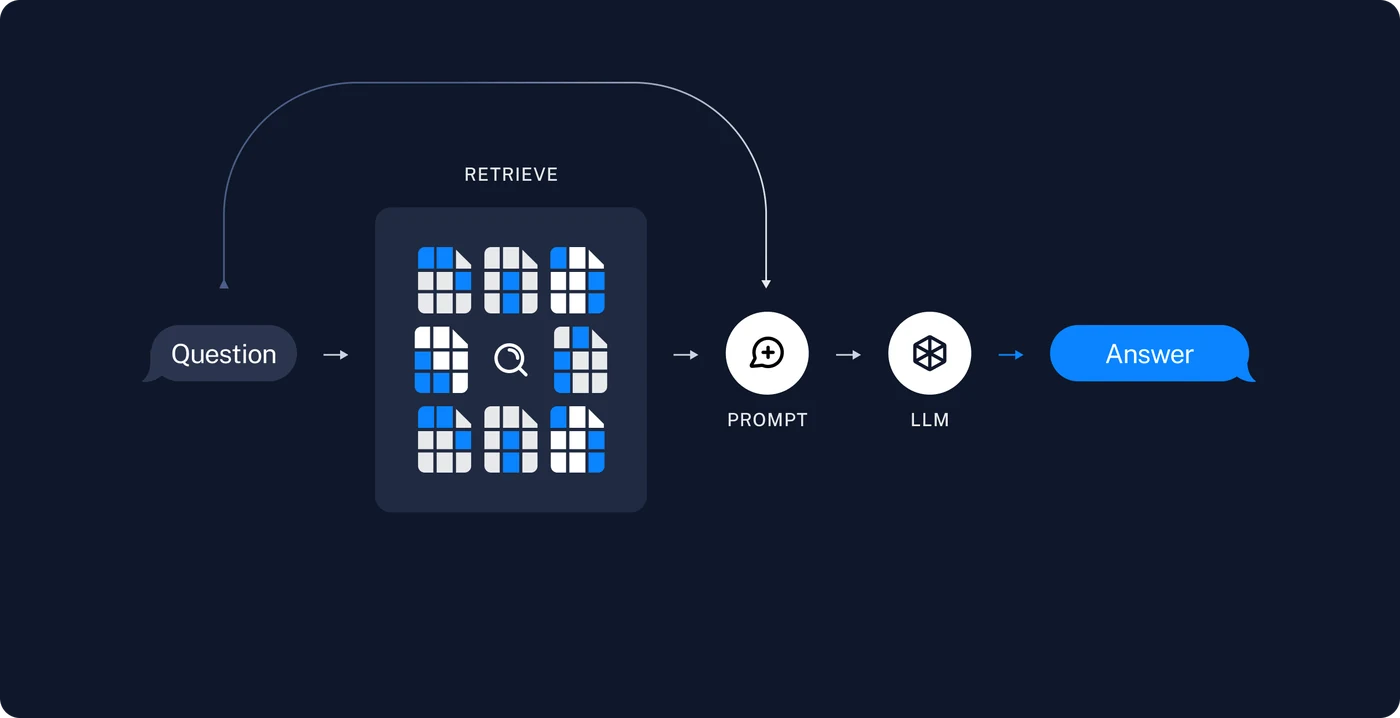
检索和生成(Retrieval and generation)
- 检索(Retrieve):给定用户输入,使用检索器Retriever从存储中检索相关的文本片段。
- 生成(Generate): ChatModel使用包含问题和检索到的数据的提示来生成答案。
3. 大模型幻觉
大模型幻觉是指大型语言模型生成看似合理但不符合事实或现实的内容的现象。这是由于模型基于概率生成内容,有时会编造或虚构信息,导致生成的结果与真实情况不符
二、llama_index 加载本地大模型
1. 下载大模型 (DeepSeek-R1)
下载一个 deepseek-R1 蒸馏过的模型,如果没有蒸馏的都非常大,也可以选参数量更大的,在魔塔社区下载就行。
#模型下载
from modelscope import snapshot_download
model_dir = snapshot_download('deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B')
2. 加载
使用 HuggingFaceLM 加载模型,问个简单问题
from llama_index.core.llms import ChatMessage
from llama_index.llms.huggingface import HuggingFaceLLM

#使用HuggingFaceLLM加载本地大模型
llm = HuggingFaceLLM(model_,
               tokenizer_,
               model_kwargs={"trust_remote_code":True},
               tokenizer_kwargs={"trust_remote_code":True})
#调用模型chat引擎得到回复
rsp = llm.chat(messages=[ChatMessage(content="你叫什么名字?")])