
详细说下RAG的流程
《详细说下RAG的流程》共 0.3 万字,通篇围绕 检索、RAG、向量、知识库 展开,归在「RAG 与知识库」这一层。
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(5 节)
- 答题思路
- **RAG流程详解**
- **技术挑战与优化方向**
- **示例场景**
- **总结回答**
答题思路
在面试中回答RAG(Retrieval-Augmented Generation)的流程时,建议从核心目标出发,结合具体步骤和技术细节,展现对整体架构和关键环节的理解。以下是分步说明:
首先,回忆一下RAG相关的知识,确保自己理解正确。RAG是Retrieval-Augmented Generation的缩写,也就是检索增强生成。它结合了检索和生成两种技术,用于提升模型生成回答的质量,特别是在需要外部知识的时候。
那么,RAG的基本流程应该包括几个步骤呢?首先,用户提出问题或输入一个查询,接下来系统需要从这个查询中提取关键信息,然后去检索相关的文档或数据,再把检索到的信息和原问题一起输入生成模型,最后生成回答。不过可能中间还有一些细节,比如预处理、检索策略、结果整合等。
通常RAG的流程可以分为三个主要阶段:检索阶段、增强阶段和生成阶段。或者可能更详细的分法。比如,用户输入处理、检索相关文档、文档处理、生成回答、后处理等。
在检索阶段,首先需要对用户的查询进行理解,可能包括关键词提取、实体识别、或者更复杂的语义分析,这样能更准确地检索相关文档。然后,系统会使用某种检索方法,比如基于密集向量的检索(如用BERT这样的模型生成嵌入向量),或者传统的BM25算法,从大型文档库中找到最相关的段落或文档。
接下来,在增强阶段,检索到的文档会被处理,可能包括去重、排序、截断,或者提取关键信息,然后和原问题一起输入到生成模型中。生成模型通常是像GPT这样的自回归模型,它根据原问题和检索到的信息生成最终的回答。
不过,可能还有一些步骤需要注意,比如在检索前对文档库的预处理,比如建立索引,这样检索的时候可以快速找到相关文档。另外,生成后的结果可能需要进行后处理,比如去除重复内容、格式化、或者验证事实准确性等。
有没有可能我遗漏了什么步骤?比如,用户输入的处理可能不仅仅是简单的关键词提取,还需要进行意图识别或者查询扩展,以提高检索效果。例如,当用户的问题比较模糊时,系统可能需要生成多个相关的查询来检索更多相关文档。
另外,在检索阶段,可能还会涉及多模态的数据,比如文本、图片等,但通常RAG主要处理文本信息。不过具体情况可能因应用而异。
生成阶段需要注意,如何将检索到的信息有效地整合到生成过程中。比如,可能需要对多个文档的信息进行综合,或者解决信息冲突的问题。此外,生成模型需要有足够的能力理解检索到的内容,并生成连贯、准确的回答。
在模型训练方面,RAG可能需要联合训练检索器和生成器,或者分别训练。比如,Facebook的原始RAG模型是联合训练的,但后来有些实现可能分开训练,比如用现成的检索模型和生成模型组合。
还需要考虑评估RAG系统的方法,比如如何衡量检索到的文档的相关性,生成回答的质量,以及整个系统的效率。不过这个问题可能不需要在流程中详细说明,但了解评估方法有助于理解流程的设计考虑。
现在,整理一下思路:
- 用户输入处理:解析查询,可能进行意图识别、实体识别、查询扩展等。
- 文档检索:使用检索方法从文档库中找到相关段落,可能需要预处理和索引。
- 文档处理:对检索结果进行排序、去重、截断或摘要。
- 信息整合:将处理后的文档和原查询结合,输入生成模型。
- 生成回答:生成模型产生回答,可能包括多步推理。
- 后处理:对生成的回答进行格式化、去重、事实校验等。
可能还需要提到各个步骤中的技术细节,比如检索使用的模型,生成模型的选择,如何处理多文档信息等。此外,可以举例子或者具体技术,比如用BERT做检索,用GPT-3生成,或者使用FAISS进行向量检索加速。
有没有可能漏掉了反馈循环?比如用户对生成的回答进行反馈,系统根据反馈优化检索或生成,但这可能属于系统迭代部分,不属于基础流程。
总结一下,RAG流程的核心是检索+生成,重点在于如何有效地从外部知识库中获取相关信息,并利用这些信息辅助生成模型产生更准确的回答。需要详细说明每个步骤的目的和常用技术,以及它们如何协同工作。
RAG流程详解
RAG通过结合检索(从外部知识库获取信息)和生成(利用大模型生成回答)来提升模型输出的准确性和相关性。其流程可分为以下核心阶段:
RAG是一种用额外数据增强大语言模型知识的技术。
大语言模型可以对广泛的主题进行推理,但它们的知识仅限于训练时截止日期前的公开数据。如果你想构建能够对私有数据或模型截止日期后引入的数据进行推理的人工智能应用,你需要用特定信息来增强模型的知识。检索适当信息并将其插入模型提示的过程被称为检索增强生成(RAG)。
LangChain有许多组件旨在帮助构建问答应用,以及更广泛的RAG应用。
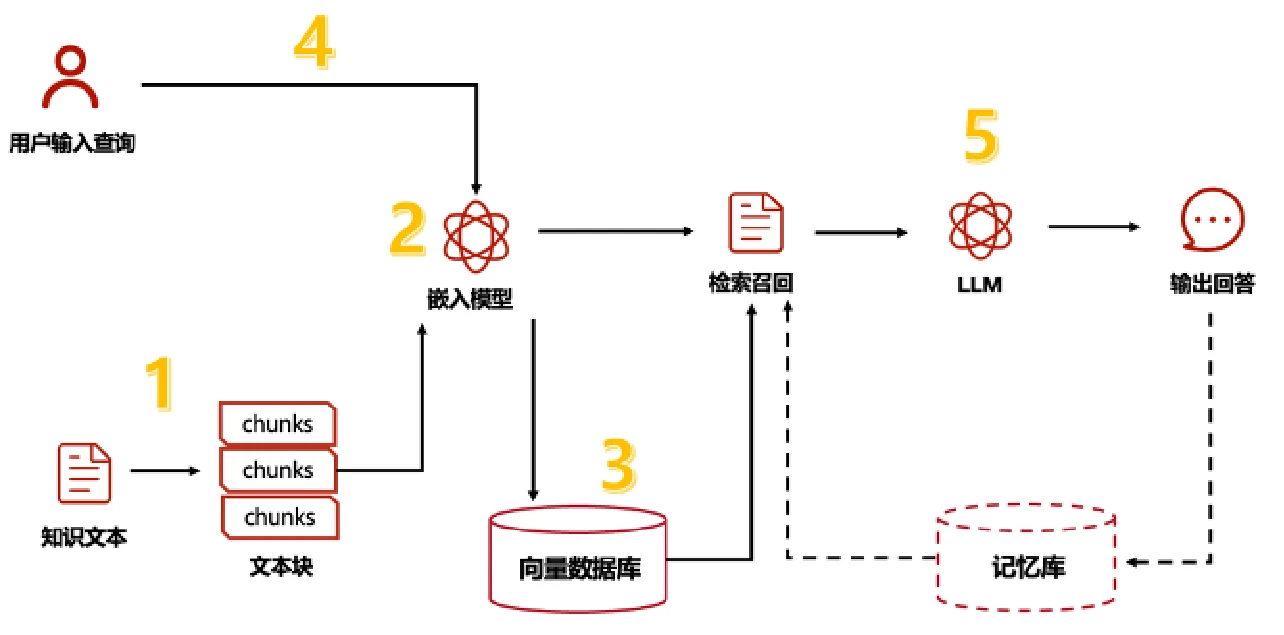
一个典型的RAG应用有两个主要组成部分:
索引(Indexing):从数据源获取数据并建立索引的管道(pipeline)。这通常在离线状态下进行。