为什么选择向量数据库,而不是传统数据库
《为什么选择向量数据库,而不是传统数据库》共 0.3 万字,通篇围绕 向量、数据库、检索、场景 展开,归在「RAG 与知识库」这一层。
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(8 节)
- 答题思路
- **一、本质差异:数据结构与处理能力的适配性**
- **二、技术优势:性能与扩展性**
- **三、应用场景与大模型落地的关键支撑**
- **四、行业趋势与生态成熟度**
- **五、回答示例(结构化表达)**
- **补充建议**
- **总结回答**
答题思路
在面试中回答“为什么选择向量数据库而非传统数据库”时,建议从以下几个核心角度切入,结合大模型应用开发的场景需求,突出向量数据库的独特价值和行业趋势:
一、本质差异:数据结构与处理能力的适配性
二、技术优势:性能与扩展性
三、应用场景与大模型落地的关键支撑
四、行业趋势与生态成熟度
一、本质差异:数据结构与处理能力的适配性
- 数据类型兼容性 传统数据库(如MySQL、Oracle)擅长处理结构化数据(表格、字段),但大模型应用中大量涉及非结构化数据(文本、图像、音频、视频)。 向量数据库通过Embedding技术将非结构化数据转化为高维向量,直接存储向量表示,天然适配AI模型的数据处理需求。例如,将一段文本转化为768维向量后,传统数据库无法有效存储和检索,而向量数据库能直接处理这类数据。
- 相似性搜索的高效性 传统数据库依赖精确匹配(如WHERE语句),而大模型应用常需基于语义相似性检索(如“推荐相似商品”“查找相关文档”)。 向量数据库通过近似最近邻(ANN)算法(如HNSW、IVF-PQ),支持快速计算向量间的余弦相似度或欧氏距离,实现毫秒级响应。例如,用户提问“如何优化代码性能”,向量库能快速匹配“代码优化技巧”“性能调优案例”等语义相近内容,传统数据库则无法做到。
特征和向量
虽然向量数据库的核心在于相似性搜索 (Similarity Search),但在深入了解相似性搜索前,我们需要先详细了解一下特征和向量的概念和原理。
我们先思考一个问题?为什么我们在生活中区分不同的物品和事物?
如果从理论角度出发,这是因为我们会通过识别不同事物之间不同的特征来识别种类,例如分别不同种类的小狗,就可以通过体型大小、毛发长度、鼻子长短等特征来区分。如下面这张照片按照体型排序,可以看到体型越大的狗越靠近坐标轴右边,这样就能得到一个体型特征的一维坐标和对应的数值,从 0 到 1 的数字中得到每只狗在坐标系中的位置。
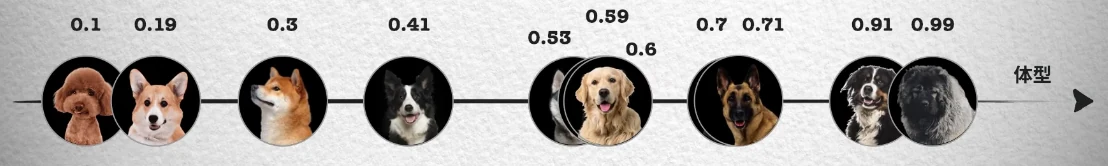
然而单靠一个体型大小的特征并不够,像照片中哈士奇、金毛和拉布拉多的体型就非常接近,我们无法区分。所以我们会继续观察其它的特征,例如毛发的长短。
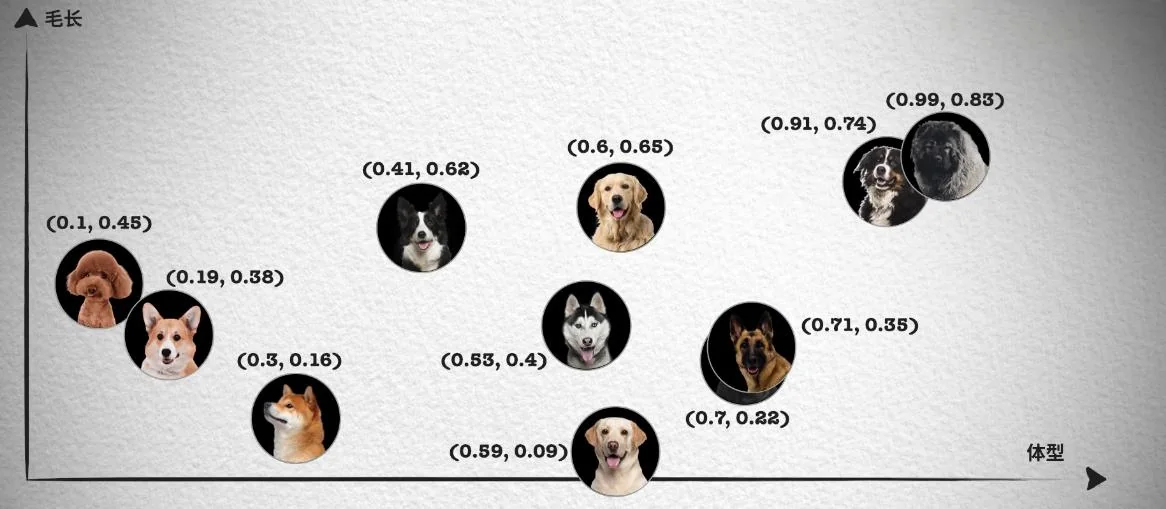
这样每只狗对应一个二维坐标点,我们就能轻易的将哈士奇、金毛和拉布拉多区分开来,如果这时仍然无法很好的区分德牧和罗威纳犬。我们就可以继续再从其它的特征区分,比如鼻子的长短,这样就能得到一个三维的坐标系和每只狗在三维坐标系中的位置。
在这种情况下,只要特征足够多,就能够将所有的狗区分开来,最后就能得到一个高维的坐标系,虽然我们想象不出高维坐标系长什么样,但是在数组中,我们只需要一直向数组中追加数字就可以了。
实际上,只要维度够多,我们就能够将所有的事物区分开来,世间万物都可以用一个多维坐标系来表示,它们都在一个高维的特征空间中对应着一个坐标点。
那这和相似性搜索 (Similarity Search) 有什么关系呢?你会发现在上面的二维坐标中,德牧和罗威纳犬的坐标就非常接近,这就意味着它们的特征也非常接近。我们都知道向量是具有大小和方向的数学结构,所以可以将这些特征用向量来表示,这样就能够通过计算向量之间的距离来判断它们的相似度,这就是相似性测量。
相似性测量 (Similarity Measurement),上面我们讨论了向量数据库的不同搜索算法,但是还没有讨论如何衡量相似性。在相似性搜索中,需要计算两个向量之间的距离,然后根据距离来判断它们的相似度。
而如何计算向量在高维空间的距离呢?有三种常见的向量相似度算法:欧几里德距离、余弦相似度和点积相似度。
欧几里得距离
欧几里得距离(Euclidean Distance)是用于衡量两个点(或向量)之间的直线距离的一种方法。它是最常用的距离度量之一,尤其在几何和向量空间中。可以将其理解为两点之间的“直线距离”。
其中,A 和 B 分别表示两个向量,n 表示向量的维度。
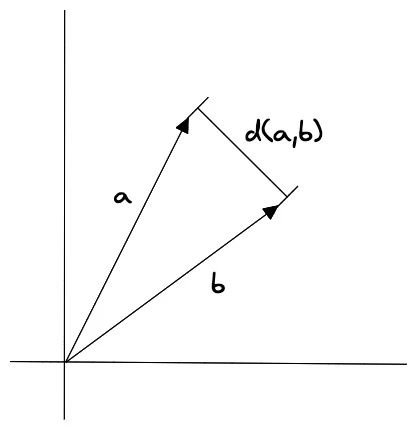
欧几里得距离算法的优点是可以反映向量的绝对距离,适用于需要考虑向量长度的相似性计算。例如推荐系统中,需要根据用户的历史行为来推荐相似的商品,这时就需要考虑用户的历史行为的数量,而不仅仅是用户的历史行为的相似度。
余弦相似度
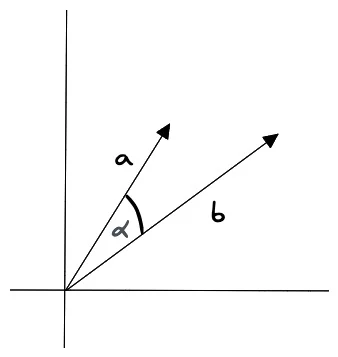
余弦相似度(Cosine Similarity)是一种用于衡量两个向量之间相似度的指标。它通过计算两个向量夹角的余弦值来判断它们的相似程度。其值介于 -1 和 1 之间,通常用于文本分析和推荐系统等领域。