
DeepSeek开源Day1:FlashMLA技术详解
《DeepSeek开源Day1:FlashMLA技术详解》共 0.3 万字,通篇围绕 Attention、显存、缓存、GPU 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 1 FlashMLA 简介
- 2 FlashMLA 的关键技术与未来优化
- 4 FlashMLA 微架构分析
- 5 FlashMLA 的价值与意义
- 3.1 Memory Bound 与 I0-Awareness
- 3.2 Flash Attention
- 3.3 MLA
- 4.1 FlashMLA 核心技术
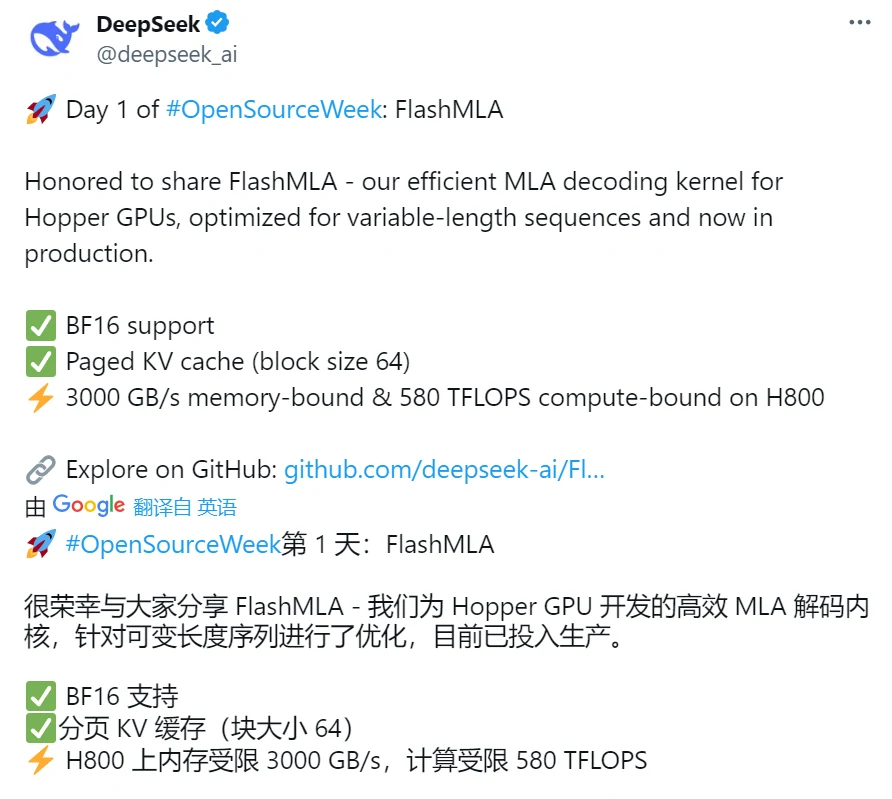
2 月 24 日,DeepSeek 启动 “开源周”,首个开源的代码库为 FlashMLA。DeepSeek 这种挤牙膏式的宣推手段也是很有意思,看来梁文锋团队不仅仅是技术派,也擅长玩技术流量 IP。
1 FlashMLA 简介
FlashMLA 是由 depseek-ai (深度求索)开发的一个开源项目,针对 Hopper 架构 GPU(例如 H100 或 H800)的高效的 MLA 推断(Inference)解码内核,旨在加速 MLA 机制的计算,特别适用于 DeepSeek 系列模型(如 DeepSeek-V2、V3 和 R1)。
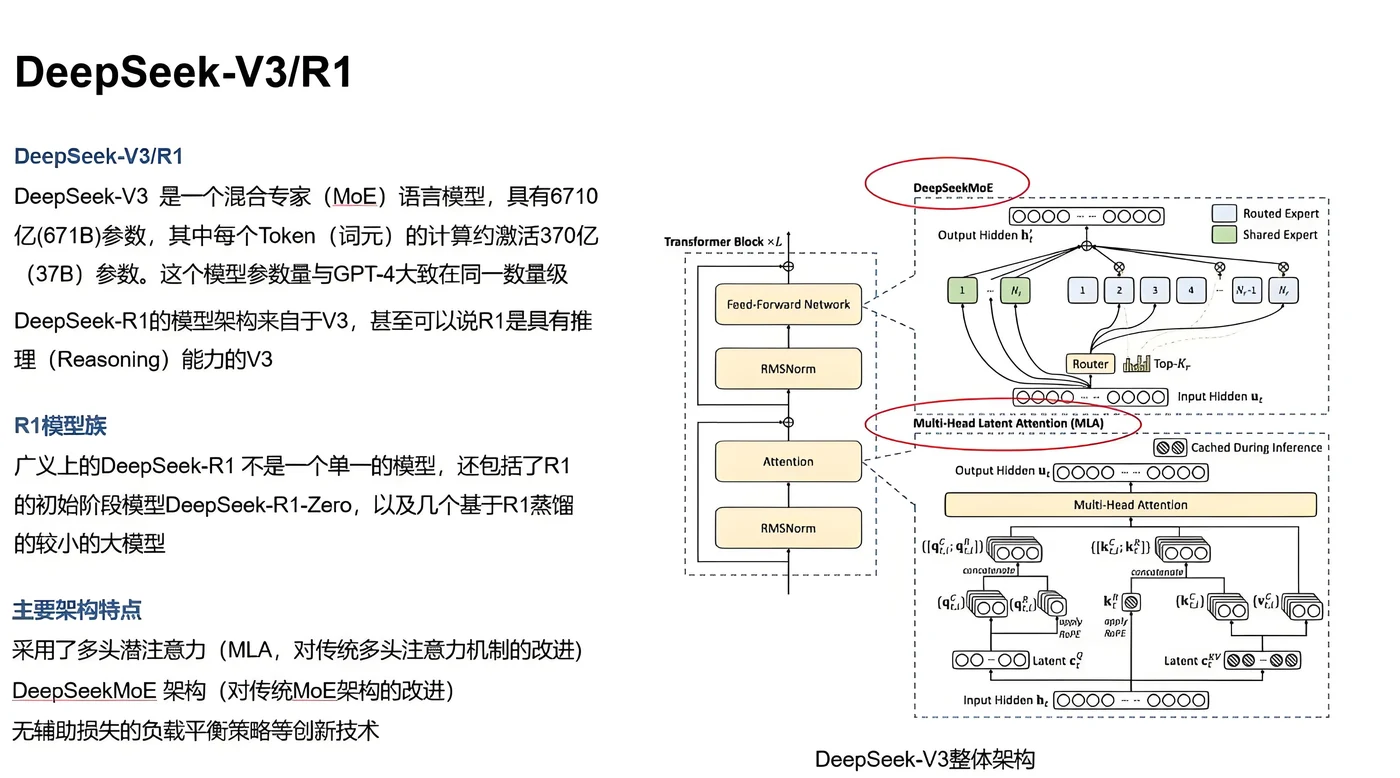
DeepSeek V3/R1 介绍(来源:中存算半导体)
其中 MLA 是 DeekSeek 研发的多头潜注意力(Multi-head Latent Attention)机制。通过低秩矩阵压缩 KV Cache(键值缓存),减少内存占用,同时提升模型性能。
FlashMLA 借鉴 FlashAttention 分块 Tiling 和显存优化的思想。通过以算代存减少对于显存带宽的要求,提升计算性能。FlashMLA 的构建基于 Cutlass 和 CUDA 体系。
FlashMLA 主要用于大模型推断 / 推理(Inference),特别是在需要处理长序列的场景中,如聊天机器人或代码生成工具。通过优化 GPU 利用率,解决大模型在推理阶段的显存瓶颈问题。
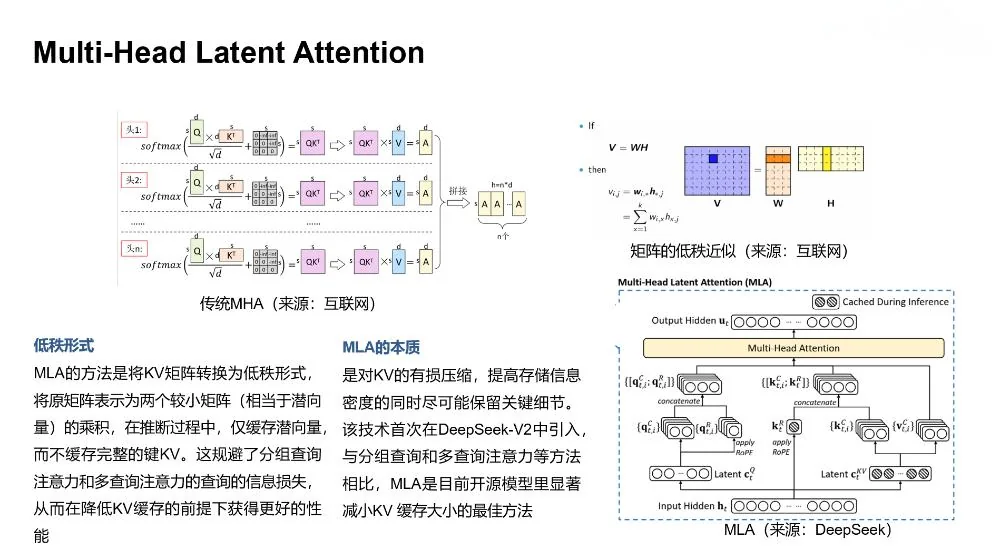
2 FlashMLA 的关键技术与未来优化
FlashMLA 是 MLA 技术和 Flash Attention 技术的结合,可以认为是 Flash Attention 的 MLA 版本。
FlashMLA 具有以下关键特征:
1)Flash MLA 支持变长序列和分页 KV 缓存。
2)基于 BF16 格式(FP16 也发布了)和至少 12.3 以上的 CUDA。
3)支持 Hopper 架构的 TMA 优化。
4)可显著提升 KV Cache 性能和 GPU 计算性能。在 H800 SXM5 上,可达 3000 GB/s 的计算带宽(接近 3.35TB/s 的理论峰值)。
5)开源版本暂不支持反向传播计算。
6)使用 MIT 许可证便于社区协作。
Hopper GPU 架构参考文章: https://zhuanlan.zhihu.com/p/487250706
FlashMLA 未来可能的优化方向包括: