
DeepSeek开源Day2:DeepEP技术详解
《DeepSeek开源Day2:DeepEP技术详解》共 0.2 万字,通篇围绕 GPU、MoE、延迟、架构 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(7 节)
- 1 DeepEP 简介
- 2 DeepEP 的关键技术与未来优化
- 3 DeepEP 的原理与架构
- 4 DeepEP 代码结构分析
- 5 DeepEP 的未来优化
- 3.1 从英伟达集群到 All-to-All 通信
- 3.2 DeepEP 架构
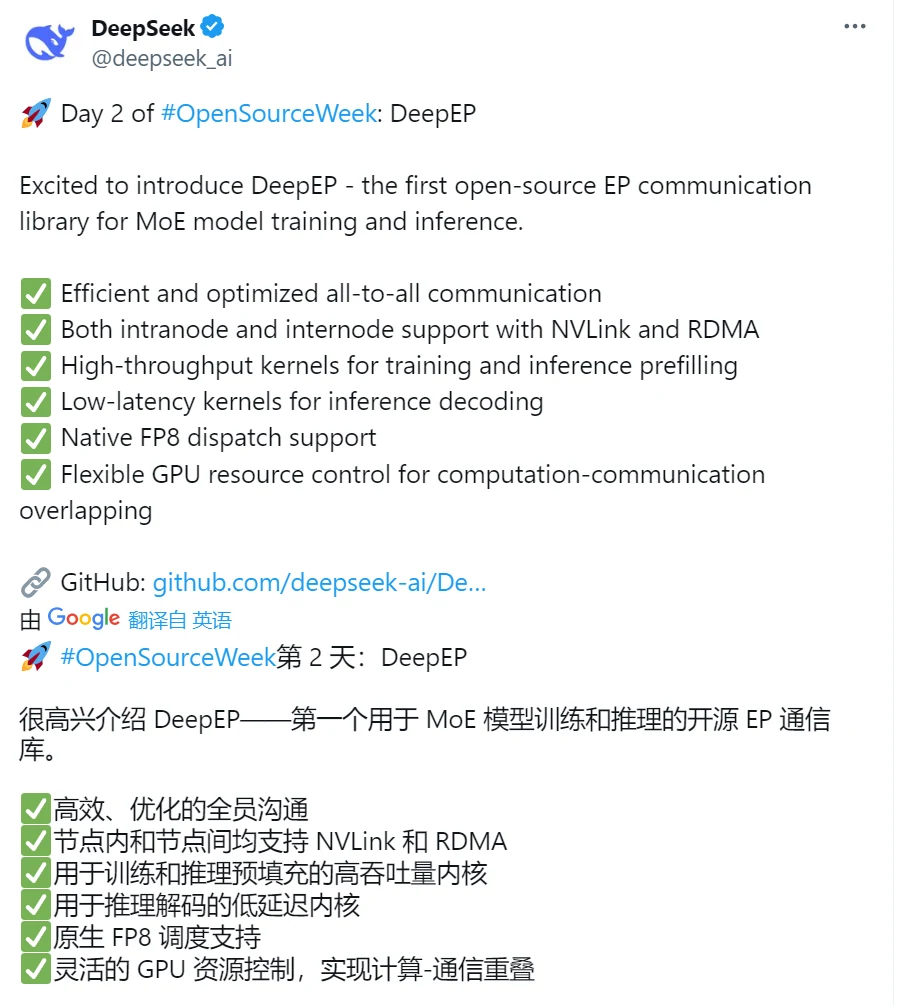
2 月 24 日,DeepSeek 启动 “开源周”,第二个开源的代码库为 DeepEP。很好,又挤了一段有硬件基因的牙膏出来。H100/H800 绝对是 DeepSeek 的小心肝。
1 DeepEP 简介
DeepEP 是由 deepseek-ai (深度求索)开发的一个开源项目。DeepEP 针对混合专家(MoE)+ 专家并行(EP)模型架构设计的通信库。MoE 是由多个专家子网络组成的大模型,通过门控网络决定输入分配给哪个专家。
DeepEP 提供高吞吐量和低延迟的 all-to-all GPU 内核,包括 MoE 分发(dispatch)和合并(combine)。该库支持 FP8 等低精度运算,特别适用于 DeepSeek 系列模型(如 DeepSeek-V2、V3 和 R1)。
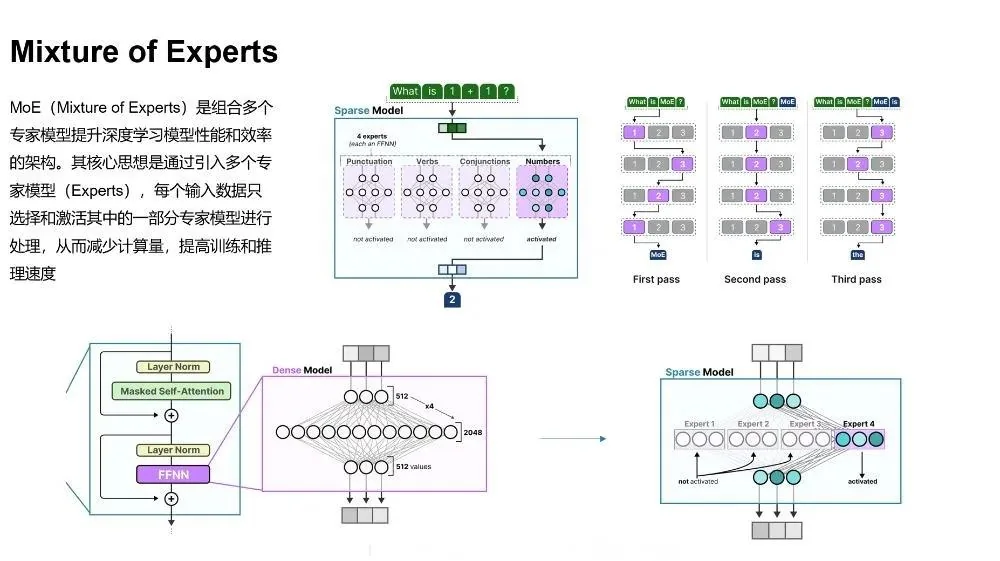
MoE 介绍(来源:中存算半导体)
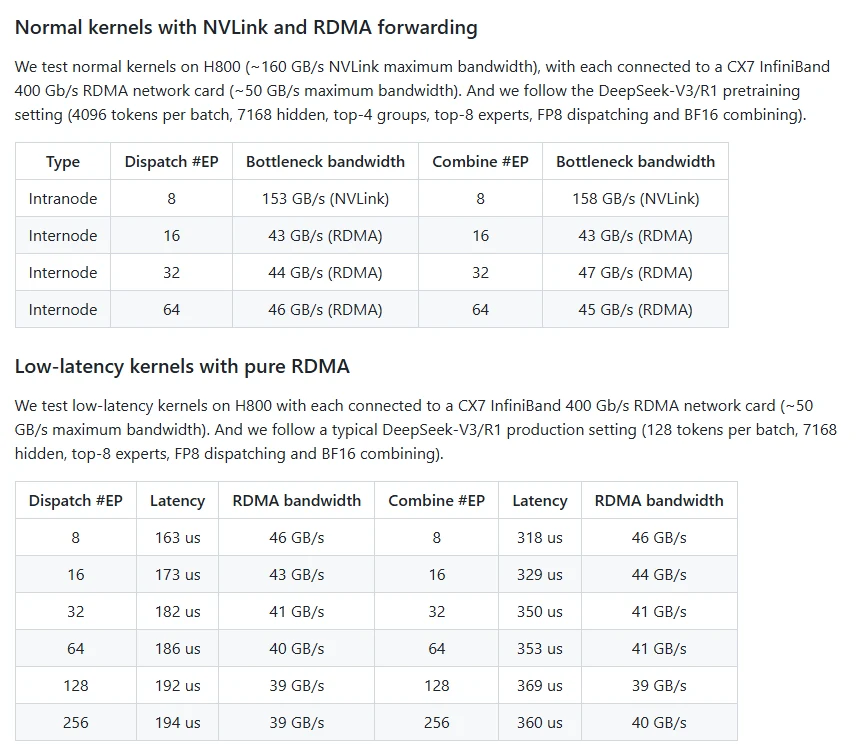
为了与 DeepSeek-V3 论文中的组限制门控算法(group-limited gating algorithm)保持一致,DeepEP 针对非对称域带宽转发设计和优化通信内核(例如将数据从 NVLink 域转发到 RDMA 域)并提供高吞吐量,使其适用于训练和推理预填充任务。
DeepEP 主要适用于大模型训练,特别是需要 EP 的集群训练。通过提升通信信道的使用率,提升训练效率。
DeepEP 的安装要求如下:
1)Hopper 架构 GPU(看出来 DeepSeek 对 H 是真爱)
2)Python 3.8 或更高版本
3)CUDA 12.3 或更高版本
4)PyTorch 2.1 或更高版本
5)NVLink 与 RDMA(DeepEP 已通过 InfiniBand 网络的测试,并未在 RDMA 完全测试)
2 DeepEP 的关键技术与未来优化
DeepEP 具备以下关键技术:
1)高吞吐量、低延迟的 all-to-all GPU 内核,专门优化的分派和组合操作。确保数据在多个 GPU 之间快速传输,减少通信时间。
2)支持低比特操作,如 FP8 格式,显著降低计算和存储需求,提升整体效率。
3)针对非对称域带宽转发(如从 NVLink 域到 RDMA 域),提供优化内核,适合训练和推理 Prefill 任务。允许直接内存访问,减少 CPU 介入。DeepEP 的优化确保数据在不同域之间高效传输,特别适用于大规模混合卡的分布式训练。
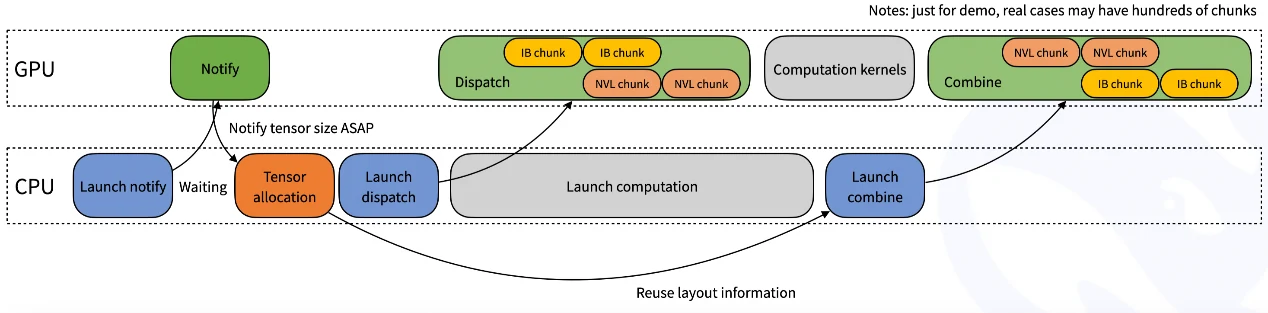
CPU 等待 GPU 接收计数信号(来源:DeepSeek)
3 DeepEP 的原理与架构
3.1 从英伟达集群到 All-to-All 通信
V3/R1 的训练框架定制了高效的跨节点 All-to-All 通信内核,以充分利用 IB 和 NVLink 带宽,并节约流式多处理器(SM,(Stream Multiprocessor)。
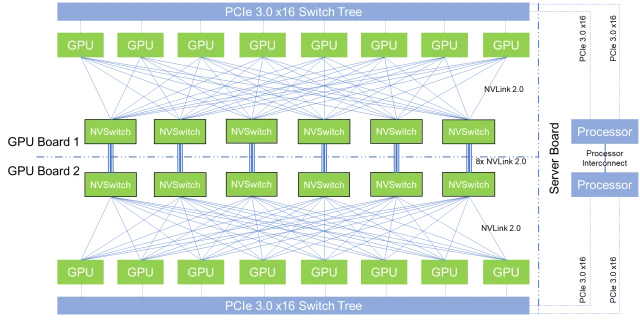
传统的基于 NVSwitch 的 All-to-All 通信结构(来源:互联网)
通信内核(通信 SM 控制代码)的实现与 MoE 门控算法和集群网络拓扑是按照软硬件协同的思路来进行设计的。具体来说,在集群中,跨节点 GPU 与 IB 完全互连,节点内(单台服务器内)通信通过 NVLink 完成。NVLink 提供 160 GB/s 的带宽,约是 IB 的 3.2 倍 (50 GB/s)。