DeepSeek开源Day4:DualPipe&EPLB技术详解
《DeepSeek开源Day4:DualPipe&EPLB技术详解》共 0.3 万字,通篇围绕 GPU、MoE、架构、部署 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 1 DualPipe 与 EPLB 简介
- 2 DualPipe 与 EPLB 架构分析
- 3 DualPipe 与 EPLB 代码结构分析
- 4 DualPipe 与 EPLB 的现状与未来
- 1.1 DualPipe 核心特点
- 1.2 EPLB 核心特点
- 2.1 DualPipe 架构
- 2.2 EPLB 架构
2 月 24 日,DeepSeek 启动 “开源周”,第四个开源的代码库为 DualPipe 与 EPLB(一下发布了两个)。DualPipe 与 EPLB 依然使用了大量与 Hopper 架构绑定的技术。
DualPipe 是由 DeepSeek-AI 团队开发的一种双向流水线并行通信算法,主要用于优化大模型(如 DeepSeek-V3/R1)的数据交互和训练效率。
EPLB (Expert Parallelism Load Balancer,专家并行负载均衡器)则主要用于优化混合专家模型(MoE)的分布式部署,特别是在 DeepSeek-V3 和 DeepSeek-R1 等大规模语言模型的训练中。
DualPipe 负责提升通信效率,确保信道均衡;EPLB 则负责优化专家副本分配,确保不同 GPU 节点的负载均衡。
相对前两天的 FlashMLA 和 DeepGEMM,DualPipe 与 EPLB 更多偏向于工程优化。当然这两者的工程优化也不是大部分团队可以做的。需要对信道优化和推断集群部署有很强的软硬件综合优化能力。
1 DualPipe 与 EPLB 简介
1.1 DualPipe 核心特点
DualPipe 具有以下核心特点:
1)计算与通信重叠DualPipe 的设计目标是最大化集群设备的计算性能,通过在前向传播(Forward)和后向传播(Backward)阶段实现计算与通信的完全重叠,显著减少传统流水线并行中的 “气泡”(Pipeline Bubble,即空闲等待时间)。这对于需要跨节点协作的专家并行(Expert Parallelism)场景尤为重要。
2)双向调度与传统的单向流水线并行不同,DualPipe 采用双向调度策略,从流水线的两端同时输入微批次(Micro-batches),充分利用硬件资源。这种方法在保持计算通信比例恒定的情况下,即使模型规模进一步扩大,也能维持接近零的通信开销。
3)高效扩展性DualPipe 针对跨节点的混合专家模型(MoE)进行了优化,通过减少通信瓶颈,使得大规模分布式训练能够在相对有限的硬件资源(如 H800 GPU)上高效运行。
4)显存优化DualPipe 将模型的最浅层(包括嵌入层)和最深层(包括输出层)部署在同一流水线级别(PP Rank),实现参数和梯度的物理共享,进一步提升内存效率。这种设计减少了高代价的张量并行(Tensor Parallelism)需求。
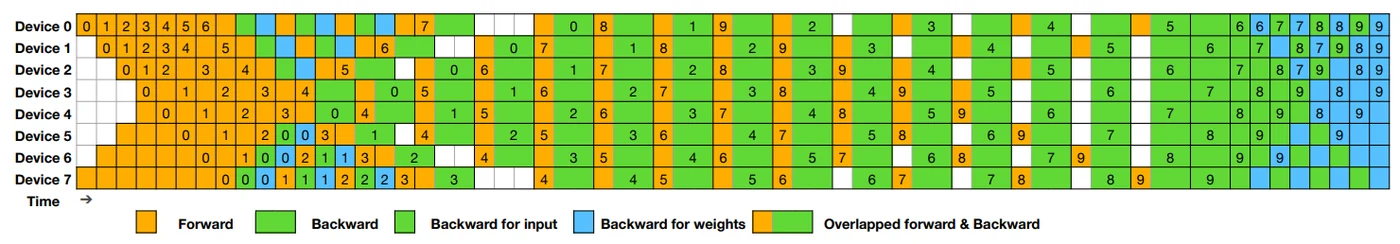
DualPipe 优化(来源:DeepSeek)
1.2 EPLB 核心特点
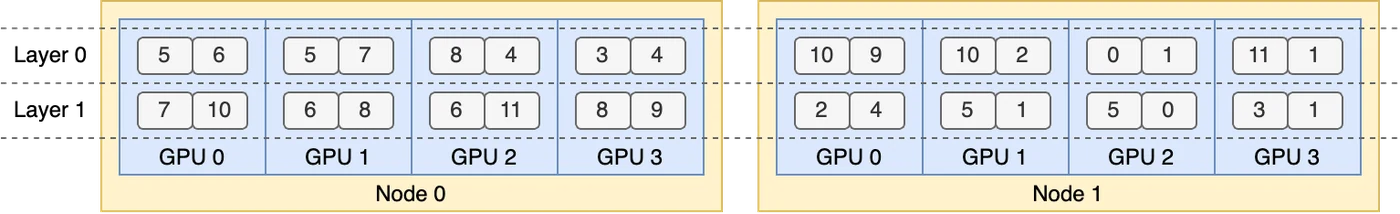
为保证 MoE 部分不同专家之间的负载均衡,会将共享专家和高负载的细粒度专家在集群的不同 GPU 做多个复制,让 GPU 把更多的热数据(发给共享专家的)跑起来。这个方案就是 EPLB。
EPLB 具有如下核心特点:
1)负载均衡优化EPLB 通过复制高负载专家(Redundant Experts Strategy)并对专家分配进行启发式调整,确保不同 GPU 之间的负载均衡。这种方法解决了专家并行中因专家负载不均导致的计算资源浪费问题。分层负载平衡策略也可用于预填充阶段,具有较小的专家并行规模。
2)跨节点通信优化在 DeepSeek-V3 的技术报告中提到,EPLB 尝试将同一组的专家尽量分配到同一节点,减少跨节点的数据传输开销。这种分组限制路由(Group-Limited Expert Routing)策略显著提升了分布式训练的效率。
3)高效可扩展性EPLB 支持灵活的专家复制和分配,能够适配不同规模的模型和硬件配置。例如,在一个包含 2 个节点、每个节点 4 个 GPU 的集群上,EPLB 可以动态规划 16 个个专家副本的分配。