
DeepSeek背后核心技术揭秘
《DeepSeek背后核心技术揭秘》共 0.5 万字,通篇围绕 架构、MoE、GPU、推理 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(6 节)
- 2.1.1 DeepSeek MoE
- 2.1.2 MLA 多头潜在注意力
- 2.2.3 用于 FP8 训练的混合精度框架
- 2.2.4 MTP 的训练目标
- 2.2.5 推理部署方案
- 总结:为什么 DeepSeekV3 训练成本这么低?
探讨 DeepSeek 大模型的核心技术,从公司背景、模型能力、训推成本到核心技术细节进行了全面分析。
一、关于 DeepSeek 公司及其大模型
1.1 公司概况
DeepSeek 2023 年 7 月成立于杭州,是幻方量化旗下的子公司,全称是杭州深度求索人工智能基础技术研究有限公司。
"成立时间才一年多"、"最近推出的 V3 已经能和 OpenAI 的 4o 媲美"、"训练成本不到 600W 美元"、"API 定价仅是国内其他头部厂商几十分之一"、"APP 已经在中美 APP store 登上免费应用榜首";
以上是最近关于 DeepSeek 的一些新闻热点信息,下面我们从官网看下:
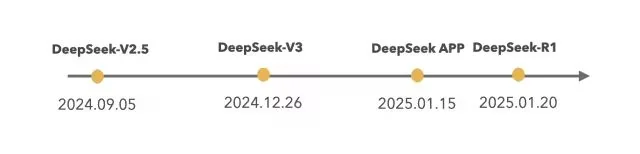
DeepSeek 近半年相继推出了 3 个主要的大模型版本,分别是 DeepSeek V2.5、DeepSeek V3、DeepSeek-R1(无一例外的都是用了 MOE 架构)。在这之前还推出了 DeepSeek-VL、DeepSeek Coder、DeepSeek Math。
1.2 模型能力
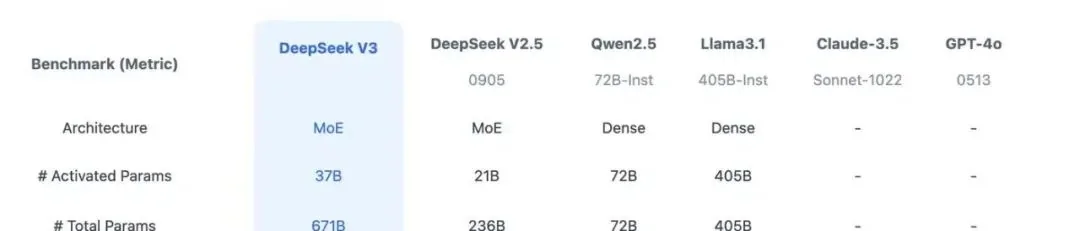
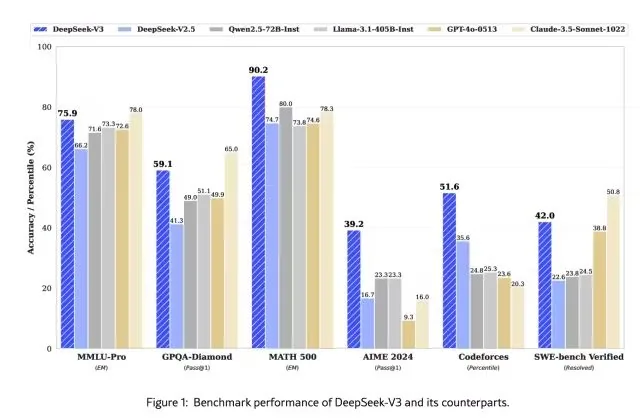
DeepSeek 模型已经对标国内 Qwen、海外 Llama、GPT 4o,从公布的榜单评测上看:DeepSeek-V3 在开源模型中位列榜首,与世界上最先进的闭源模型不分伯仲。
1.3 训推成本
推理成本 (API 报价):百万 Token 输入价格能达到 1 元。
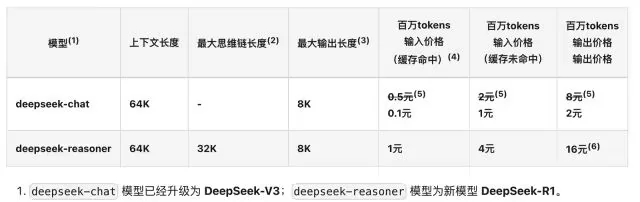
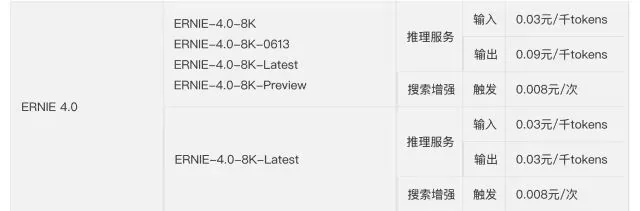
训练成本:从技术报告中看 DeepSeek 用的是 H800 的 GPU 做的训练,而且只有 2 千张左右的 H800,整个 V3 的正式训练成本不超过 600W 美元。
1、预训练阶段,每万亿的 Token 训练 V3 使用 2048 个 H800GPU 集群,只需要 180K 个 H800 GPU 小时,大概 3.7 天 (180000/2048/24)
2、整个预训练总耗时 2664K GPU 小时(不到 2 个月),加上 上下文扩展和后训练,总耗时大概 2788KGPU 耗时。
3、按照 H800 每小时 2 美元租赁,总的训练成本不超过 600W 美元
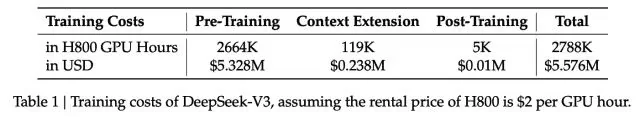
DeepSeek-V3 Technical Report
这么低的推理和训练成本不由引出以下的问题:
模型采用了什么样的网络架构?
训练的精度、框架和并行策略是怎样的?
模型的部署和优化方案是怎样的?
在硬件层的计算和通信上做了什么优化?
二、DeepSeek 训推核心技术
2.1 DeepSeek-V3 模型网络架构
DeepSeekV3 整体预训练用了 14.8 万亿的高质量 Token,并且在后期做了 SFT 和 RL,模型参数量达到 671B,但是每个 Token 仅激活 37B 参数。为了做到高效的推理和训练,DeepSeekV3 自研了 MLA 注意力机制和无辅助损失负载均衡策略的 MoE 架构。
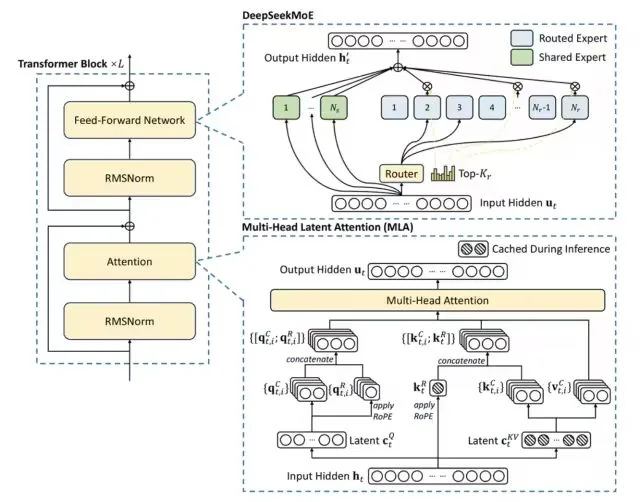
从技术报告中看出,是经典的 Transformer 架构,比较亮眼的就是前馈网络使用的 DeepSeekMoE 架构、Attention 机制使用 MLA 架构,其实这两个在 DeepSeekV2 模型已经被验证使用过。
与 DeepSeek-V2 相比,V3 额外引入了一种无辅助损失的负载均衡策略,用于 DeepSeekMoE,以减轻因需要保证 Expert 负载均衡而导致的性能下降。
2.1.1 DeepSeek MoE
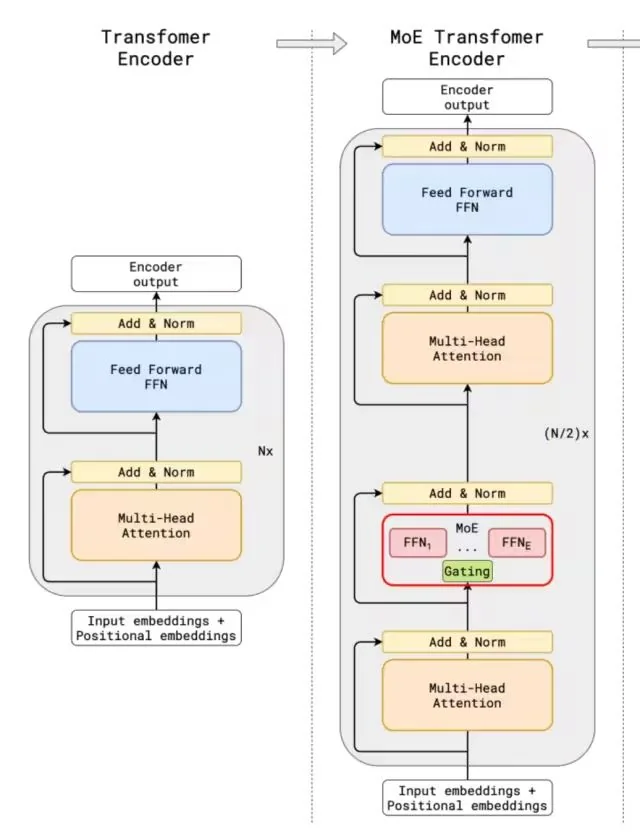
第一个将 MoE 架构引入 Transformer 网络的就是 GShard 架构了,与传统大模型架构相比,MoE 架构在数据流转过程中集成了一个专家网络层。
可以看出传统的 MoE 基本两部分组成:Gating 门控网络、稀疏 MoE 层;
●稀疏 MoE 层: 这些层代替了传统 Transformer 模型中的前馈网络 (FFN) 层。MoE 层包含若干 “专家”(例如 8 个),每个专家本身是一个独立的神经网络。在实际应用中,这些专家通常是前馈网络 (FFN),但它们也可以是更复杂的网络结构,甚至可以是 MoE 层本身,从而形成层级式的 MoE 结构。
●门控网络或路由: 这个部分用于决定哪些 Token 被发送到哪个专家。Token 的路由方式是 MoE 使用中的一个关键点,因为路由器由学习的参数组成,并且与网络的其他部分一同进行预训练。
和传统的 MoE 架构相比,DeepSeekMoE 使用更细粒度的专家,并将一些专家隔离为共享专家,减少专家间的知识冗余。
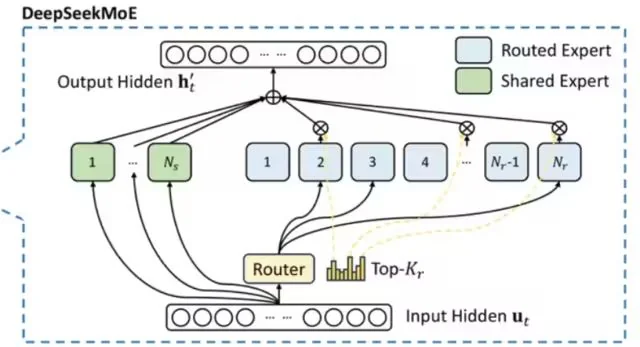
门控网络路由策略:TopK 表示第 t 个 Token 和所有路由专家计算出的亲和力分数中 K 个最高分数的集合,在 DeepSeekV3 中,使用 sigmoid 函数计算亲和力分数,然后在所有选择的亲和力分数中应用归一化来生成门控值。