RAG项目优化最佳实践
《RAG项目优化最佳实践》共 0.5 万字,通篇围绕 召回、RAG、检索、场景 展开,归在「RAG 与知识库」这一层。
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(8 节)
- 知识处理优化
- 知识加载
- 切片 Chunk 尽量保持完整
- 多元化的信息抽取
- 知识处理工作流
- 静态知识 RAG 优化
- 动态知识 RAG 优化
- 运维智能体背景
目录 · 3 节
背景
在过去两年中,检索增强生成(RAG,Retrieval-Augmented Generation)技术逐渐成为提升智能体的核心组成部分。通过结合检索与生成的双重能力,RAG 能够引入外部知识,从而为大模型在复杂场景中的应用提供更多可能性。但是在实际落地场景中,往往会存在检索准确率低,噪音干扰多,召回完整性,专业性不够,导致 LLM 幻觉严重的问题。本次分享会聚焦 RAG 在实际落地场景中的知识加工和检索细节,如何去优化 RAG Pineline 链路,最终提升召回准确率。
一、知识检索优化思路
目前 RAG 智能问答应用几个痛点:
- 知识库文档越来越多以后,检索噪音大,召回准确率不高
- 召回不全,完整性不够
- 召回和用户问题意图相关性不大
- 只能回答静态数据,无法动态获取知识,导致答疑应用比较呆,比较笨。
知识处理优化
非结构化 / 半结构化 / 结构化数据的处理,准备决定着 RAG 应用的上限,因此首先需要在知识处理,索引阶段做大量的细粒度的 ETL 工作,主要优化的思路方向:
- 非结构化 -> 结构化:有条理地组织知识信息。
- 提取更加丰富的, 多元化的语义信息。
知识加载
目的:需要对文档进行精确的解析,更多元化的识别到不同类型的数据。
优化建议:
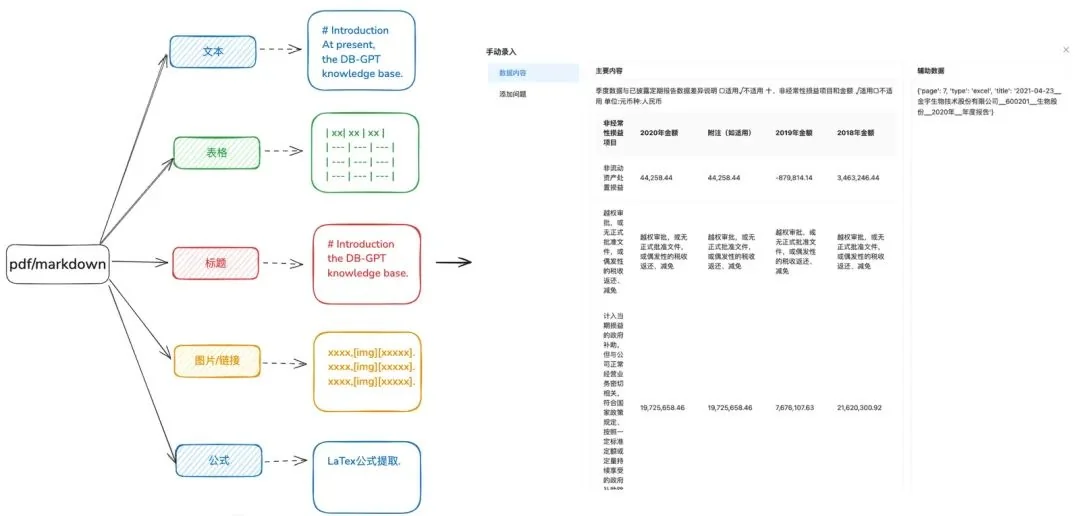
- 建议将 docx、txt 或者其他文本事先处理为 pdf 或者 markdown 格式,这样可以利用一些识别工具更好的提取文本中的各项内容。
- 提取文本中的表格信息。
- 保留 markdown 和 pdf 的标题层级信息,为接下来的层级关系树等索引方式准备。
- 保留图片链接,公式等信息,也统一处理成 markdown 的格式。
切片 Chunk 尽量保持完整
目的:保存上下文完整性和相关性,这直接关乎回复准确率。
保持在大模型的上下文限制内,分块保证输入到 LLMs 的文本不会超过其 token 限制。
优化建议:
- 图片 + 表格单独抽取成 Chunk,将表格和图片标题保留到 metadata 元数据里。
- 文档内容尽量按照标题层级或者 Markdown Header 进行拆分,尽可能保留 chunk 的完整性。
- 如果有自定义分隔符可以按照自定义分割符切分。
多元化的信息抽取
除了对文档进行 Embedding 向量抽取外,其他多元化的信息抽取能够对文档进行数据增强,显著提升 RAG 召回效果。
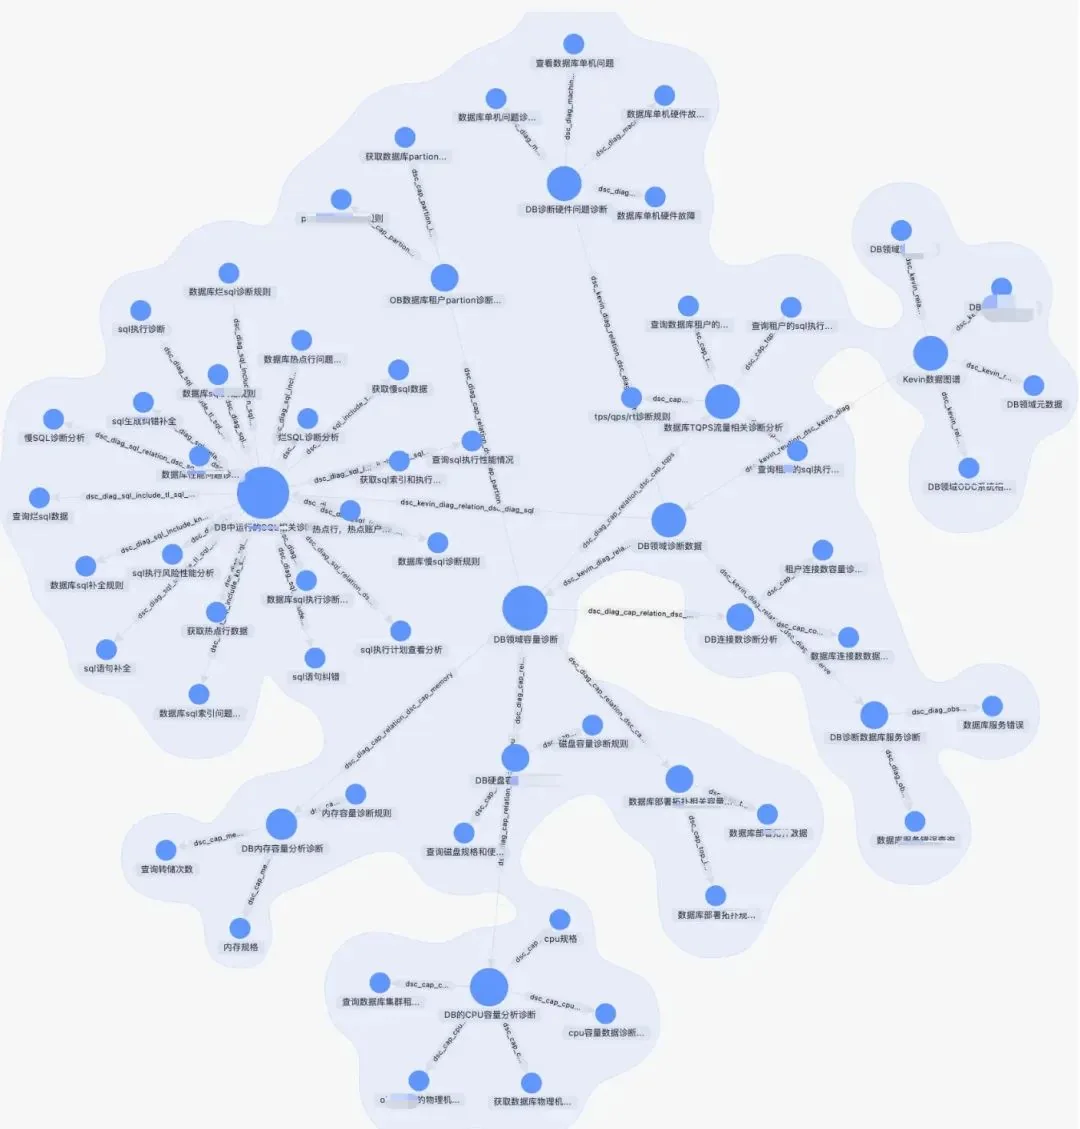
- 知识图谱
- 优点:1. 解决 NativeRAG 的完整性缺失,依然存在幻觉问题,知识的准确性,包括知识边界的完整性、知识结构和语义的清晰性,是对相似度检索的能力的一种语义补充。
- 适用场景:适用于严谨的专业领域 (医疗,运维等),知识的准备需要受到约束的并且知识之间能够明显建立层级关系的。
- 如何实现:
- 依赖大模型提取 (实体, 关系, 实体) 三元组关系。
- 依赖前期高质量,结构化的知识准备,清洗,抽取,通过业务规则通过手动或者自定义 SOP 流程构建知识图谱。
- Doc Tree
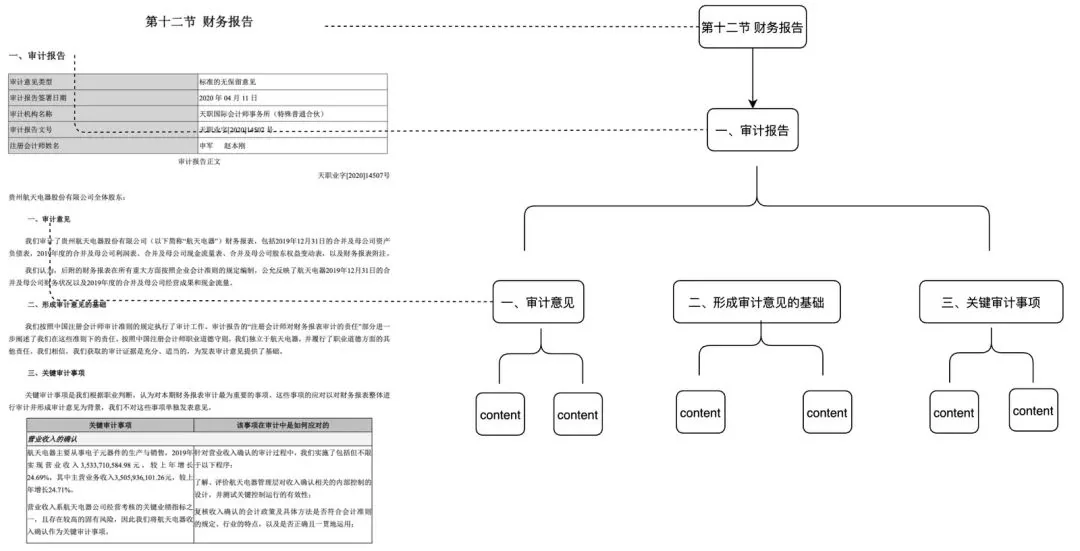
- 适用场景:解决了上下文完整性不足的问题,也能匹配时完全依据语义和关键词,能够减少噪音
- 如何实现:以标题层级构建 chunk 的树形节点,形成一个多叉树结构,每一层级节点只需要存储文档标题,叶子节点存储具体的文本内容。这样利用树的遍历算法,如果用户问题命中相关非叶子标题节点,就可以将相关的子节点数据进行召回。这样就不会存在 chunk 完整性缺失的问题。
- 提取 QA 对,需要前置通过预定义或者模型抽取的方式提取 QA 对信息
- 适用场景:
- 能够在检索中命中问题并直接进行召回,直接检索到用户想要的答案,适用于一些 FAQ 场景,召回完整性不够的场景。
- 如何实现:
- 预定义: 预先为每个 chunk 添加一些问题
- 模型抽取: 通过给定一下上下文,让模型进行 QA 对抽取
- 元数据抽取
- 如何实现:根据自身业务数据特点,提取数据的特征进行保留,比如标签,类别,时间,版本等元数据属性。
- 适用场景:检索时候能够预先根据元数据属性进行过滤掉大部分噪音。
- 总结提取
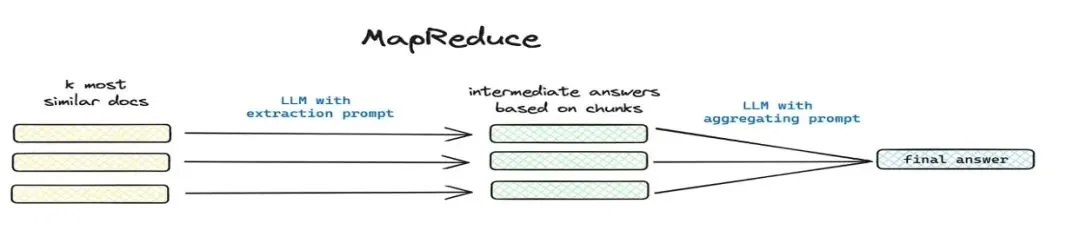
- 适用场景:解决这篇文章讲了个啥,总结一下等全局问题场景。
- 如何实现:通过 mapreduce 等方式分段抽取,通过模型为每段 chunk 提取摘要信息。
知识处理工作流
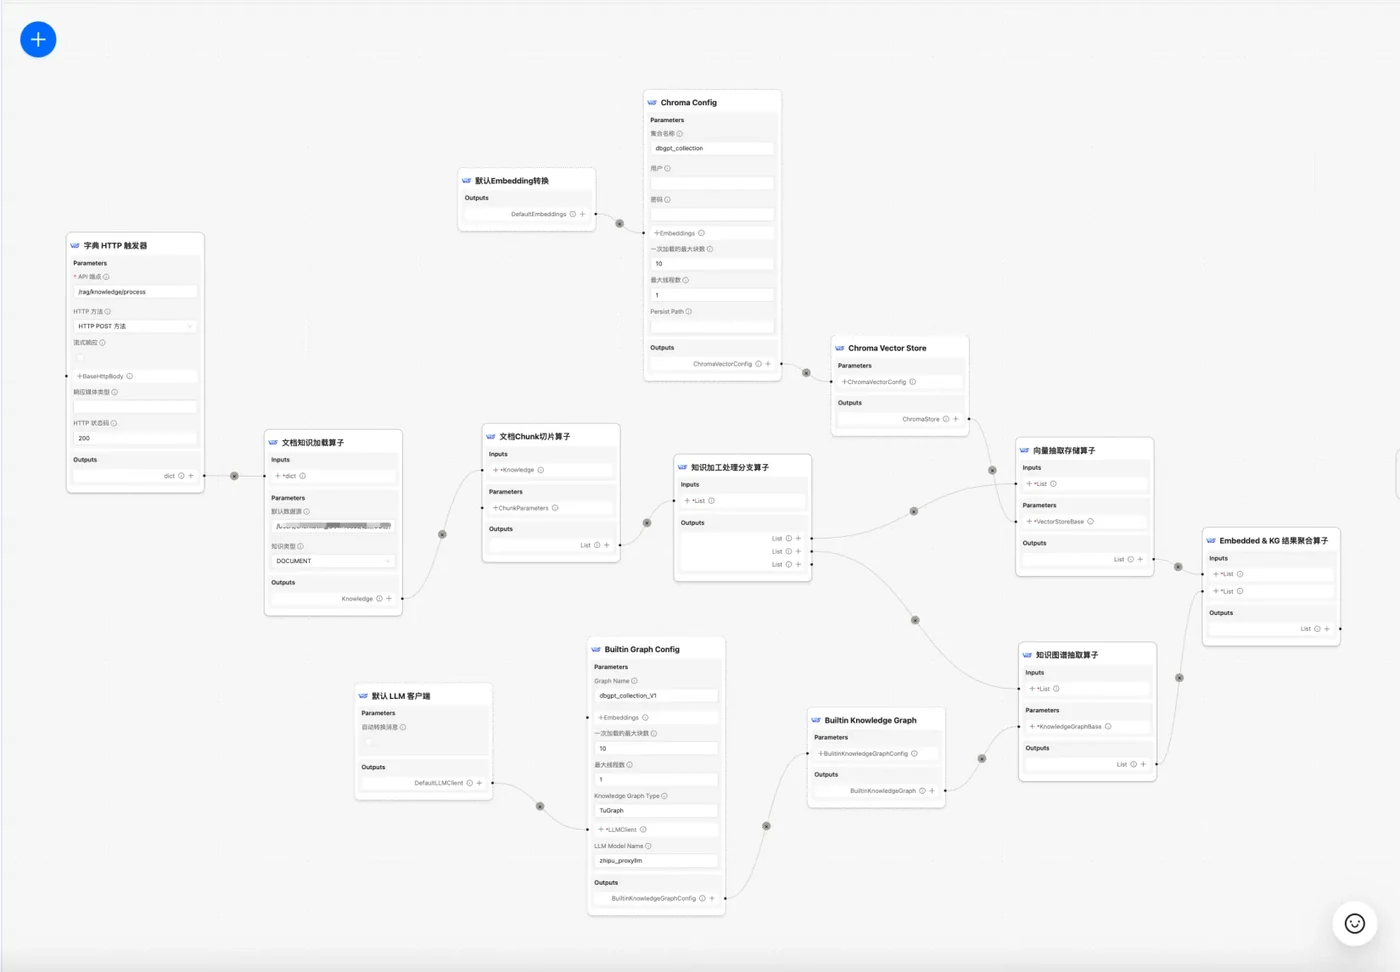
目前 DB-GPT 知识库提供了文档上传 -> 解析 -> 切片 -> Embedding -> 知识图谱三元组抽取 -> 向量数据库存储 -> 图数据库存储等知识加工的能力,但是不具备对文档进行复杂的个性化的信息抽取能力,因此希望通过构建知识加工工作流模版来完成复杂的,可视化的,用户可自定义的知识抽取,转换,加工流程。