
Transformer主流大语言模型架构解析
《Transformer主流大语言模型架构解析》共 0.7 万字,通篇围绕 Transformer、上下文、架构、预训练 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(3 节)
- 1. 大语言模型的背景
- 2. 主流架构
- 3. 总结
随着人工智能技术的飞速发展,大语言模型(Large Language Models, LLMs)在自然语言处理(NLP)领域扮演了越来越重要的角色。它们不仅在语义理解、文本生成方面取得了显著的成果,还推动了人机交互、内容创作等多种应用的变革。本次我们探讨下大语言模型的主流架构,帮助大家深入理解这些模型的工作机制。
1. 大语言模型的背景
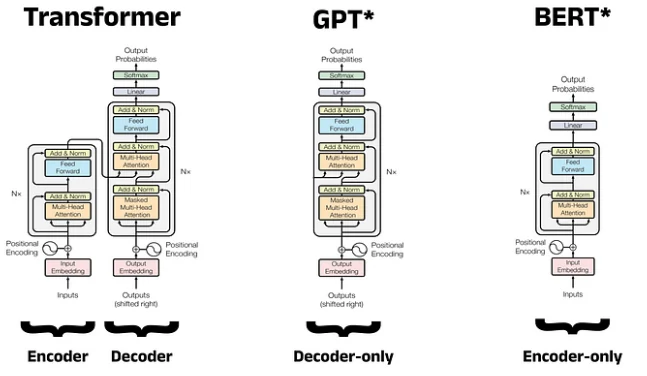
在探讨具体架构之前,我们需要了解一下大语言模型的背景。大语言模型通常指的是基于深度学习技术的大规模预训练模型,这些模型通过大量文本数据进行训练,具备了丰富的语言知识和上下文理解能力。GPT(Generative Pre-trained Transformer)、BERT(Bidirectional Encoder Representations from Transformers)等都是广为人知的示例。
2. 主流架构
2.1 Transformer 架构
Transformer 架构是大语言模型的核心基础之一,首次在 Vaswani 等人于 2017 年发布的论文《Attention is All You Need》中提出。与传统的循环神经网络(Recurrent Neural Networks, RNNs)相比,Transformer 采用了完全不同的机制,提供了更高的并行处理能力和更长的序列建模能力,因此迅速成为自然语言处理(NLP)领域的主流架构。
关键组成部分
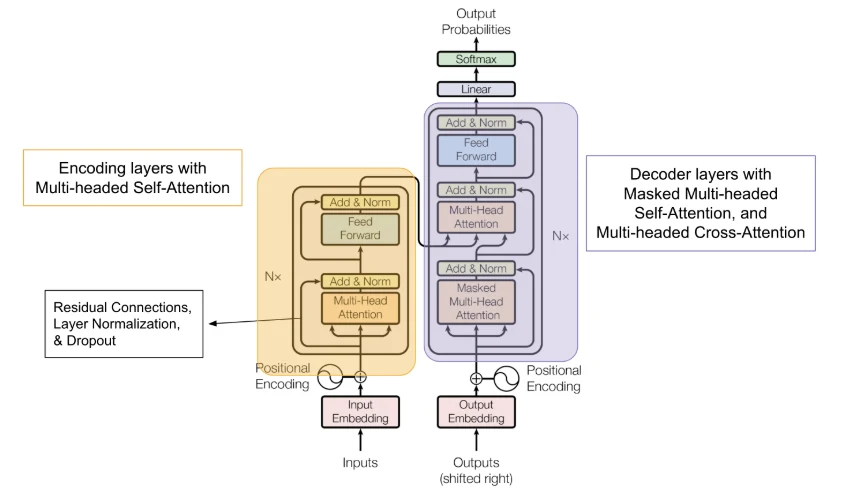
Transformer 由多个关键组件构成,主要包括自注意力机制(Self-Attention)、前馈神经网络(Feed-Forward Neural Network)、位置编码(Positional Encoding)、层归一化(Layer Normalization)以及编码器 - 解码器(Encoder-Decoder)结构。
1. 自注意力机制
自注意力机制是 Transformer 的核心,允许模型在处理某个词的时候,考虑序列中其他所有词的信息。该机制可以通过以下步骤实现:
- 输入向量转换:每个输入词被映射成三个不同的向量:查询(Query)、键(Key)和值(Value)。
- 计算注意力得分:查询向量与所有键向量进行点积,得到注意力得分。得分越高,表示该词对模型当前输出的重要性越大。
- 归一化处理:使用 Softmax 函数对得分进行归一化,以形成注意力权重,确保所有权重和为一。
- 加权求和:使用注意力权重对值向量进行加权求和,最终得到加权后的输出表示。
这一机制能够有效捕捉到单词之间的关联性,尤其在面对长文本时表现尤为出色。相比于 RNN,Transformer 不再依赖着时间序列的顺序处理,因而能够在更短的时间内并行计算,有效提升了训练效率。
2. 前馈神经网络
在自注意力层之后,输出会传递给一个前馈神经网络。此网络由两层全连接层构成,通常在中间使用 ReLU 或 GELU 等激活函数进行非线性变换。前馈神经网络的主要功能是对自注意力的输出进行进一步加工,增加模型的表达能力。
3. 位置编码
由于自注意力机制在计算时不依赖于输入序列的顺序,Transformer 需要一种方式来引入位置信息,从而确保模型能够理解词语在句子中的相对位置。为此,Transformer 使用了位置编码(Positional Encoding)。位置编码是将每个词的嵌入向量与一个表示该词位置的向量相加,从而调整各个词的表示,使其包含位置信息。Vaswani 等人提出了利用正余弦函数生成的位置编码,确保能够在各个维度上进行不同的位移。
4. 层归一化
在自注意力层与前馈神经网络之间,以及前馈神经网络的输出后,都会应用层归一化(Layer Normalization)。层归一化通过对每层的输入进行标准化,帮助模型在训练时更加稳定,加速收敛,并提升模型的性能。
5. 编码器 - 解码器结构
标准的 Transformer 结构包含一个编码器(Encoder)和一个解码器(Decoder)。编码器由多个相同的层堆叠而成,每个层都包括自注意力机制和前馈神经网络。而解码器同样由多个层堆叠而成,差别在于每层的解码器还引入了从编码器输出中提取的上下文信息,使得模型能够在生成阶段参考编码器中的信息。
编码器的功能:将输入的文本序列转换为一系列上下文相关的隐层表示。
解码器的功能:根据编码器的输出,以及之前生成的文本逐步生成目标序列。