
HF Transformers快速入门教程
《HF Transformers快速入门教程》共 0.2 万字,通篇围绕 预训练、Attention、向量、架构 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(2 节)
- 1. pipeline API
- 2. pipeline 的工作原理
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
现在做 NLP 方面的研究实在离不开预训练语言模型,尤其是 BERT。
huggingface 的 transformers 包是目前使用 BERT 最主流最方便的工具之一
注:由于官方文档和网页时常更新,链接失效是很有可能的!
本次使用的 transformers 版本为 4.15.0
- 预训练模型下载
huggingface/transformers 支持的所有模型:https://huggingface.co/models
如果环境支持科学上网,可以通过git lfs命令直接下载模型。
git lfs install
git clone https://huggingface.co/bert-base-chinese
如果需要手动下载模型并上传至服务器,则可以在 huggingface 的网页中手动下载模型。
通常我们需要保存的是三个文件及一些额外的文件
- 配置文件 config.json
- 词典文件 vocab.json
- 预训练模型文件,如果你使用 pytorch 则保存 pytorch_model.bin,如果你使用 tensorflow 2 则保存 tf_model.h5
额外的文件,指的是 merges.txt、special_tokens_map.json、added_tokens.json、tokenizer_config.json、sentencepiece.bpe.model 等,这几类是 tokenizer 需要使用的文件,如果出现的话,也需要保存下来。没有的话,就不必在意。如果不确定哪些需要下,哪些不需要的话,可以把类似的文件全部下载下来。
以 bert-base-chinese 模型为例,点击 Files and versions,下载所需的文件,放入与模型同名的文件夹中。
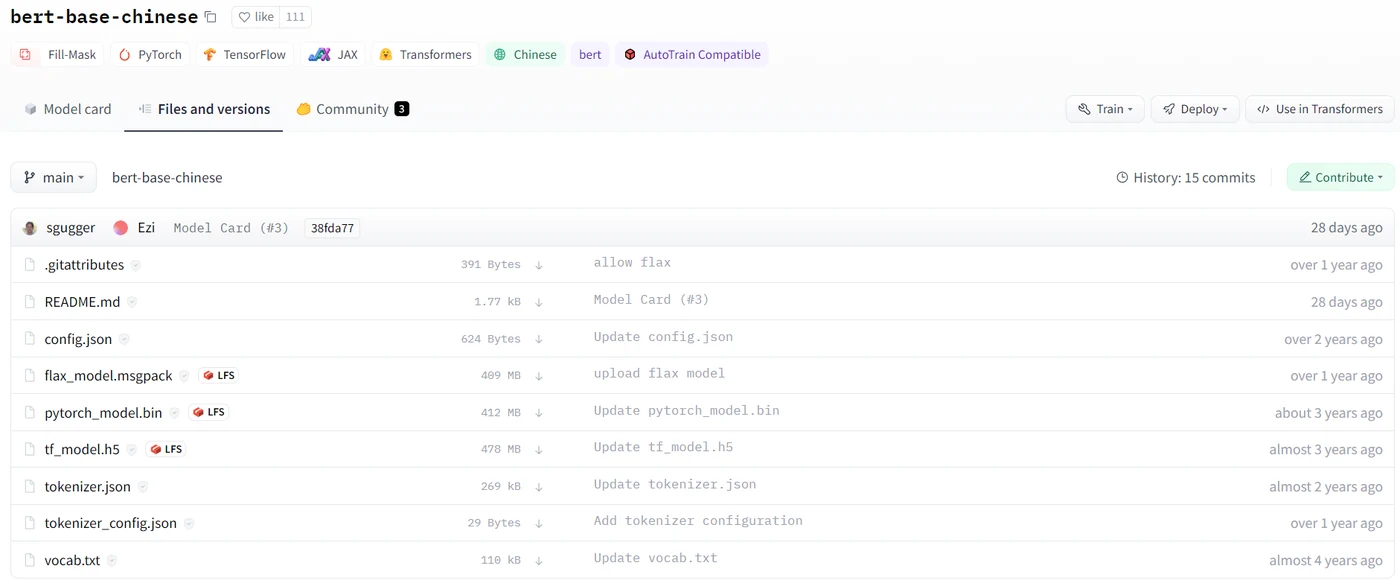
下载后,需保持文件夹和文件名称与仓库中的一致。
模型的快速使用
from transformers import AutoTokenizer, AutoModelForMaskedLM
tokenizer = AutoTokenizer.from_pretrained("bert-base-chinese")
model = AutoModelForMaskedLM.from_pretrained("bert-base-chinese")from_pretrained()的参数pretrained_model_name_or_path,可以接受的参数有如下几种:
- short-cut name(缩写名称,类似于 gpt2 这种)
- identifier name(类似于 microsoft/DialoGPT-small 这种)
- 文件夹
- 文件
对于 short-cut name 或 identifier name,这种情况下,本地有文件,可以使用本地的,本地没有文件,则会自动下载。
一些常用的 short-cut name,可以在 https://huggingface.co/models 中查看
对于文件夹,则会从文件夹中找 vocab.json、pytorch_model.bin、tf_model.h5、merges.txt、special_tokens_map.json、added_tokens.json、tokenizer_config.json、sentencepiece.bpe.model 等进行加载。所以这也是为什么下载的时候,一定要保证这些名称是这几个,不能变。
对于文件,则会直接加载文件。
官方给的样例,通常都是 short-cut name,我们可以将之替换为下载好的模型文件夹路径。
from transformers import AutoTokenizer, AutoModelForMaskedLM
tokenizer = AutoTokenizer.from_pretrained(local_model_path)
model = AutoModelForMaskedLM.from_pretrained(local_model_path)
官方 Quick tour