入门与全局认知3481 字
OpenAI应用开发快速入门
·全库 518 / 611
《OpenAI应用开发快速入门》共 0.3 万字,通篇围绕 成本、场景、需求、延迟 展开,归在「入门与全局认知」这一层。
覆盖成本场景需求延迟
适合刚接手 AI 项目、需要先把全局图景拼起来的人
目录骨架(8 节)
- OpenAI模型常用参数详解
- OpenAI 接口文档
- OpenAI 模型定价
- OpenAI 标准定价 vs 批量API
- 1. `max_tokens`(最大token数)
- 2. `temperature`(温度/文风的温度)
- 3. `n`(生成次数)
- 4. `top_p`(控制采样)
示例代码
注:将ppt后缀名改为zip后解压
python版本:3.12.4
OpenAI模型常用参数详解
1. max_tokens(最大token数)
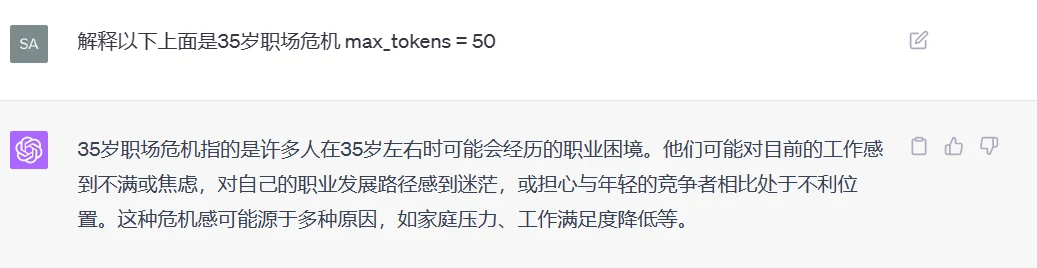
定义:指令生成的回答中包含的最大token数。例如,如果设置为100,那么模型生成的回答中token数不会超过100个。
用法:用来控制生成内容的长度。特别是在需要简短回答或有限字数情况下,这个参数非常实用。
例子:
- 输入:你问模型一个问题:“请简单解释一下黑洞。”
- max_tokens = 50:模型会尽量在50个token内完成回答。
- 回应:“黑洞是一个宇宙中极高密度的区域,其引力强大到光也无法逃脱。它是由大质量恒星坍缩形成的。”
2. temperature(温度/文风的温度)
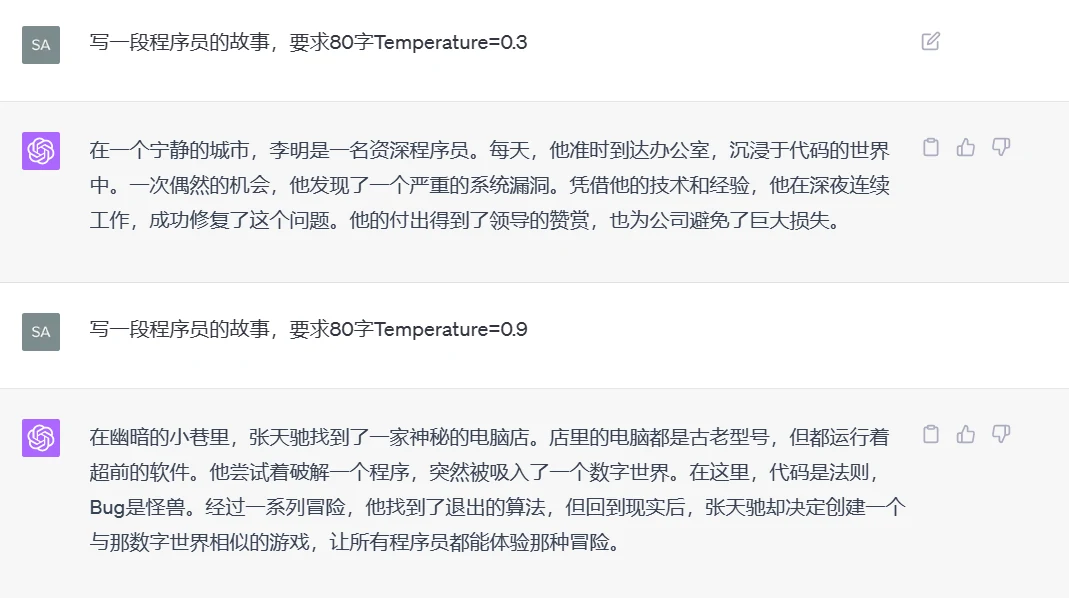
定义:控制文本生成的随机性。值范围通常在0到1之间。值越大,生成文本越随机;值越小,生成文本越确定。
用法:用来调整模型回答的创造性。高温度适合创造性任务;低温度适合需要确定性高的回答。
例子:
- 输入:你要写一首关于秋天的诗。
- temperature = 0.2(低温度,收敛回答):
- 回应:“秋天的树叶飘舞在风中,金黄色的田野映入眼帘。”
- temperature = 0.8(高温度,更随机):
- 回应:“秋天的旋律在微风中回荡,金黄的梦幻洒满田野。”
使用较低温度生成的文本将更加集中和保守,而使用较高温度生成的文本则会更具创意和变化。温度的范围是从 0 到 1。
- 温度 = 0:模型会产生最确定的输出,但可能显得重复或模板化。
- 0 < 温度 < 0.5:输出将倾向于较为稳定和保守,提供高度相关且一致的回应。
- 温度 = 0.5:产生的文本会有一个适中的平衡,既不过于随机也不过于保守。
- 0.5 < 温度 < 1:输出会更具创意和变化,但可能牺牲一些连贯性。
- 温度 = 1:模型会产生最大程度的创意和随机性,可能产生出奇不意的答案,但风险也更高。
3. n(生成次数)
定义:模型对每个输入生成的回答数量。设置为n就会生成n个独立的回答。
用法:用来获取多个回答,便于选择或综合。
例子:
- 输入:你问模型一个问题:“什么是人工智能?”
- n = 3:模型生成三个独立的回答。
- 回应1:“人工智能是模拟人类智能的计算机技术。”
- 回应2:“人工智能通过算法和大数据实现自动化任务。”
- 回应3:“人工智能涉及机器学习和神经网络等技术。”
4. top_p(控制采样)
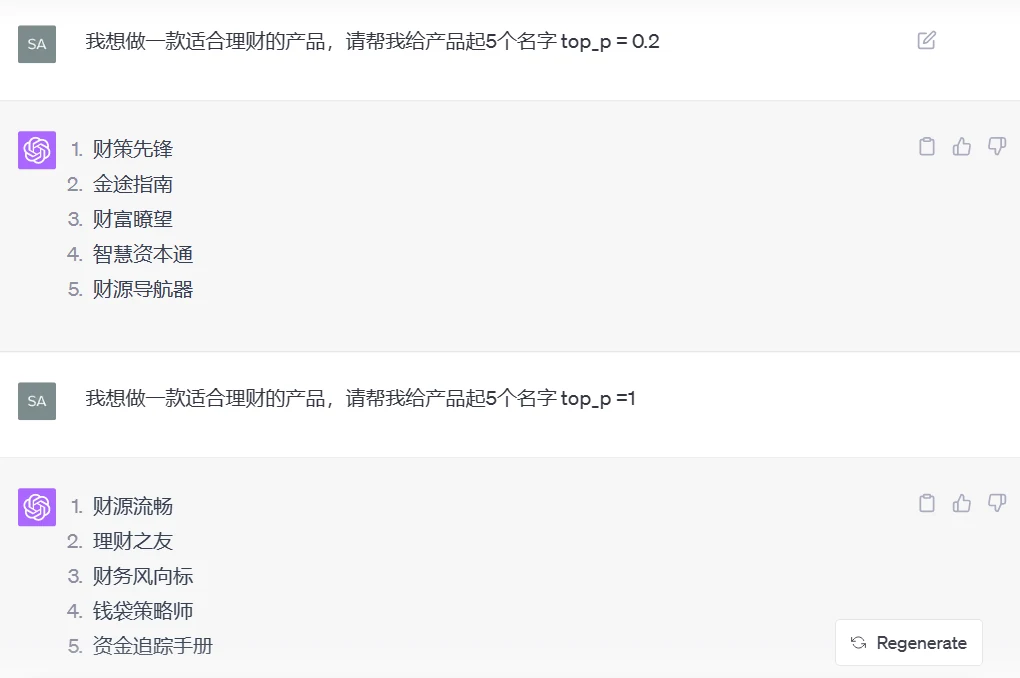
定义:确定生成文本时考虑的token累计概率。值为0到1之间,常用来替代温度设置。top_p为0.9时,模型仅在最有可能的token集合(累计概率达到0.9)中进行选择。
用法:控制生成内容的多样性,top_p越小,生成内容越确定。
例子:
- 输入:描述一个梦想中的度假胜地。
- top_p = 0.9(较有创意):
- 回应:“岛屿被蓝色的海水环绕,白色沙滩上点缀着茅草屋,椰子树随风摇曳。”
- top_p = 0.5(较确定):
- 回应:“度假胜地是一座热带岛屿,有着美丽的海滩和清澈的海水,适合享受安静的时光。”
5. presence_penalty(出现惩罚/阻止调整)
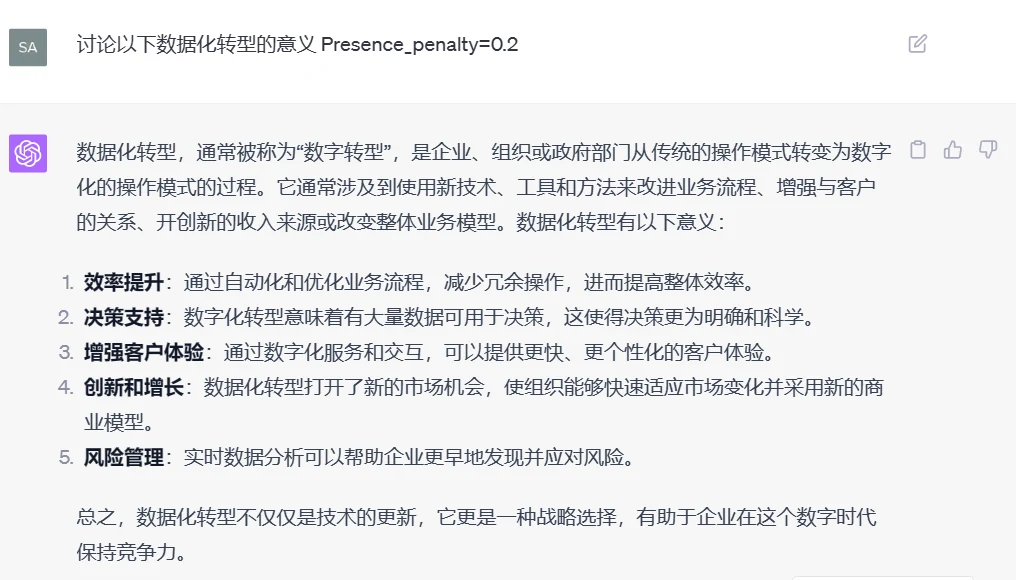
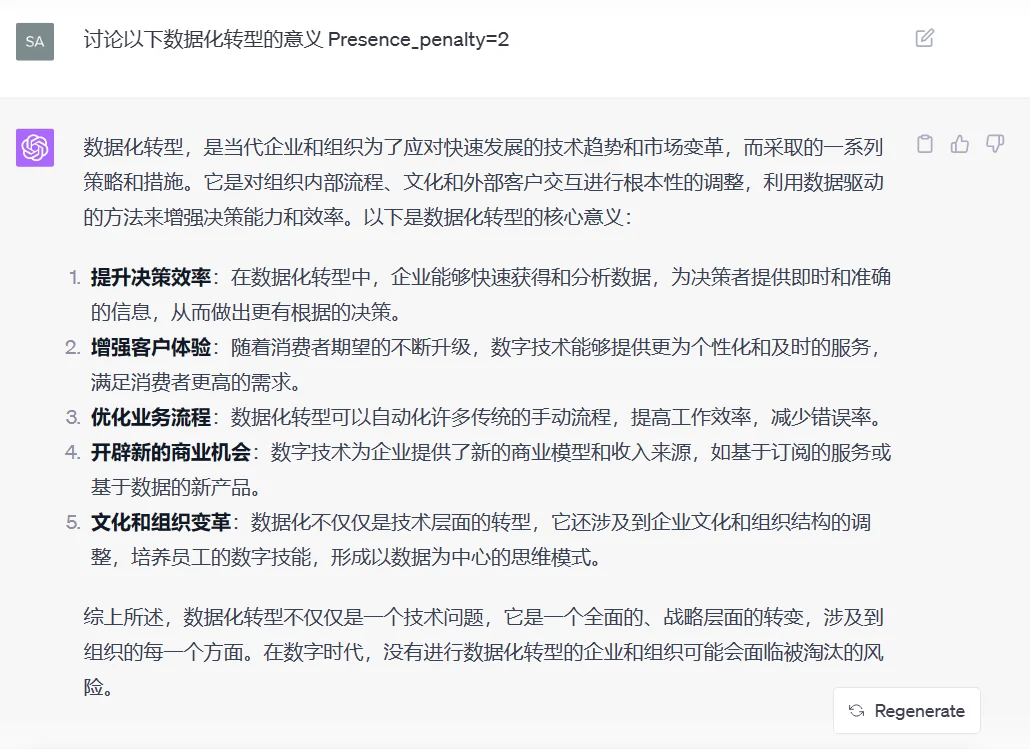
定义:影响模型生成新主题内容的倾向。值范围通常在-2.0到2.0之间。较高的值鼓励模型生成前面未出现过的新内容。
用法:用来避免重复内容,增加多样性。
例子:
- 输入:重新生成描述夏天的句子。
- presence_penalty = 1.0(较高惩罚):
- 回应:“夏天阳光充足,清凉的冰淇淋是人们的最爱。”
- presence_penalty = 0.0(无惩罚):
- 回应:“夏天阳光灿烂,人们喜欢躺在沙滩上享受日光浴。”
6. frequency_penalty(频率惩罚、短语效应)
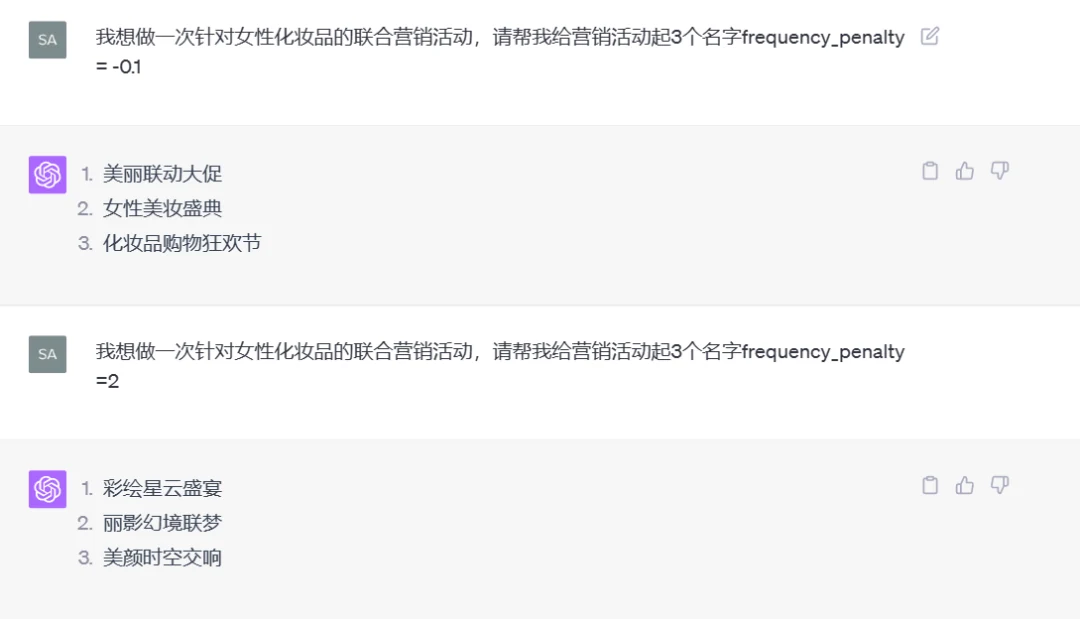
定义:影响模型是否重复使用某些词或短语。值范围通常在-2.0到2.0之间。较高的值会减少模型重复使用某些词或短语的频率。
用法:用来减少重复词语,提高输出的流畅度和多样性。
例子:
- 输入:描述你的一天。
- frequency_penalty = 1.5(较高惩罚):
- 回应:“我的一天开始于晨跑,然后享用早餐并开始工作。午餐后,进行一些锻炼和阅读。”
- frequency_penalty = 0.0(无惩罚):
- 回应:“我的一天从晨跑开始,之后吃早餐准备工作。午饭后,我会去健身房锻炼,结束后读书放松。”