
模型架构与原理图文讲义1749 字
深入理解Transformer技术原理
·全库 99 / 611
《深入理解Transformer技术原理》共 16 页、0.2 万字,通篇围绕 Transformer、Attention、向量、架构 展开,归在「模型架构与原理」这一层。
覆盖TransformerAttention向量架构上下文embedding
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 深入理解 Transformer 技术原理
- 演讲大纲
- RNN/LSTM:序列处理的曾经王者
- 旧时代的瓶颈:两大核心挑战
- 革命的起点:“Attention Is All You Need"
- 自注意力计算:两步详解
- 威力升级:多头注意力机制
- 深度总结:Transformer 的革命性优势
原 PDF 已逐页还原成图,共 16 页,这里先放前 3 页,其中 2 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。
本讲义目录 · 3 页
011 / 3
第 1 页
深入理解 Transformer 技术原理
022 / 3
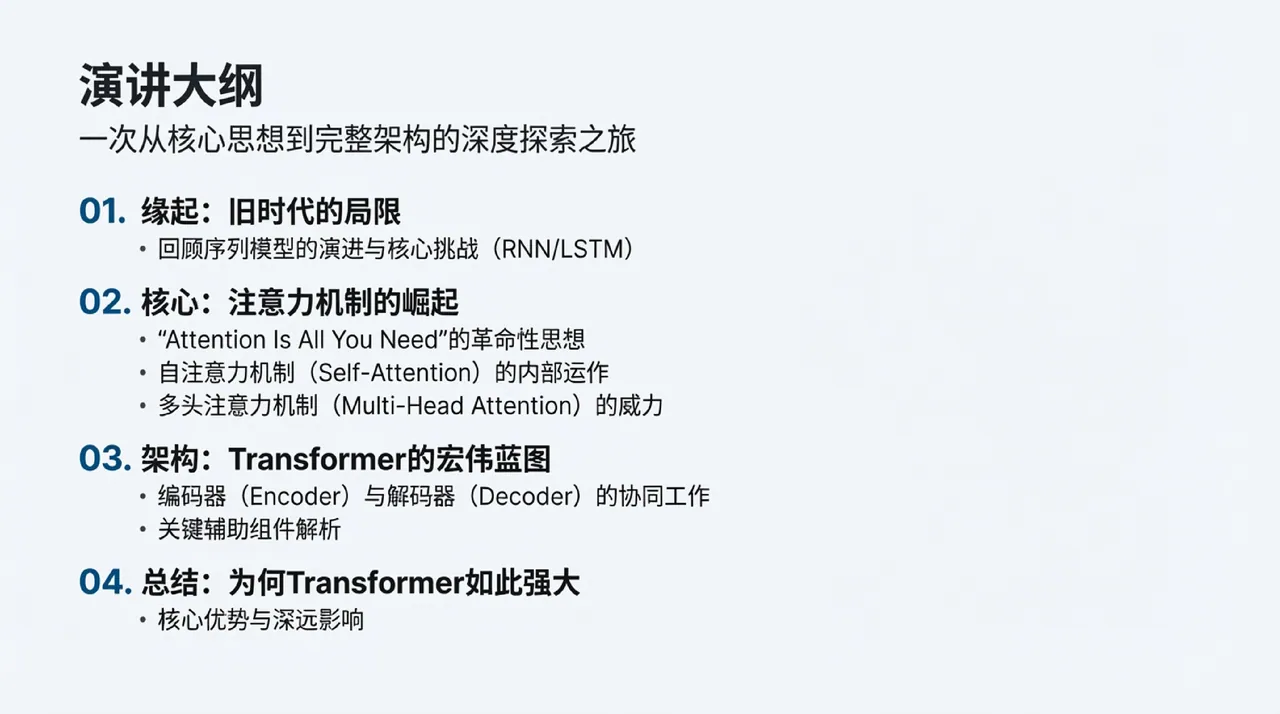
第 2 页
演讲大纲
033 / 3
第 3 页
缘起:旧时代的局限
这一页的文字很少,内容都在图里 —— 点开图片看大图更清楚。