
RAG 与知识库图文讲义1625 字
深入理解检索增强生成(RAG)的工作机制
·全库 100 / 611
《深入理解检索增强生成(RAG)的工作机制》共 14 页、0.2 万字,通篇围绕 向量、embedding、RAG、检索 展开,归在「RAG 与知识库」这一层。
覆盖向量embeddingRAG检索重排知识库
适合手上有一堆资料,要把它变成能问答的知识库的人
目录骨架(8 节)
- 解锁 AI 大模型的全部潜力
- 大模型知道一切,除了那些对你最重要的事
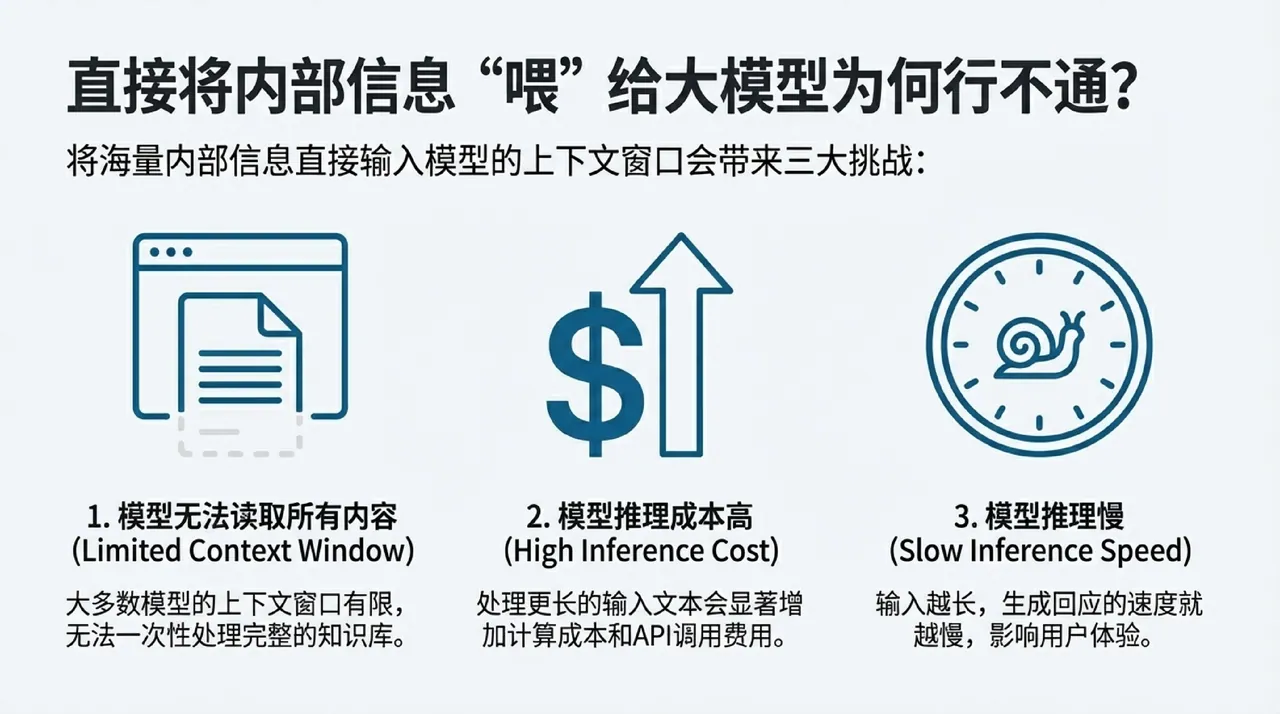
- 直接将内部信息“喂”给大模型为何行不通?
- 解决方案:检索增强生成(RAG)
- RAG 的工作流程:两阶段方法
- 核心概念:什么是 Embedding?
- “召回”是在用户提问时,从向量数据库中快速搜索并找出与问题最相关的 N 个文本
- 技术细节:向量相似度如何计算?
原 PDF 已逐页还原成图,共 14 页,这里先放前 3 页,其中 3 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。
011 / 3
第 1 页
解锁 AI 大模型的全部潜力
022 / 3
第 2 页
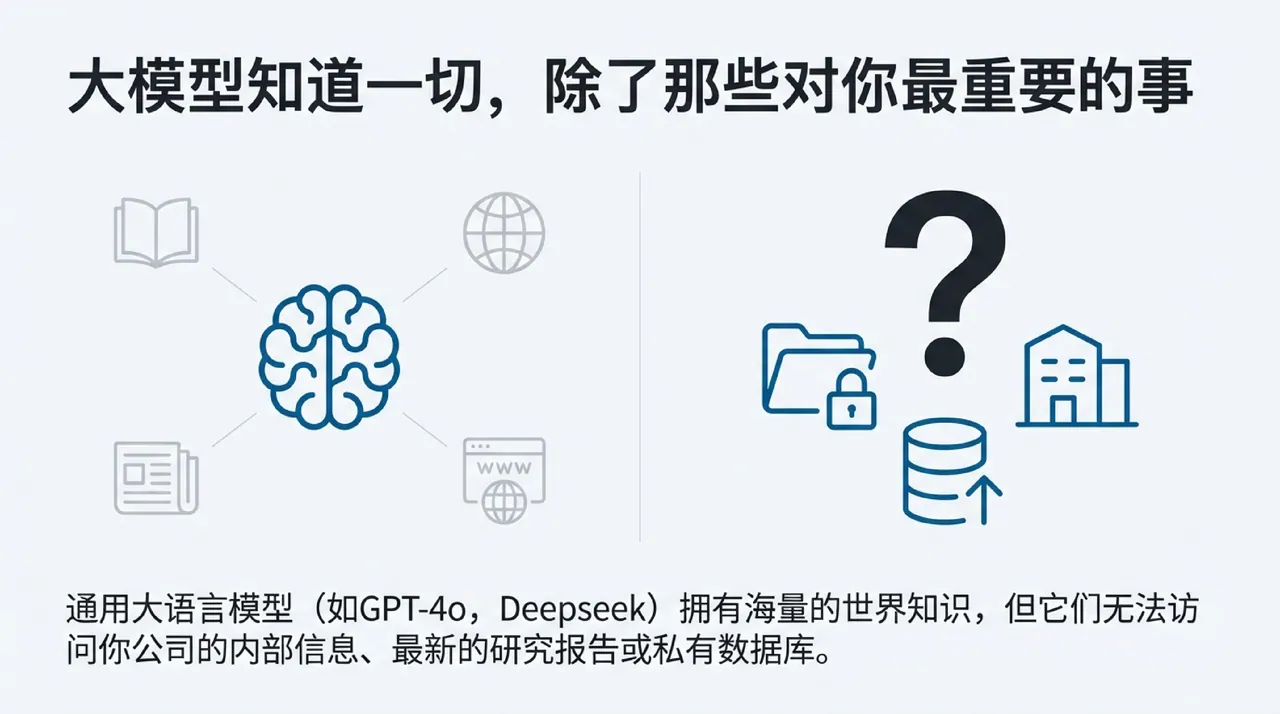
大模型知道一切,除了那些对你最重要的事
033 / 3
第 3 页