训练、微调与数据面试题图文讲义2514 字

大模型LoRA微调面试题

·全库 153 / 611

《大模型LoRA微调面试题》共 5 页、0.3 万字,通篇围绕 LoRA、微调、QLoRA、推理 展开,归在「训练、微调与数据」这一层。

覆盖LoRA微调QLoRA推理量化延迟

适合要自己训模型、或者判断这一版该不该训的人

目录骨架(6 节)
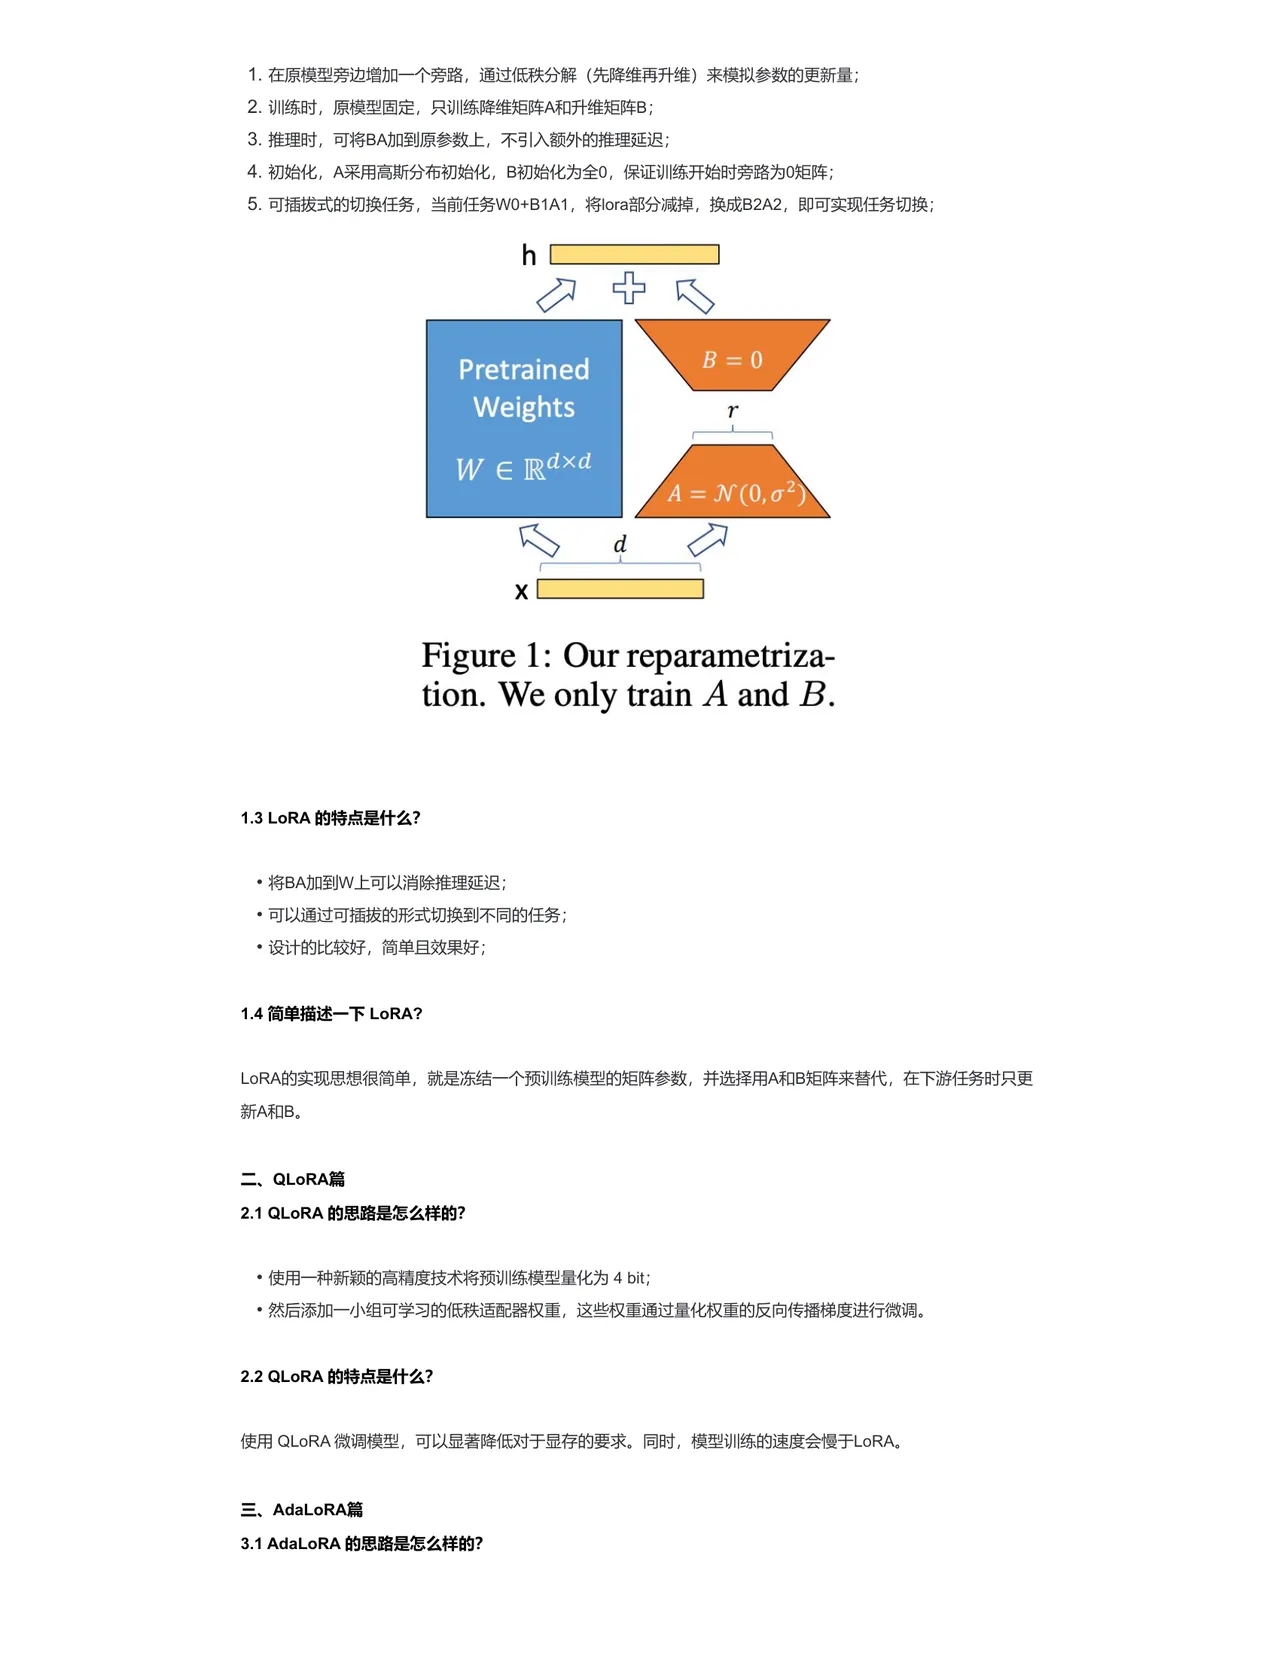
  1. tion. We only train A and B.
  2. Weights
  3. Figure 1: Our reparametriza-
  4. 十三、Rank 如何选取?
  5. 十五、LoRA 高效微调如何避免过拟合?
  6. 十六、微调大模型时,优化器如何?

原 PDF 已逐页还原成图,共 5 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
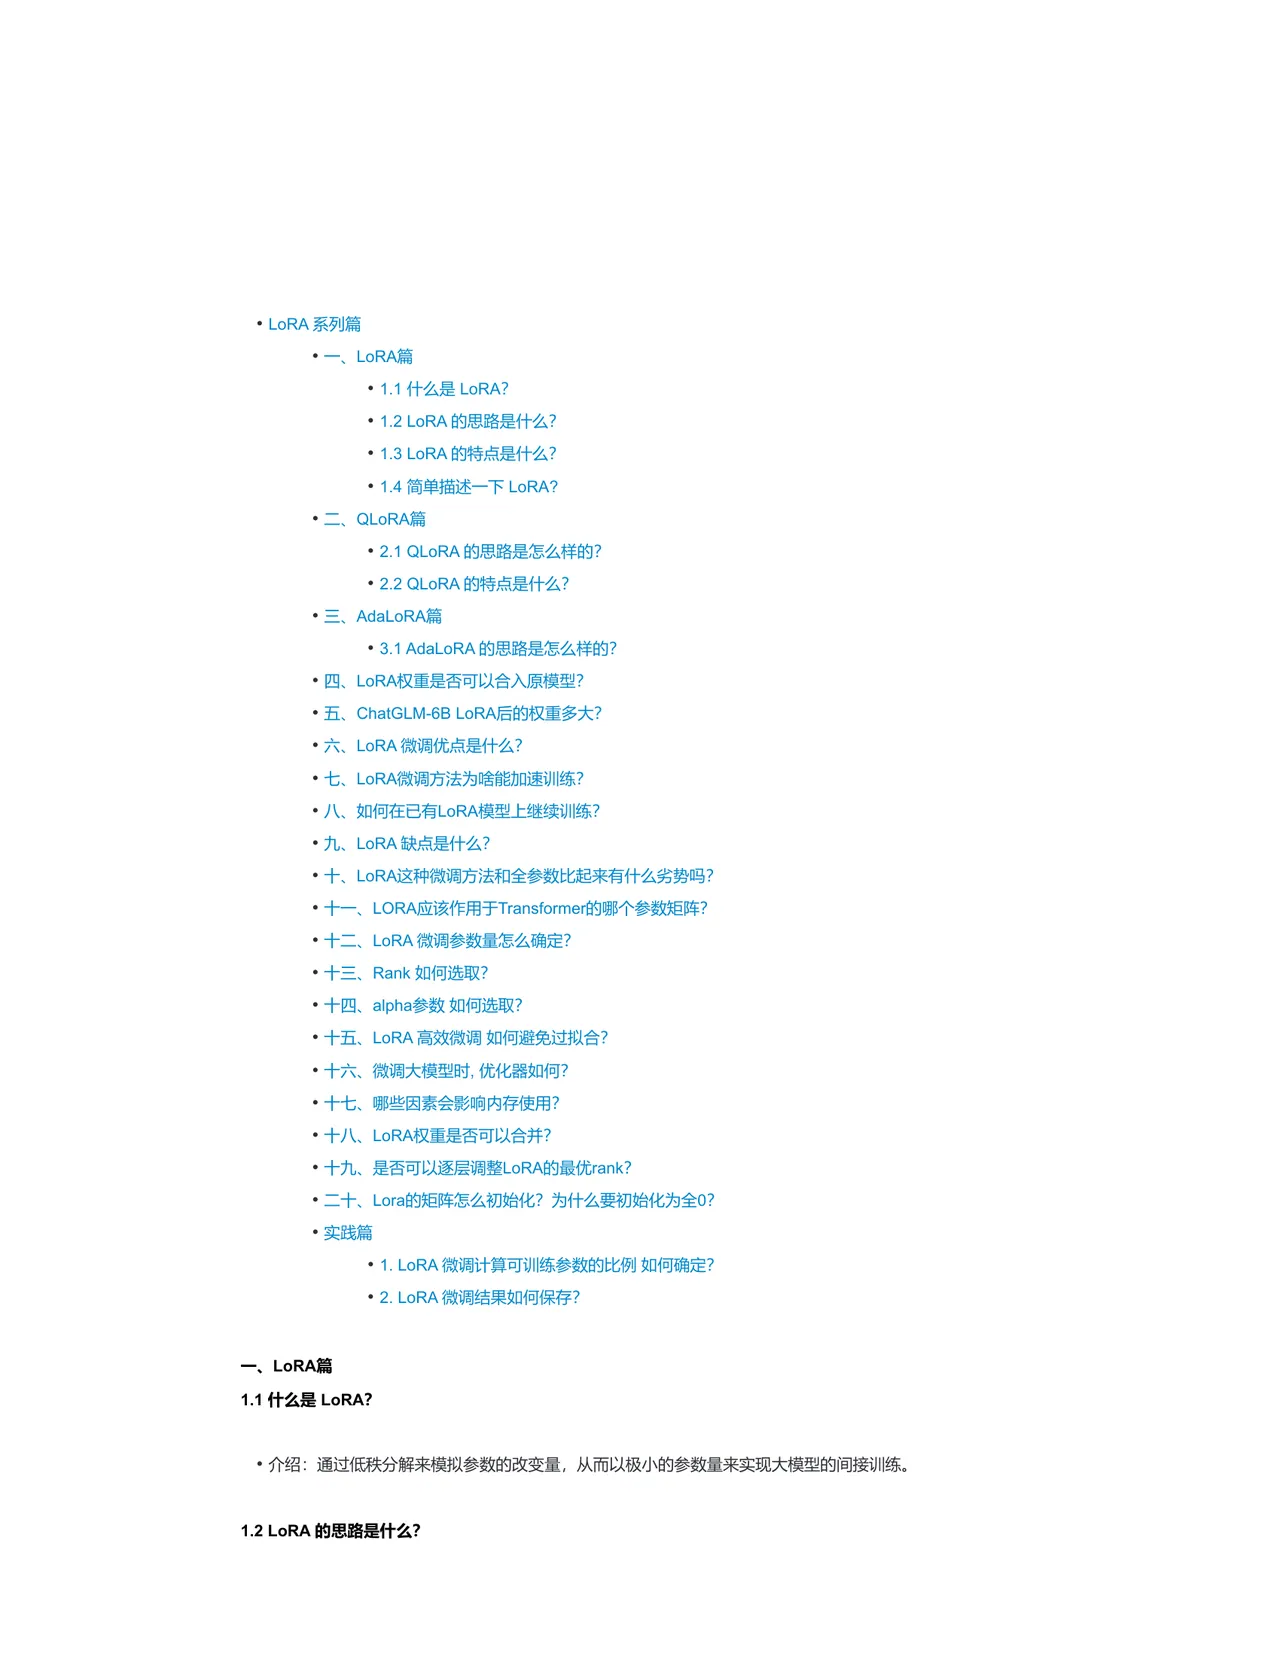
  1. 011.1 什么是 LORA?
  2. 02tion. We only train A and B.
  3. 03对 LoRA 的一种改进,它根据重要…
011 / 3
第 1 页
第 1 页

1.1 什么是 LORA?

  • 1.1 什么是 LORA?
  • 1.2 LoRA 的思路是什么?
  • 1.3 LoRA 的特点是什么?
  • 1.4 简单描述一下 LORA?
  • 2.1 QLoRA 的思路是怎么样的?
  • 2.2 QLoRA 的特点是什么?
  • 三、AdaLoRA 篇
  • 3.1AdaLoRA 的思路是怎么样的?
  • 四、LoRA 权重是否可以合入原模型?
  • 五、ChatGLM-6B LoRA 后的权重多大?
  • 六、LORA 微调优点是什么?
  • 七、LoRA 微调方法为啥能加速训练?
  • 八、如何在已有 LoRA 模型上继续训练? 九、LoRA 缺点是什么?
  • 十、LoRA 这种微调方法和全参数比起来有什么劣势吗?
  • 十一、LORA 应该作用于 Transformer 的哪个参数矩阵?
  • 十二、LoRA 微调参数量怎么确定?
  • 十三、Rank 如何选取?
  • 十四、alpha 参数如何选取?
  • 十五、LoRA 高效微调如何避免过拟合?
  • 十六、微调大模型时,优化器如何?
  • 十七、哪些因素会影响内存使用?
  • 十八、LORA 权重是否可以合并?
  • 十九、是否可以逐层调整 LORA 的最优 rank?
  • 二十、Lora 的矩阵怎么初始化?为什么要初始化为全 0?
  • 1.LoRA 微调计算可训练参数的比例如何确定?
  • 2.LoRA 微调结果如何保存?

一、LoRA 篇 1.1 什么是 LORA?

•介绍:通过低秩分解来模拟参数的改变量,从而以极小的参数量来实现大模型的间接训练。

1.2 LoRA 的思路是什么?

022 / 3
第 2 页:tion. We only train A and B.
第 2 页

tion. We only train A and B.

  1. 在原模型旁边增加一个旁路,通过低秩分解(先降维再升维)来模拟参数的更新量; 2. 训练时,原模型固定,只训练降维矩阵 A 和升维矩阵 B; 3. 推理时,可将 BA 加到原参数上,不引入额外的推理延迟; 4. 初始化,A 采用高斯分布初始化,B 初始化为全 0,保证训练开始时旁路为 0 矩阵; 5. 可插拔式的切换任务,当前任务 WO+B1A1,将 lora 部分减掉,换成 B2A2,即可实现任务切换;

1.3 LoRA 的特点是什么?

  • 将 BA 加到 W 上可以消除推理延迟;
  • 可以通过可插拔的形式切换到不同的任务;
  • 设计的比较好,简单且效果好;

1.4 简单描述一下 LoRA?

LoRA 的实现思想很简单,就是冻结一个预训练模型的矩阵参数,并选择用 A 和 B 矩阵来替代,在下游任务时只更 新 A 和 B。

二、QLoRA 篇 2.1 QLoRA 的思路是怎么样的?

  • 使用一种新颖的高精度技术将预训练模型量化为 4 bit;
  • 然后添加一小组可学习的低秩适配器权重,这些权重通过量化权重的反向传播梯度进行微调。

2.2 QLoRA 的特点是什么?

使用 QLoRA 微调模型,可以显著降低对于显存的要求。同时,模型训练的速度会慢于 LORA。

三.AdaLoRA 篇 3.1 AdaLoRA 的思路是怎么样的?

h 口

Pretrained

Weights

Figure 1: Our reparametriza-

033 / 3
第 3 页
第 3 页

对 LoRA 的一种改进,它根据重要…

对 LoRA 的一种改进,它根据重要性评分动态分配参数预算给权重矩阵,将关键的增量矩阵分配高秩以捕捉更精 细和任务特定的信息,而将较不重要的矩阵的秩降低,以防止过拟合并节省计算预算。

四、LoRA 权重是否可以合入原模型?

可以,将训练好的低秩矩阵(B*A)+原模型权重合并(相加),计算出新的权重。

五、ChatGLM-6B LoRA 后的权重多大?

rank 8 target_module query_key_value 条件下,大约 15M。

六、LoRA 微调优点是什么?

  1. 一个中心模型服务多个下游任务,节省参数存储量 2. 推理阶段不引入额外计算量 3. 与其它参数高效微调方法正交,可有效组合 4. 训练任务比较稳定,效果比较好 5. LoRA 几乎不添加任何推理延迟,因为适配器权重可以与基本模型合并

七、LoRA 微调方法为啥能加速训练?

  • 只更新了部分参数:比如 LoRA 原论文就选择只更新 Self Attention 的参数,实际使用时我们还可以选择只更新 部分层的参数;
  • 减少了通信时间:由于更新的参数量变少了,所以(尤其是多卡训练时)要传输的数据量也变少了,从而減 少了传输时间;
  • 采用了各种低精度加速技术,如 FP16、FP8 或者 INT8 量化等。 这三部分原因确实能加快训练速度,然而它们并不是 LoRA 所独有的,事实上几乎都有参数高效方法都具有这些 特点。LoRA 的优点是它的低秩分解很直观,在不少场景下跟全量微调的效果一致,以及在预测阶段不增加推理 成本。

八。如何在已有 LoRA 模型上继续训练?

理解此问题的情形是:已有的 lora 模型只训练了一部分数据,要训练另一部分数据的话,是在这个 lora 上继续训 练呢,还是跟 base 模型合并后再套一层 lora,或者从头开始训练一个 lora? 我认为把之前的 LoRA 跟 base model 合并后,继续训练就可以,为了保留之前的知识和能力,训练新的 LORA 时,加入一些之前的训练数据是需要的。另外,每次都重头来成本高。

九、LoRA 缺点是什么?

缺点很明显,参与训练的模型参数量不多,也就百万到干万级别的参数量,所以效果比全量微调差很多。可能在 扩散模型上感知没那么强,但在 LLM 上,个人感觉表现还是差距挺大的。

十、LoRA 这种微调方法和全参数比起来有什么劣势吗?

如果有足够计算资源以及有 10K 以上数据,我还是建议全参数微调,lora 的一个初衷就是为了解决不够计算资源的 情况下微调,只引入了少量参数,就可以在消费级 gpu 上训练,但 lora 的问题在于它不能节省训练时间,相比于

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求