RAG 与知识库面试题图文讲义2343 字

大模型PDF解析面试题

·全库 161 / 611

《大模型PDF解析面试题》共 5 页、0.2 万字,通篇围绕 OCR、召回、GPU、成本 展开,归在「RAG 与知识库」这一层。

覆盖OCR召回GPU成本向量检索

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(3 节)
  1. 准确率 100%
  2. 多级标题识别
  3. 知乎 @Walker

原 PDF 已逐页还原成图,共 5 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01一,为什么需要进行 pdf 解析? …
  2. 023. 如果内容都不能很好地组织起来,…
  3. 03准确率 100%
011 / 3
第 1 页
第 1 页

一,为什么需要进行 pdf 解析? …

  • 一,为什么需要进行 pdf 解析? 最近在探索 ChatPDF 和 ChatDoc 等方案的思路,也就是用 LLM 实现文档助手。在此记录一些难题和解决方案,首 先讲解主要思想,其次以问题+回答的形式展开。 二,为什么需要对 pdf 进行解析? 当利用 LLMs 实现用户与文档对话时,首要工作就是对文档中内容进行解析。 由于 pdf 是最通用,也是最复杂的文档形式,所以对 pdf 进行解析变成利用 LLM 实现用户与文档对话的重中之 重工作。 如何精确地回答用户关于文档的问题,不重也不漏?笔者认为非常重要的一点是文档内容解析。如果内容都不能 很好地组织起来,LLM 只能瞎编。 三,pdf 解析有哪些方法,对应的区别是什么? pdf 的解析大体上有两条路,一条是基于规则,一条是基于 AI。
  • 方法一:基于规则:
  • 介绍:根据文档的组织特点去“算”每部分的样式和内容
  • 存在问题:不通用,因为 pdf 的类型、排版实在太多了,没办法穷举
  • 方法二:基于 Al:
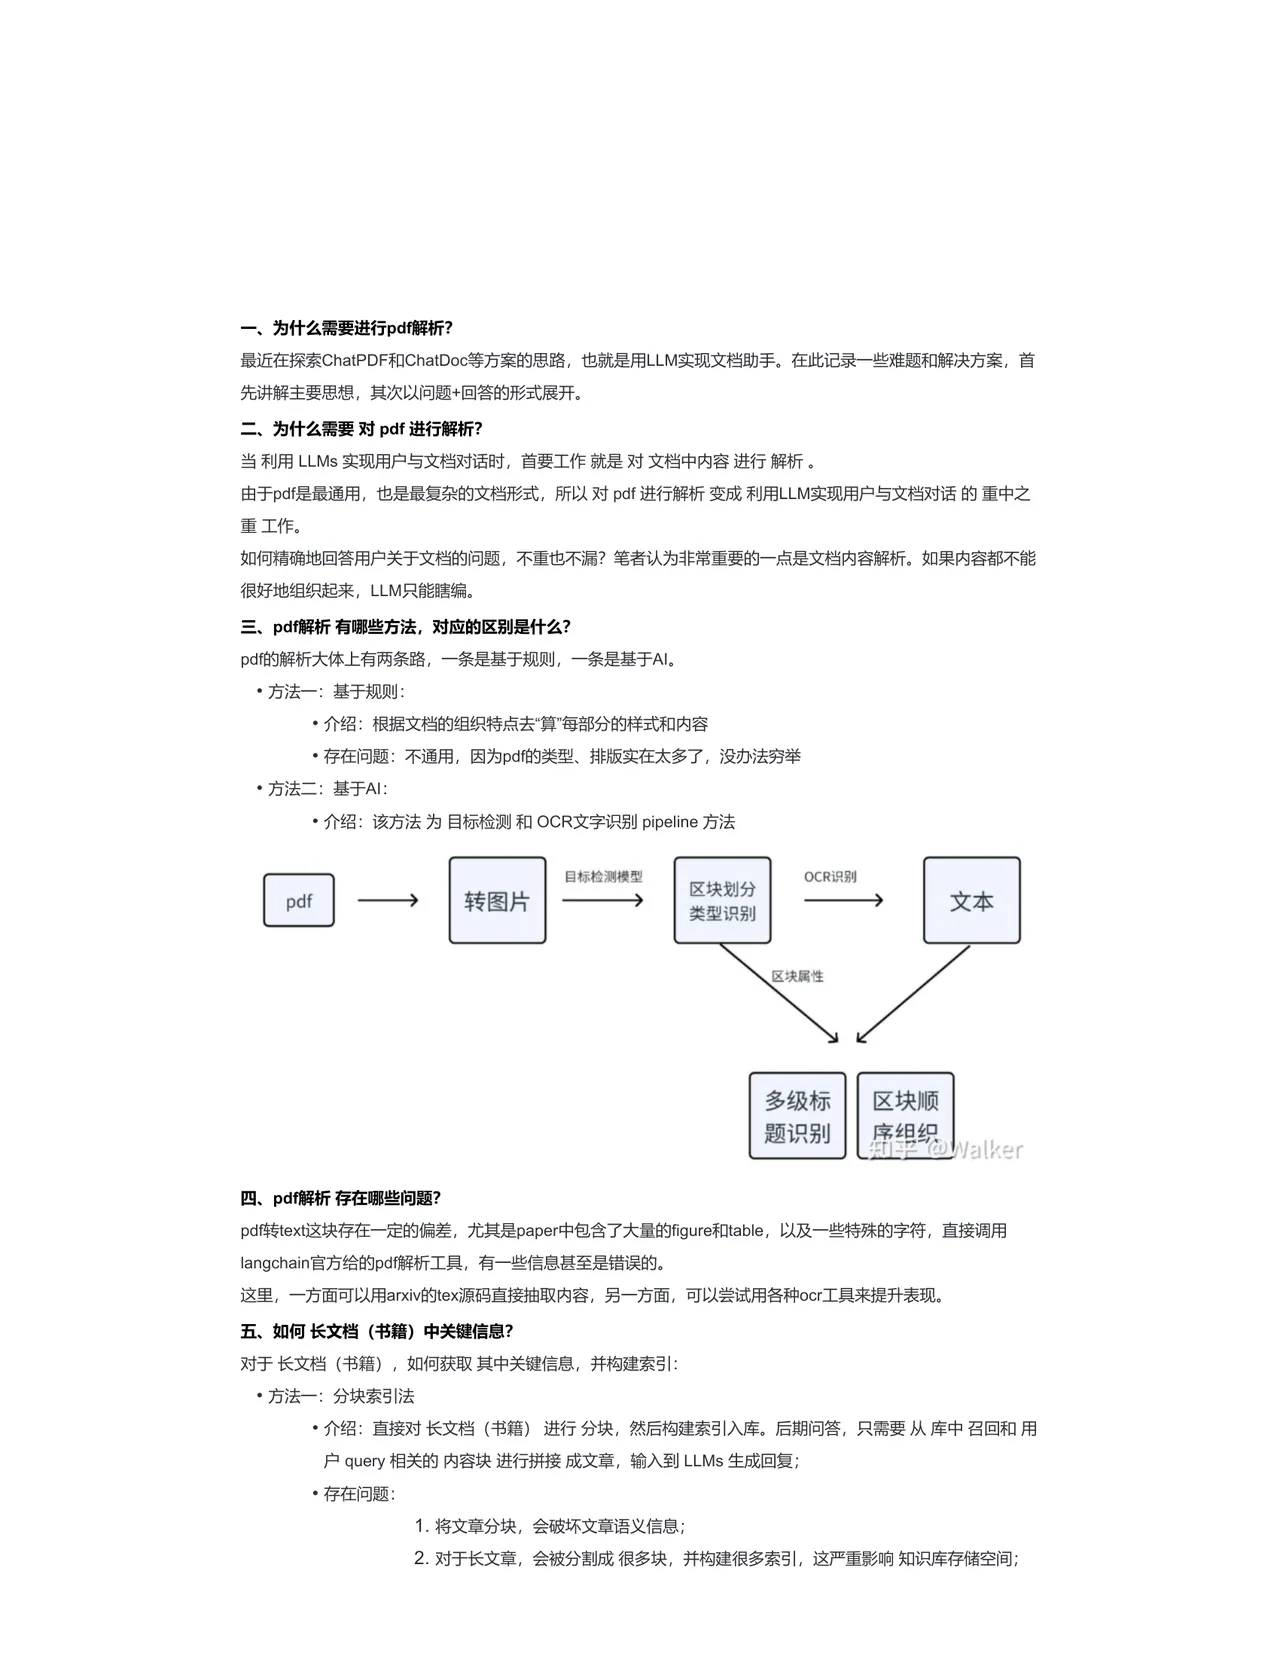
  • 介绍:该方法为目标检测和 OCR 文字识别 pipeline 方法 目标检测模型 转图片 pdf
  • 四、pdf 解析存在哪些问题? pd 体麦 text 这这块存在一定的偏差,尤其是 paper 中包含了大量的 figure 和 table,以及一些特殊的字符,直接调用 langchain 官方给的 pdf 解析工具,有一些信息甚至是错误的。 这里,一方面可以用 arxiv 的 tex 源码直接抽取内容,另一方面,可以尝试用各种 ocr 工具来提升表现。 五、如何长文档(书籍)中关键信息? 对于长文档(书籍),如何获取其中关键信息,并构建索引:
  • 方法一:分块索引法
  • 介绍:直接对长文档(书籍)进行分块,然后构建索引入库。后期间答,只需要从库中召回和用 户 query 相关的内容块进行拼接成文章,输入到 LLMs 生成回复;
  • 存在问题: 1. 将文章分块,会破坏文章语义信息; 2.对于长文章,会被分割成很多块,并构建很多索引,这严重影响知识库存储空间;

OCR 识别 区块划分

文本

多级标 区块顺 题识别

022 / 3
第 2 页
第 2 页

3. 如果内容都不能很好地组织起来,…

  • 3. 如果内容都不能很好地组织起来,LLM 只能瞎编;
  • 方法二:文本摘要法
  • 介绍:直接利用文本摘要模型对每一篇长文档(书籍)做文本摘要,然后对文本摘要内容构建索 引入库。后期问答,只需要从库中召回和用户 query 相关的摘要内容,输入到 LLMs 生成回复;
  • 存在问题: 1. 由于每篇长文档(书籍)内容比较多,直接利用文本摘要模型对其做文本摘要, 需要比较大算力成本和时间成本; 2. 生成的文本摘要存在部分内容丢失问题,不能很好的概括整篇文章;
  • 方法三:多级标题构建文本摘要法:
  • 介绍:把多级标题提取出来,然后适当做语义扩充,或者去向量库检索相关片段,最后用 LLM 整合即 可。 六、为什么要提取标题甚至是多级标题? 没有处理过 LLM 文档对话的朋友可能不明白为什么要提取标题甚至是多级标题,因此我先来阐述提取标题对于 LLM 阅读理解的重要性有多大。 1.如 Q1 阐述的那样,标题是快速做摘要最核心的文本; 2. 对于有些问题 high-level 的问题,没有标题很难得到用户满意的结果。 举个栗子:假如用户就想知道 3.2 节是从哪些方面讨论的(标准答案就是 3 个方面),如果我们没有将标题信息告 诉 LLM,而是把所有信息全部扔给 LLM,那它大概率不会知道是 3 个方面(要么会少,要么会多。做过的朋友秒 懂) 七、如何提取文章标题?
  • 第一步:pdf 转图片。用一些工具将 pdt 转专换为图片,这里有很多开源工具可以选,笔者采用 fitz,一个 python 库。速度很快,时间在毫秒之间;
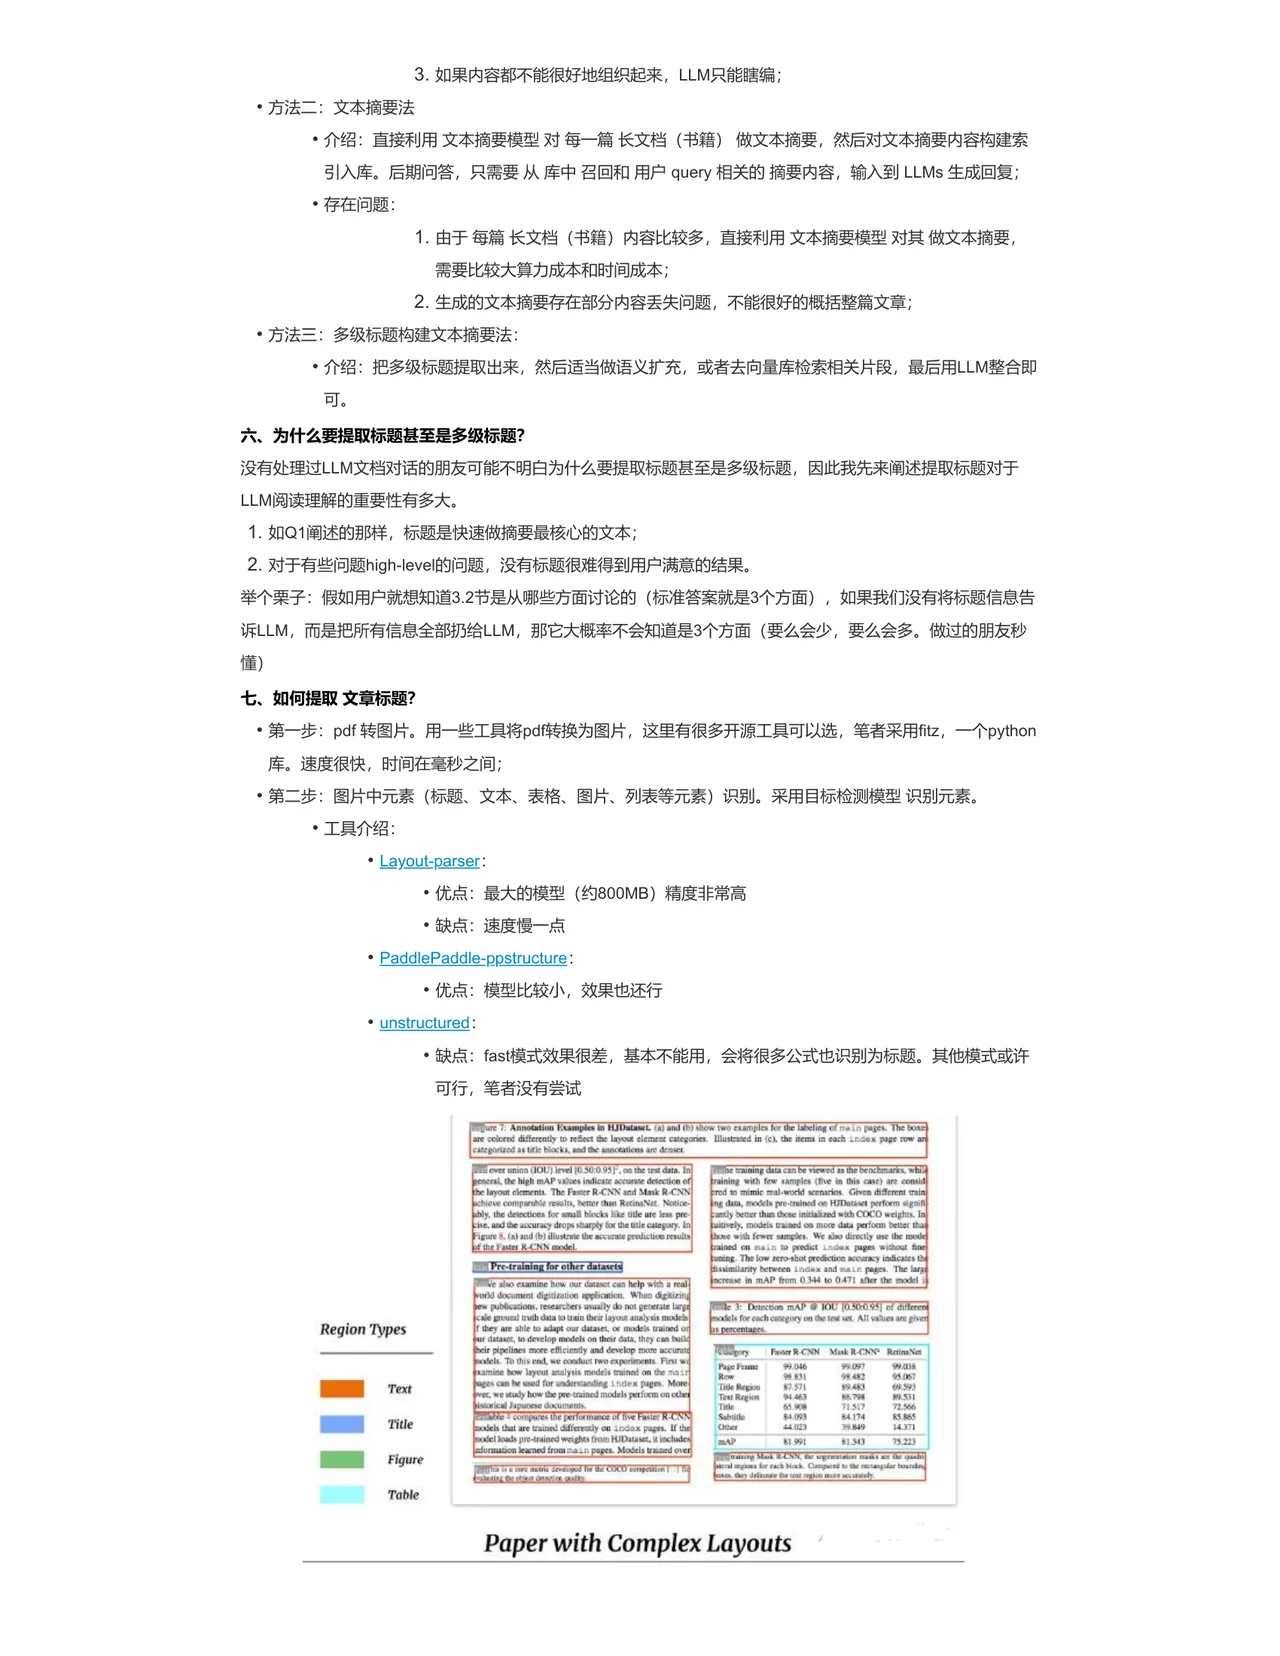
  • 第二步:图片中元素(标题、文本、表格、图片、列表等元素)识别。采用目标检测模型识别元素。
  • 工具介绍:
  • Layout-parser:
  • 优点:最大的模型(约 800MB)精度非常高
  • 缺点:速度慢一点
  • PaddlePaddle-ppstructure:

•优点:模型比较小,效果也还行

• unstructured:

•缺点:fast 模式效果很差,基本不能用,会将很多公式也识别为标题。其他模式或许 可行,笔者没有尝试

Region Types

Figure

Paper with Complex Layouts

033 / 3
第 3 页:准确率 100%
第 3 页

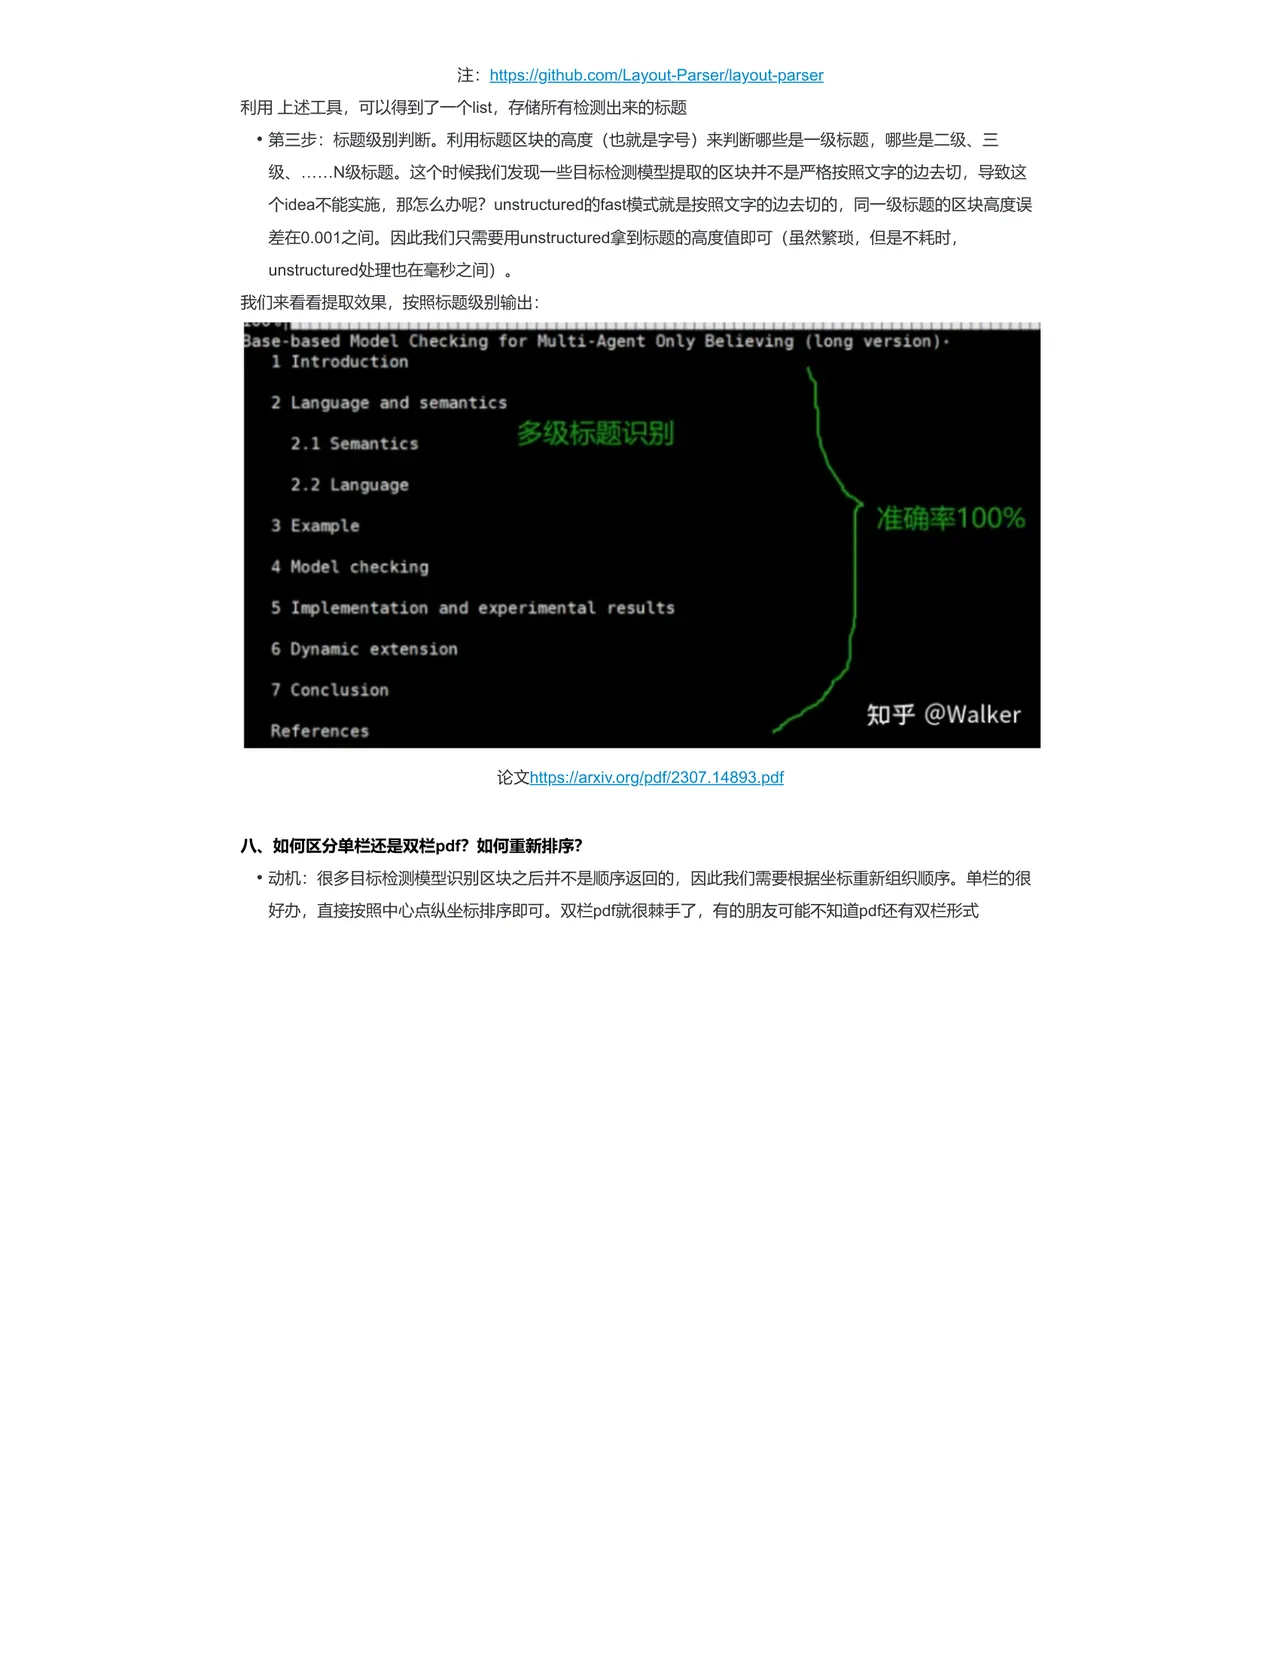
准确率 100%

注:https://github.com/Layout-Parser/layout-parser

多级标题识别

论文 https://arxiv.org/pdf/2307.14893.pdf

  • 利用上述工具,可以得到了一个 list,存储所有检测出来的标题
  • 第三步:标题级别判断。利用标题区块的高度(也就是字号)来判断哪些是一级标题,哪些是二级、三 级、
  • N 级标题。这个时候我们发现一些目标检测模型提取的区块并不是严格按照文字的边去切,导致这 个 idea 不能实施,那怎么办呢?unstructured 的 fast 模式就是按照文字的边去切的,同一级标题的区块高度误 差在 0.001 之间。因此我们只需要用 unstructured 拿到标题的高度值即可(虽然繁琐,但是不耗时, unstructured 处理也在毫秒之间)。 我们来看看提取效果,按照标题级别输出:

1 Introduction 2 Language and semantics

2.1 Semantics

2.2 Language 3 Example 4 Model checking 5 Implementation and experimental results 6 Dynamic extension 7 Conclusion References

八、如何区分单栏还是双栏 pdf?如何重新排序? •动机:很多目标检测模型识别区块之后并不是顺序返回的,因此我们需要根据坐标重新组织顺序。单栏的很 好办,直接按照中心点纵坐标排序即可。双栏 pd 就很棘手了,有的朋友可能不知道 pd 还有双栏形式

知乎 @Walker

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求