企业落地与项目实战面试题图文讲义4932 字

大模型文档对话面试题

·全库 162 / 611

《大模型文档对话面试题》共 8 页、0.5 万字,通篇围绕 向量、embedding、微调、召回 展开,归在「企业落地与项目实战」这一层。

覆盖向量embedding微调召回prompt检索

适合要把 AI 项目交付出去、对结果负责的人

目录骨架(1 节)
  1. LangChain

原 PDF 已逐页还原成图,共 8 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01、基于 LLM+向量库的文档对话经验…
  2. 02本地知识文件 读取内容 (txt/d…
  3. 037 月 17 日,国务院新闻办公室举…
011 / 3
第 1 页
第 1 页

、基于 LLM+向量库的文档对话经验…

  • 、基于 LLM+向量库的文档对话经验面 1.1 为什么大模型需要外挂(向量)知识库? 1.2.基于 LLM+向量库的文档对话思路是怎么样? 1.3.基于 LLM+向量库的文档对话核心技术是什么? 1.4.基于 LLM+向量库的文档对话 prompt 模板如何构建? 基于 LLM+向量库的文档对话工程示例面 3.1 本地知识库问答系统(Langchain-chatGLM) 3.1.1 避坑记录 1.1 为什么大模型需要外挂(向量)知识库? 如何将外部知识注入大模型,最直接的方法:利用外部知识对大模型进行微调
  • 思路:构建几十万量级的数据,然后利用这些数据对大模型进行微调,以将额外知识注入大模型
  • 优点:简单粗暴

i.这几十万量级的数据并不能很好的将额外知识注入大模型; i.训练成本昂贵。不仅需要多卡并行,还需要训练很多天; 既然大模型微调不是将外部知识注入大模型的最优方案,那是否有其它可行方案? 1.2. 基于 LLM+向量库的文档对话思路是怎么样?

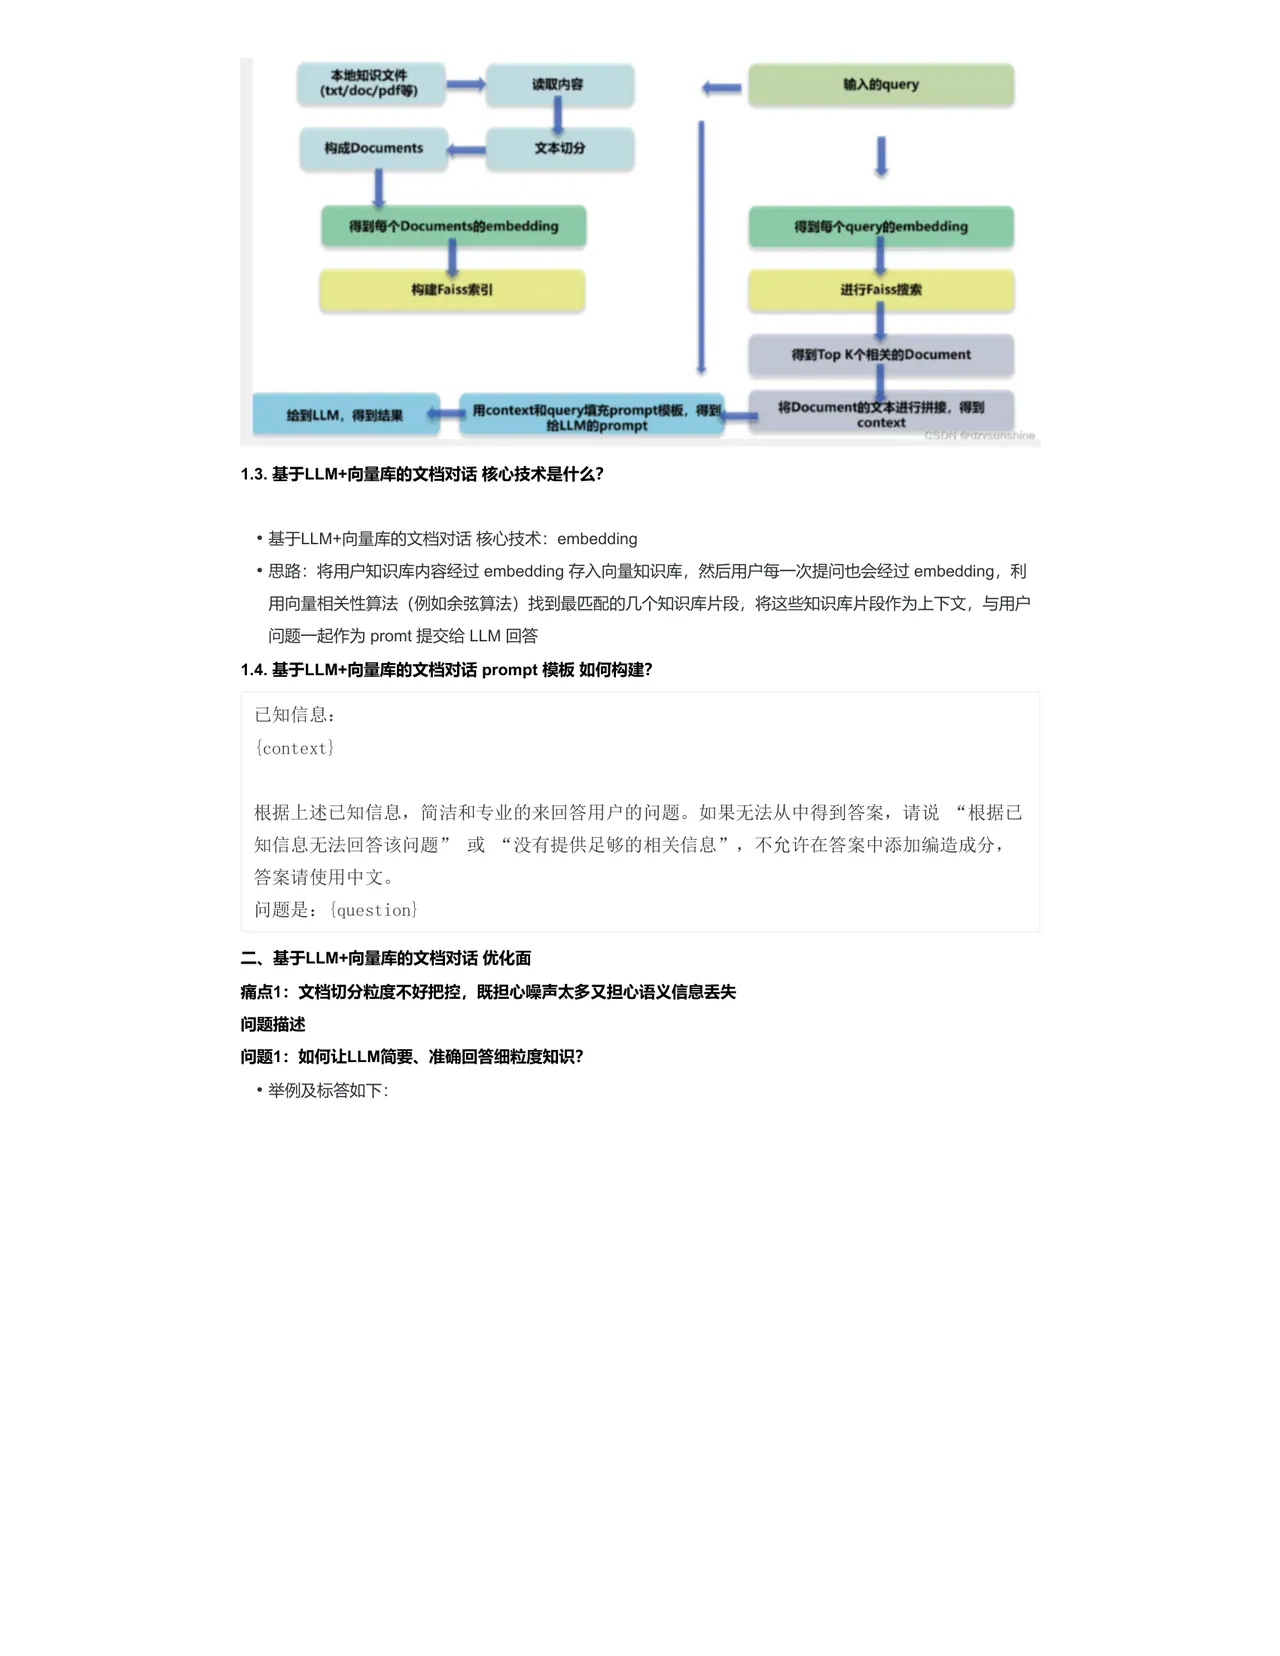
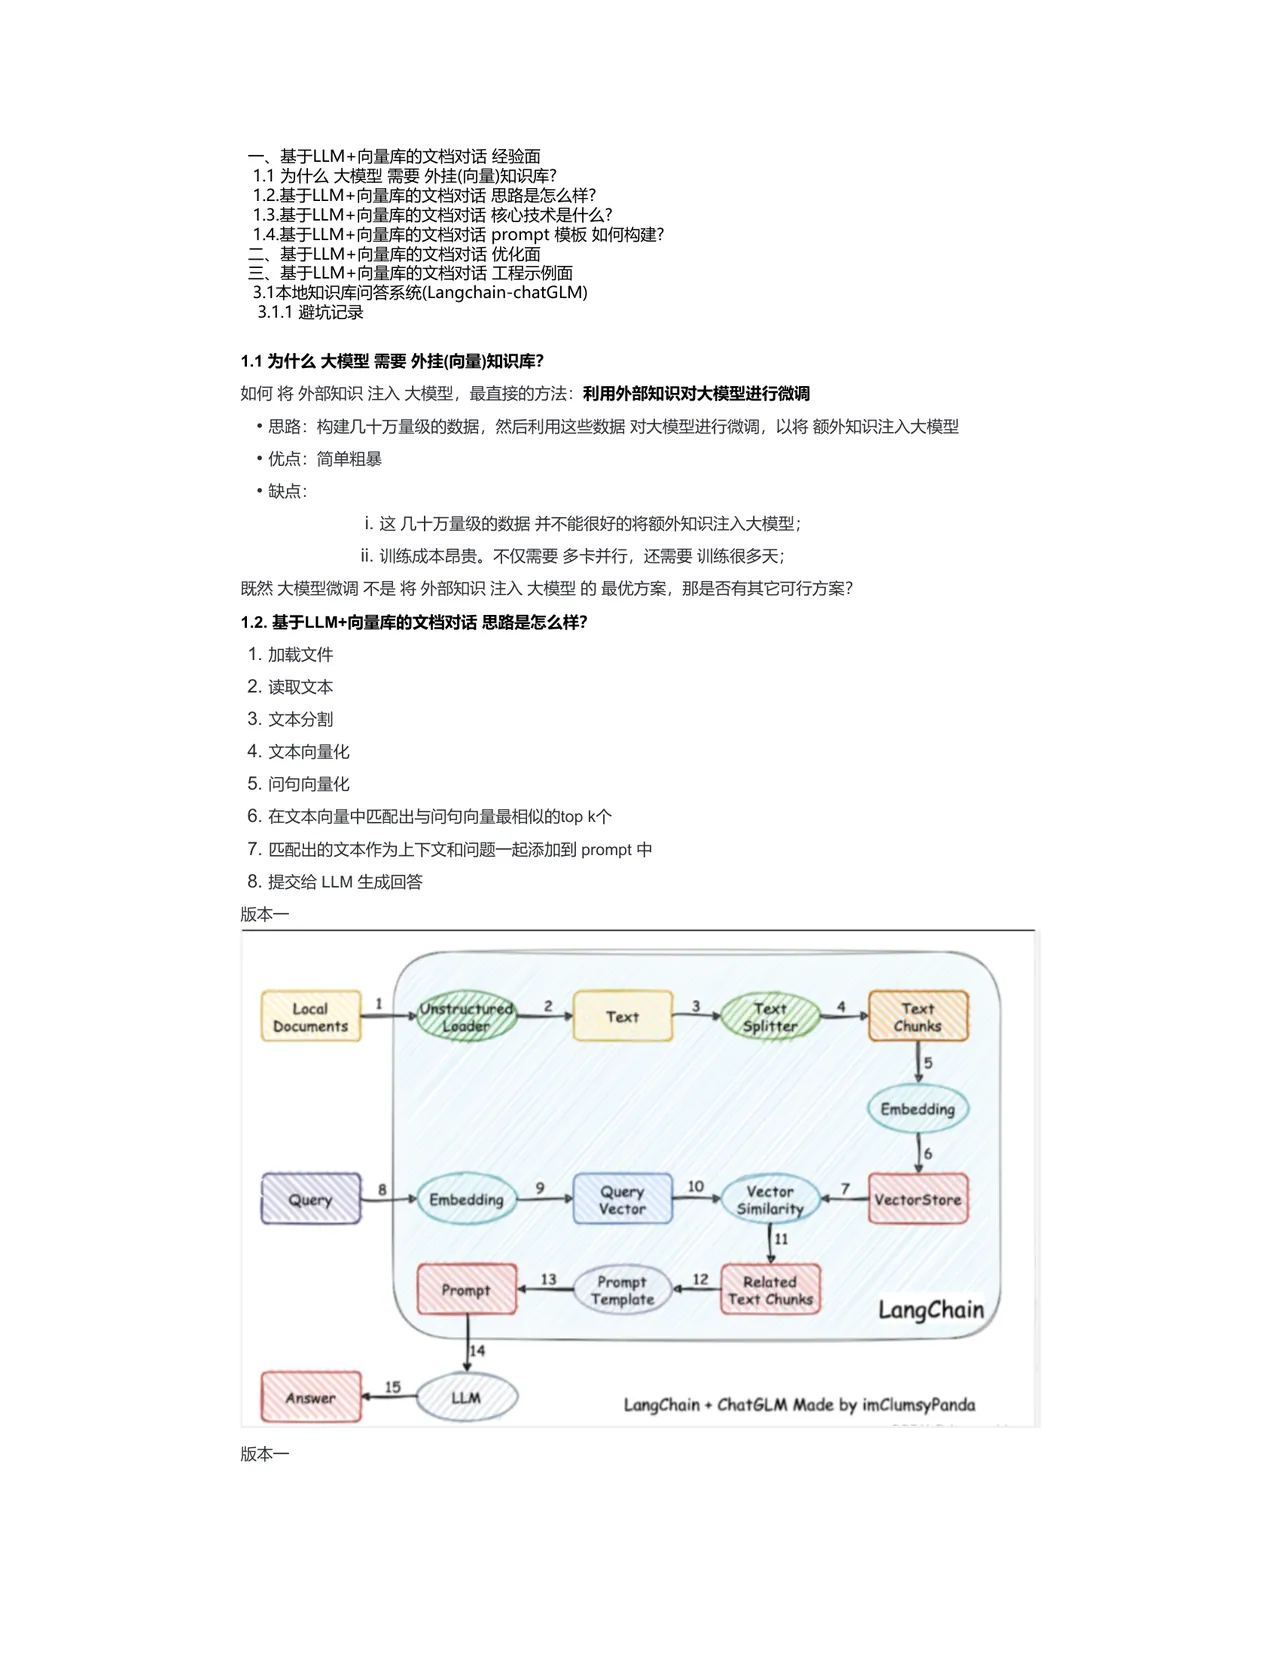
  1. 文本分割 4. 文本向量化 5. 问句向量化 6. 在文本向量中匹配出与问句向量最相似的 top k 个 7.匹配出的文本作为上下文和问题一起添加到 prompt 中 8. 提交给 LLM 生成回答 版本一

Local

Loader

Documents

Embedding Query

Prompt

LLM Answer

版本一

Text

Text

Splitter

Vector

Query Similarity

Vector

Related

[ Text Chunks Template

LangChain + ChatGLM Made by imClumsyPanda

Text Chunks

Embedding

VectorStore

LangChain

022 / 3
第 2 页
第 2 页

本地知识文件 读取内容 (txt/d…

本地知识文件 读取内容 (txt/doc/pdf 等)

构成 Documents 文本切分

得到每个 Documents 的 embedding

构建 Faiss 察引

用 context 和 query 填充 prompt 模板,得到 给到 LLM,得到结果 给 LLM 的 prompt 1.3. 基于 LLM+向量库的文档对话核心技术是什么?

  • 基于 LLM+向量库的文档对话核心技术:embedding
  • 思路:将用户知识库内容经过 embedding 存入向量知识库,然后用户每一次提问也会经过 embedding,利 用向量相关性算法(例如余弦算法)找到最匹配的几个知识库片段,将这些知识库片段作为上下文,与用户

问题一起作为 promt 提交给 LLM 回答 1.4. 基于 LLM+向量库的文档对话 prompt 模板如何构建? 已知信息: { context }

根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说“根据已 知信息无法回答该问题”或“没有提供足够的相关信息”,不允许在答案中添加编造成分, 答案请使用中文。 问题是:{ question } 二、基于 LLM+向量库的文档对话优化面 痛点 1:文档切分粒度不好把控,既担心噪声太多又担心语义信息丢失 问题描述 问题 1:如何让 LLM 简要、准确回答细粒度知识? •举例及标答如下:

输入的 query

得到每个 query 的 embedding

进行 Faiss 搜索

得到 Top K 个相关的 Document

将 Document 的文本进行拼接,得到

033 / 3
第 3 页
第 3 页

7 月 17 日,国务院新闻办公室举…

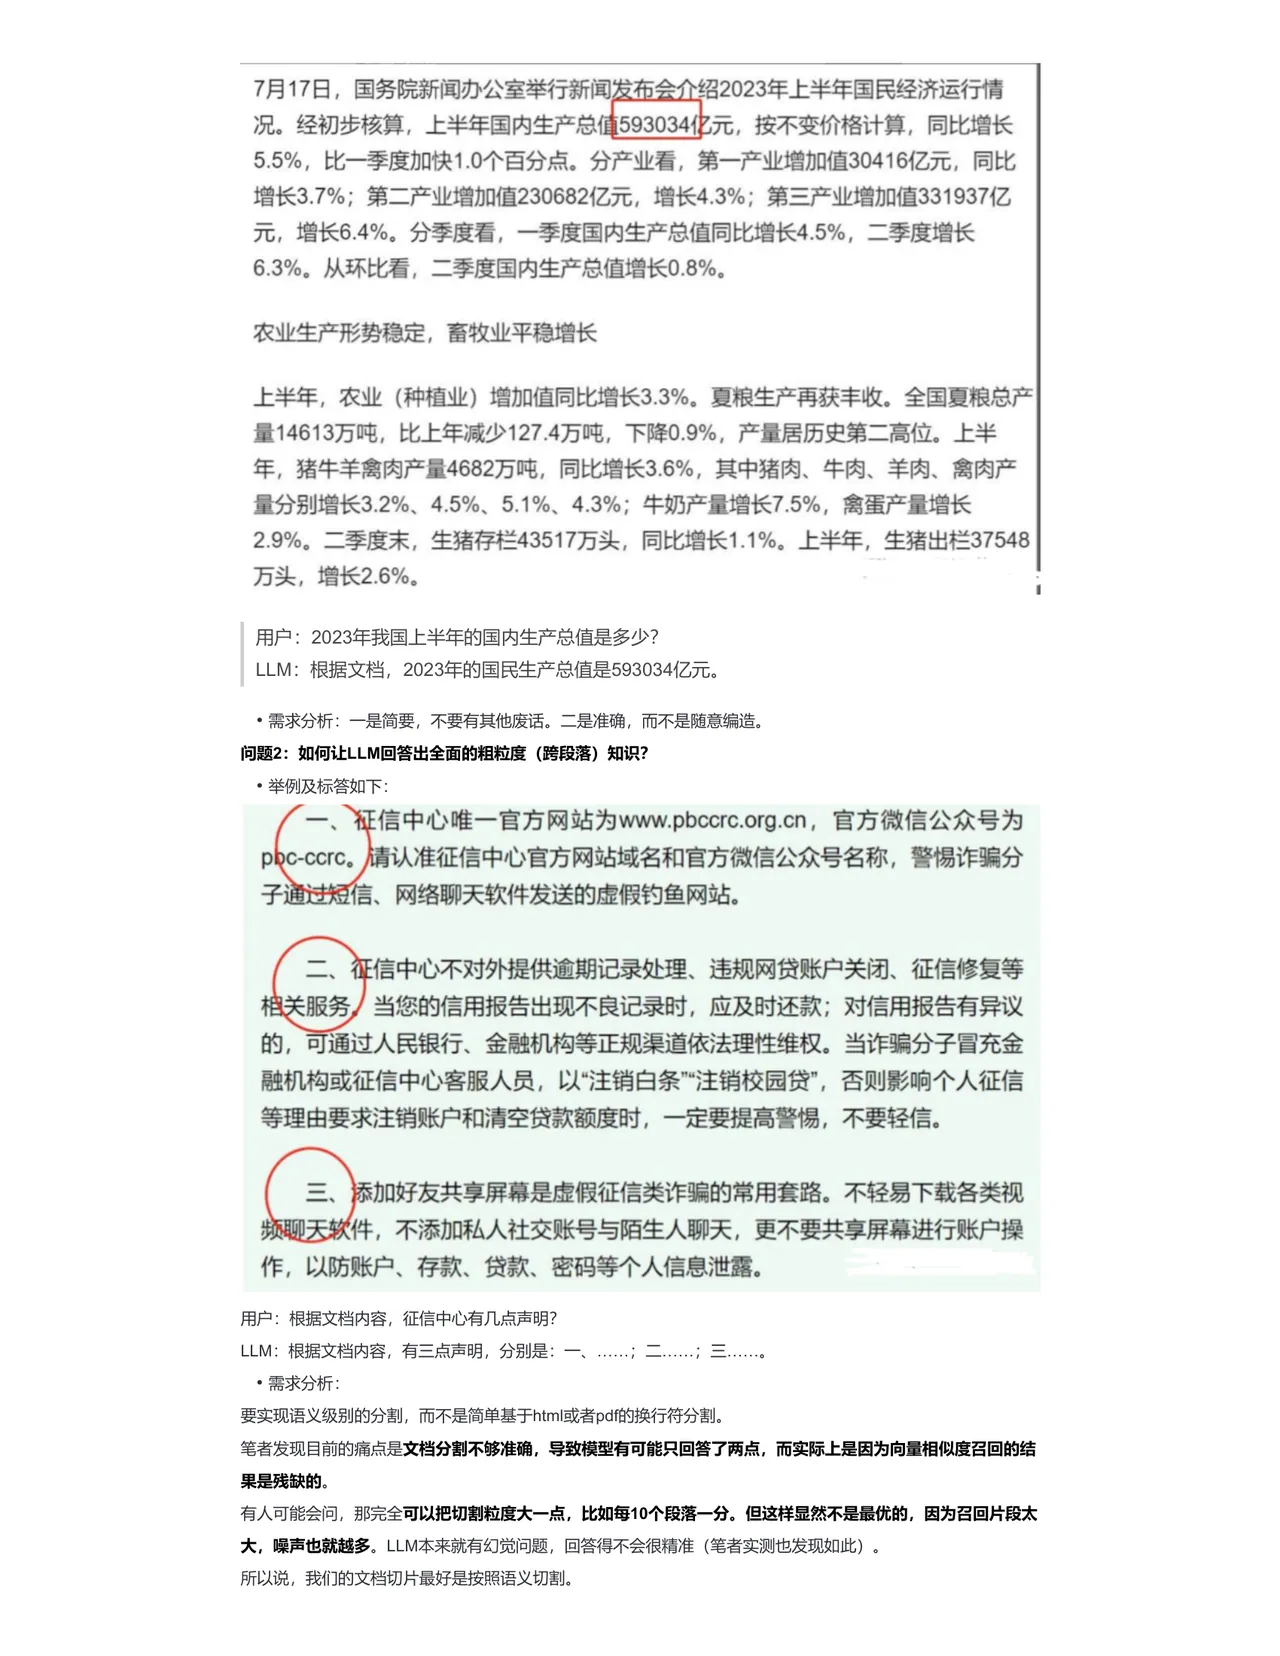
7 月 17 日,国务院新闻办公室举行新闻发布会介绍 2023 年上半年国民经济运行情 况。经初步核算,上半年国内生产总值 593034 亿元,按不变价格计算,同比增长 5.5%,比一季度加快 1.0 个百分点。分产业看,第一产业增加值 30416 亿元,同比 增长 3.7%;第二产业增加值 230682 亿元,增长 4.3%;第三产业增加值 331937 亿 元,增长 6.4%。分季度看,一季度国内生产总值同比增长 4.5%,二季度增长 6.3%。从环比看,二季度国内生产总值增长 0.8%。 农业生产形势稳定,畜牧业平稳增长 上半年,农业(种植业)增加值同比增长 3.3%。夏粮生产再获丰收。全国夏粮总产 量 14613 万吨,比上年减少 127.4 万吨,下降 0.9%,产量居历史第二高位。上半 年,猪牛羊离肉产量 4682 万吨,同比增长 3.6%,其中猪肉、牛肉、羊肉、禽肉产 量分别增长 3.2%、4.5%、5.1%、4.3%;牛奶产量增长 7.5%,禽蛋产量增长 2.9%。二季度末,生猪存栏 43517 万头,同比增长 1.1%。上半年,生猪出栏 37548 万头,增长 2.6%。

用户:2023 年我国上半年的国内生产总值是多少? LLM:根据文档,2023 年的国民生产总值是 593034 亿元。 •需求分析:一是简要,不要有其他废话。二是准确,而不是随意编造。 问题 2:如何让 LLM 回答出全面的粗粒度(跨段落)知识?

一、征信中心唯一官方网站为 www.pbccrc.org.cn,官方微信公众号为 Pbc-ccrC。请认准征信中心官方网站域名和官方微信公众号名称,警惕诈骗分 子通过短信、网络聊天软件发送的虚假钓鱼网站。 二、征信中心不对外提供逾期记录处理、违规网贷账户关闭、征信修复等 相关服务/当您的信用报告出现不良记录时,应及时还款;对信用报告有异议 的,可通过人民银行、金融机构等正规渠道依法理性维权。当诈骗分子冒充金 融机构或征信中心客服人员,以“注销白条™注销校园贷”,否则影响个人征信 等理由要求注销账户和清空贷款额度时,一定要提高警惕,不要轻信。 三,添加好友共享屏幕是虚假征信类诈骗的常用套路。不轻易下载各类视 频聊天软件,不添加私人社交账号与陌生人聊天,更不要共享屏幕进行账户操 作,以防账户、存款、贷款、密码等个人信息泄露。 用户:根据文档内容,征信中心有几点声明? LLM:根据文档内容,有三点声明,分别是:一.….;二….;三…⋯。

要实现语义级别的分割,而不是简单基于 html 或者 pdf 的换行符分割。 笔者发现目前的痛点是文档分割不够准确,导致模型有可能只回答了两点,而实际上是因为向量相似度召回的结 果是残缺的。 有人可能会问,那完全可以把切割粒度大一点,比如每 10 个段落一分。但这样显然不是最优的,因为召回片段太 大,噪声也就越多。LLM 本来就有幻觉问题,回答得不会很精准(笔者实测也发现如此)。 所以说,我们的文档切片最好是按照语义切割。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求