- 直接检索前两个节点,不进行重新排名,这可能导致不准确的检索结果。
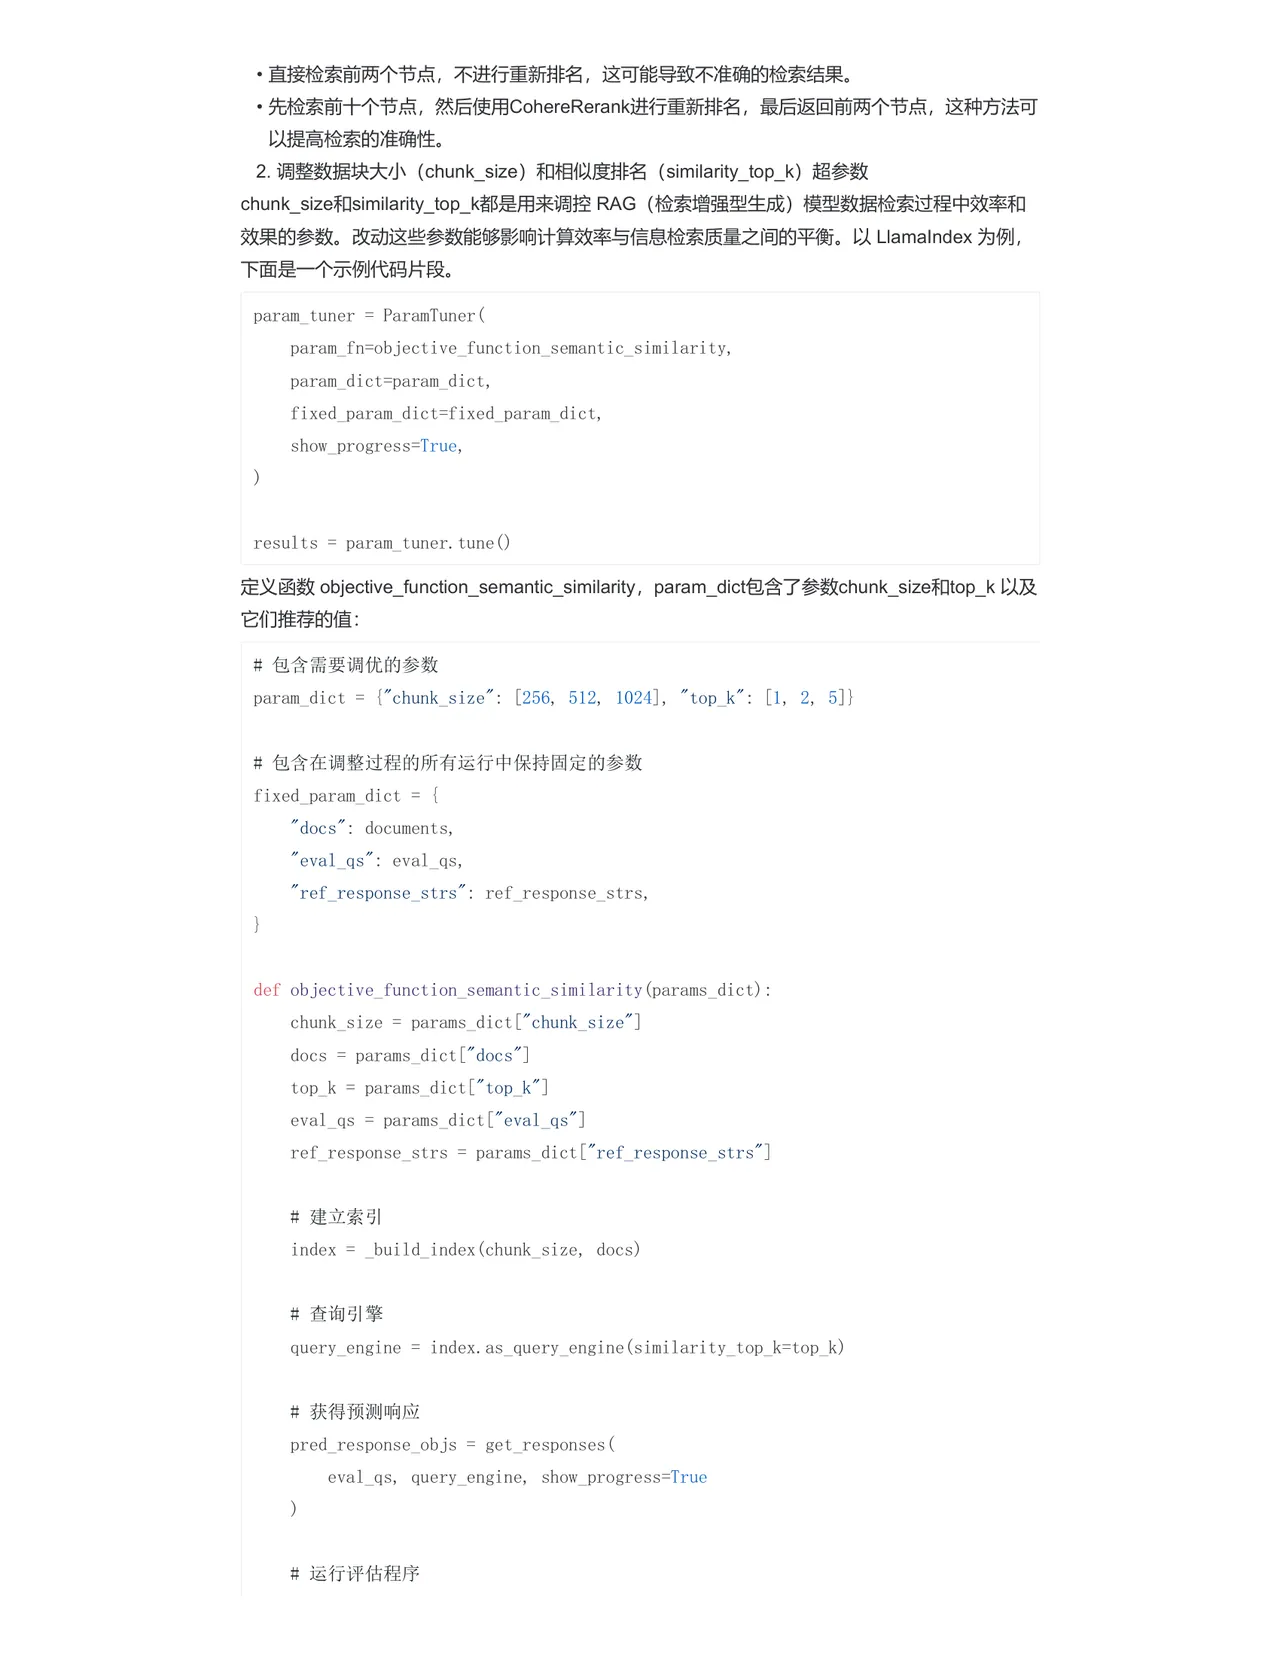
- 先检索前十个节点,然后使用 CohereRerank 进行重新排名,最后返回前两个节点,这种方法可 以提高检索的准确性。 2.调整数据块大小(chunk_size)和相似度排名(similarity_top_k)超参数 chunk_Size 和 similarity_top_k 都是用来调控 RAG (检索增强型生成)模型数据检索过程中效率和 效果的参数。改动这些参数能够影响计算效率与信息检索质量之间的平衡。以 Llamalndex 为例, 下面是一个示例代码片段。 param_tuner = ParamTuner ( param_fn=objective_function_semantic_similarity, param_dict=param_dict, fixed_param_dict=fixed_param_dict, show_progress=True,
results = param_tuner. tune ()
定义函数 objective_function_semantic_similarity, param_dict 包含了参数 chunk_size 和 t0p_K 以及 它们推荐的值: # 包含需要调优的参数
#包含在调整过程的所有运行中保持固定的参数
fixed param dict = {
"docs”:documents,
"ref_response_strs”:ref_response_strs,
def objective_function_semantic_similarity (params_dict): size = params_dict ["chunk_size"]
chunk
docs = params_dict ["docs"]
top_k = params_dict ["top k"]
eval_qs = params_dict ["eval_qs"] ref_response_strs = params_dict ["ref_response_strs"]
index = _build_index (chunk_size, docs)
query_engine = index.as_query_engine (similarity_top_k=top_k)
# 获得预测响应 pred_response_objs = get_responses ( eval_qs, query_engine, show_progress=True
# 运行评估程序