RAG 与知识库面试题图文讲义2007 字

大模型外挂知识库优化面试题

·全库 168 / 611

《大模型外挂知识库优化面试题》共 5 页、0.2 万字,通篇围绕 召回、向量、微调、量化 展开,归在「RAG 与知识库」这一层。

覆盖召回向量微调量化prompt知识库

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(5 节)
  1. 一、为什么需要使用大模型辅助召回?
  2. 策略一:HYDE
  3. Search results: Dx
  4. a law degree.
  5. Retriever

原 PDF 已逐页还原成图,共 5 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01大模型外挂知识库优化——如何利用大模…
  2. 024.利用融合向量 v 从文档库中召回…
  3. 03对于大模型外挂知识库,大家通常的做法…
011 / 3
第 1 页
第 1 页

大模型外挂知识库优化——如何利用大模…

  • 大模型外挂知识库优化——如何利用大模型辅助召回?
  • 一、为什么需要使用大模型辅助召回?
  • 策略一:HYDE
  • 1.介绍一下 HYDE 思路?
  • 2.介绍一下 HYDE 问题?
  • 策略二:FLARE
  • 1.为什么需要 FLARE?
  • 2. FLARE 有哪些召回策略?
  • 2.1 策略
  • 2.1.1 策略 1 思路?
  • 2.1.2 策略 1 缺陷?
  • 2.2 策略
  • 2.2.1 策略 2 思路?

一、为什么需要使用大模型辅助召回?

我们可以通过向量召回的方式从文档库里召回和用户问题相关的文档片段,同时输入到 LLM 中,增 强模型回答质量。 常用的方式直接用用户的问题进行文档召回。但是很多时候,用户的问题是十分口语化的,描述的 也比较模糊,这样会影响向量召回的质量,进而影响模型回答效果。

策略一:HYDE

  • 论文:《 Precise Zero-Shot Dense Retrieval without Relevance Labels 》
  • 论文地址:https://arxiv.org/pdf/2212.10496.pdf
  1. 介绍一下 HYDE 思路? 1.用 LLM 根据用户 query 生成 k 个“假答案”。(大模型生成答案采用 sample 模式,保证生成的 k 个 答案不一样。此时的回答内容很可能是存在知识性错误,因为如果能回答正确,那就不需要召 回补充额外知识了对吧。不过不要紧,我们知识想通过大模型去理解用户的问题,生成一些“看 起来”还不错的假答案) 2. 利用向量化模型,将生成的 k 的假答案和用户的 query 变成向量; 3.将 k+1 个向量取平均:其中 dk 为第 k 个生成的答案,q 为用户问题,f 为向量化操作。
022 / 3
第 2 页
第 2 页

4.利用融合向量 v 从文档库中召回…

DL19

44.5 62.1

48.9 53.8 61.3 60.2 61.4 67.4

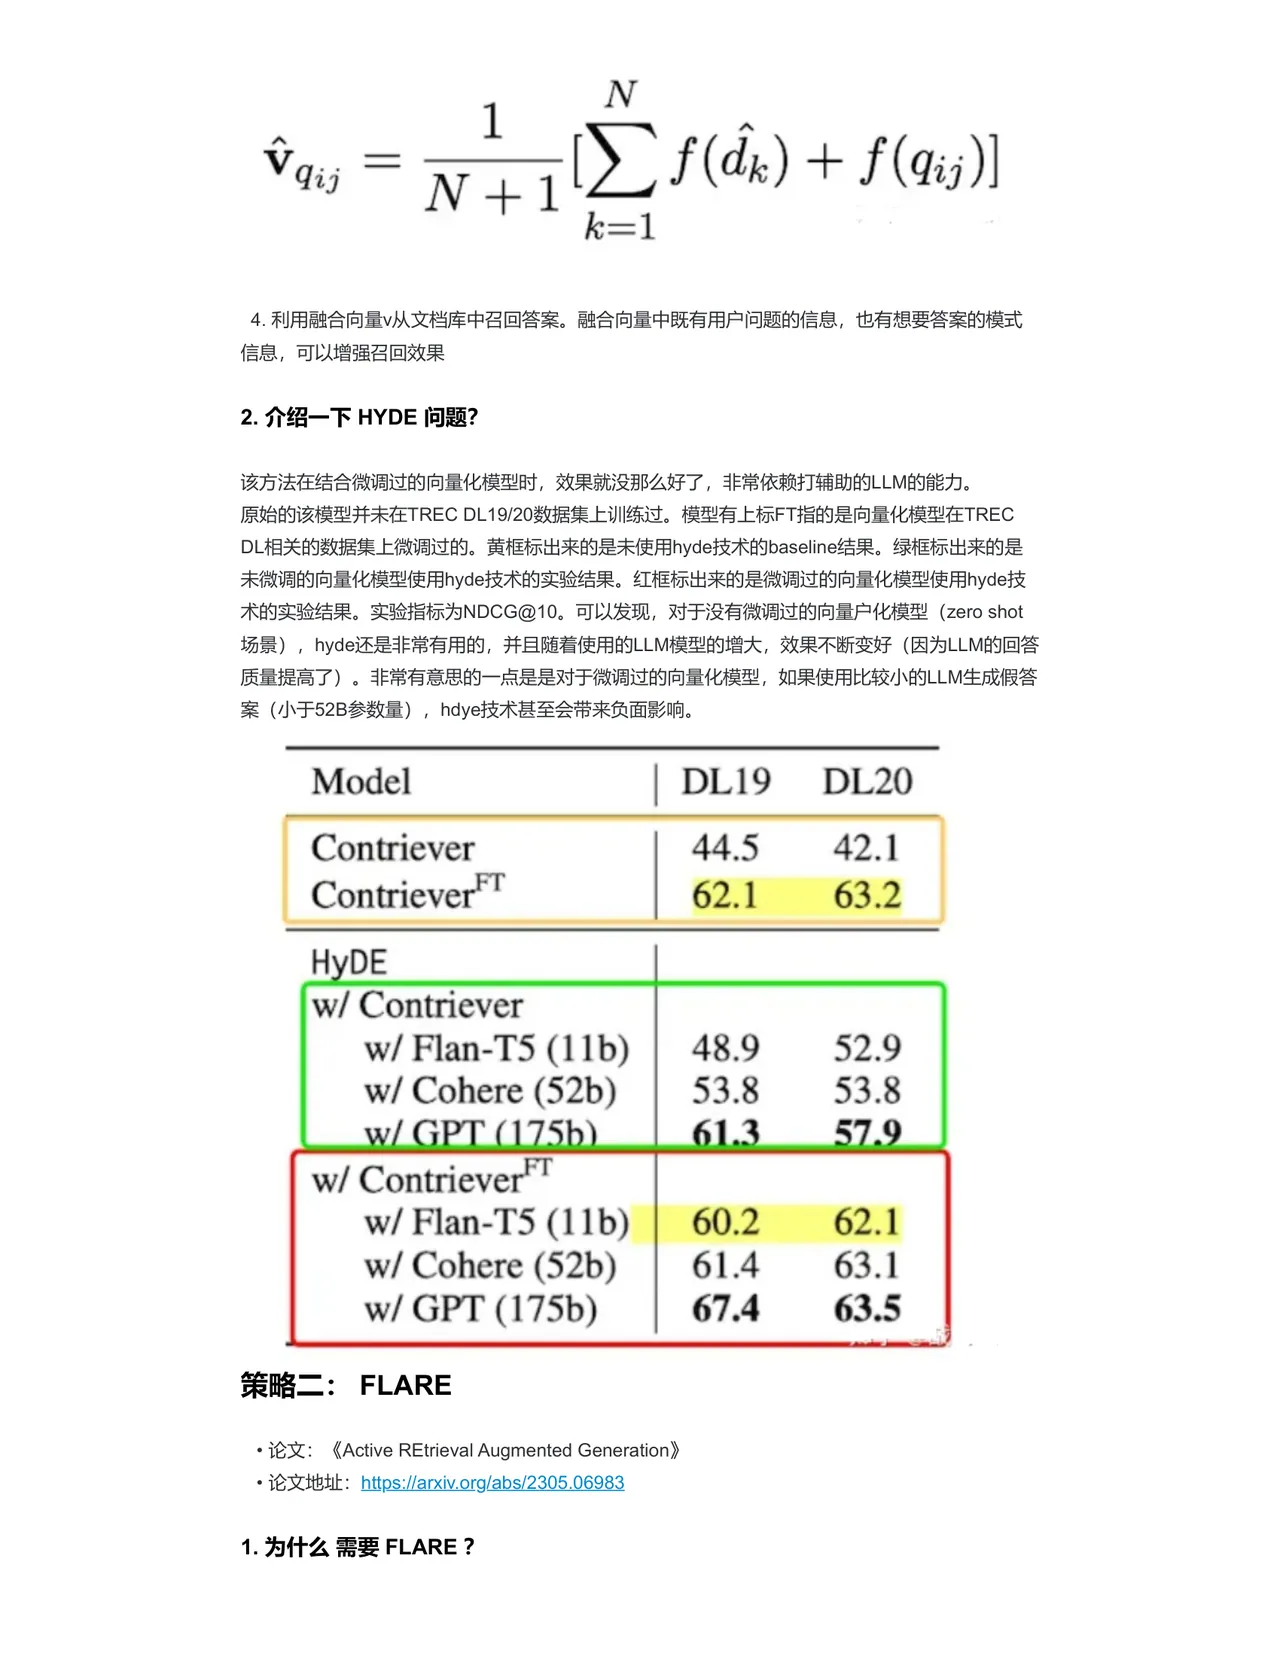
4.利用融合向量 v 从文档库中召回答案。融合向量中既有用户问题的信息,也有想要答案的模式 信息,可以增强召回效果 2.介绍一下 HYDE 问题? 该方法在结合微调过的向量化模型时,效果就没那么好了,非常依赖打辅助的 LLM 的能力。 原始的该模型并未在 TREC DL19/20 数据集上训练过。模型有上标 FT 指的是向量化模型在 TREC DL 相关的数据集上微调过的。黄框标出来的是未使用 hyde 技术的 baseline 结果。绿框标出来的是 未微调的向量化模型使用 hyde 技术的实验结果。红框标出来的是微调过的向量化模型使用 hyde 技 术的实验结果。实验指标为 NDCG@10。可以发现,对于没有微调过的向量户化模型(zero shot 场景),hyde 还是非常有用的,并且随着使用的 LLM 模型的增大,效果不断变好(因为 LLM 的回答 质量提高了)。非常有意思的一点是是对于微调过的向量化模型,如果使用比较小的 LLM 生成假答 案(小于 52B 参数量),hdye 技术甚至会带来负面影响。 Model Contriever

Contriever™T

w/ Contriever w/ Flan-T5 (11b) w/ Cohere (52b)

w/ GPT (175b) w/ Contriever 印 T w/ Flan-T5 (11b) w/ Cohere (52b)

策略二:FLARE

  • 论文:《 Active REtrieval Augmented Generation 》
  • 论文地址:https://arxiv.org/abs/2305.06983

1.为什么需要 FLARE?

DL20 42.1 63.2

52.9 53.8 57.9 62.1 63.1 63.5

033 / 3
第 3 页
第 3 页

对于大模型外挂知识库,大家通常的做法…

对于大模型外挂知识库,大家通常的做法是根据用户 query 一次召回文档片段,让模型生成答案。 只进行一次文档召回在长文本生成的场景下效果往往不好,生成的文本过长,更有可能扩展出和 query 相关性较弱的内容,如果模型没有这部分知识,容易产生模型幻觉问题。一种解决思路是随 着文本生成,多次从向量库中召回内容。 2. FLARE 有哪些召回策略?

1.每生成固定的 n 个 token 就召回一次; 2. 每生成一个完整的句子就召回一次; 3.用户 query 一步步分解为子问题,需要解答当前子问题时候,就召回一次 已有的多次召回方案比较被动,召回文档的目的是为了得到模型不知道的信息,a、b 策略并不能保 证不需要召回的时候不召回,需要召回的时候触发召回。c.方案需要设计特定的 prompt 工程,限制 了其通用性。 作者在本文里提出了两种更主动的多次召回策略,让模型自己决定啥时候触发召回操作。

2.1 策略

2.1.1 策略 1 思路?

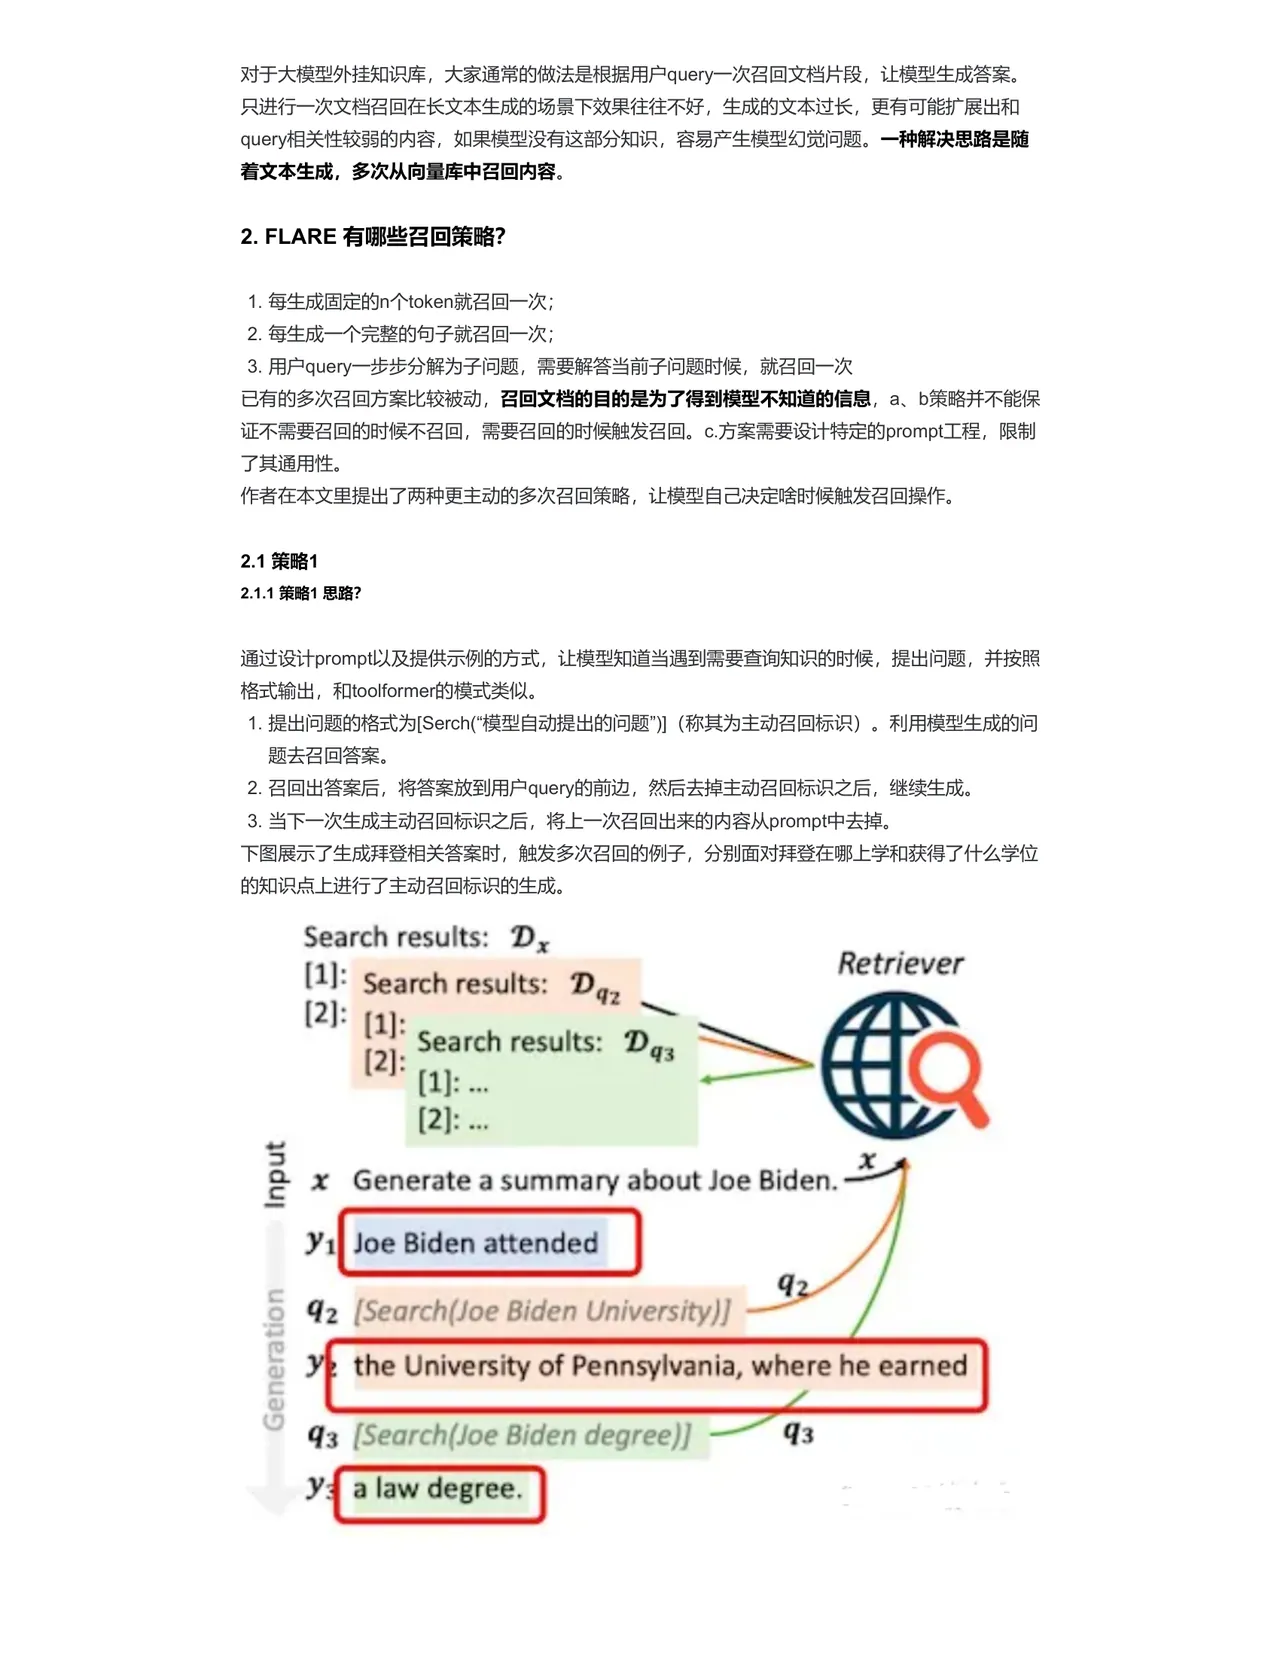
通过设计 prompt 以及提供示例的方式,让模型知道当遇到需要查询知识的时候,提出问题,并按照 格式输出,和 toolformer 的模式类似。 1. 提出问题的格式为[ Serch (“模型自动提出的问题")](称其为主动召回标识)。利用模型生成的问 题去召回答案。 2.召回出答案后,将答案放到用户 query 的前边,然后去掉主动召回标识之后,继续生成。 3.当下一次生成主动召回标识之后,将上一次召回出来的内容从 prompt 中去掉。 下图展示了生成拜登相关答案时,触发多次召回的例子,分别面对拜登在哪上学和获得了什么学位 的知识点上进行了主动召回标识的生成。

Search results: Dx

  • Generate a summary about Joe Biden. Joe Biden attended

92 [ Search (Joe Biden University// the University of Pennsyivania, where he earned

a law degree.

Retriever

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求