RAG 与知识库面试题图文讲义1486 字

Graph RAG面试题

·全库 167 / 611

《Graph RAG面试题》共 5 页、0.1 万字,通篇围绕 RAG、embedding、召回、检索 展开,归在「RAG 与知识库」这一层。

覆盖RAGembedding召回检索上下文幻觉

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(6 节)
  1. Tell me about Peter Quill2
  2. Rendered Graph
  3. 用户输入:Tell me events about NASA
  4. nasa [' public release date'
  5. RAG Subgraph Query (depth=2)
  6. Rendered Grapn

原 PDF 已逐页还原成图,共 5 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01Graph RAG (Retriev…
  2. 021.使用 LLM (或其他)模型从问…
  3. 03送入 LLM 完成问答。
011 / 3
第 1 页
第 1 页

Graph RAG (Retriev…

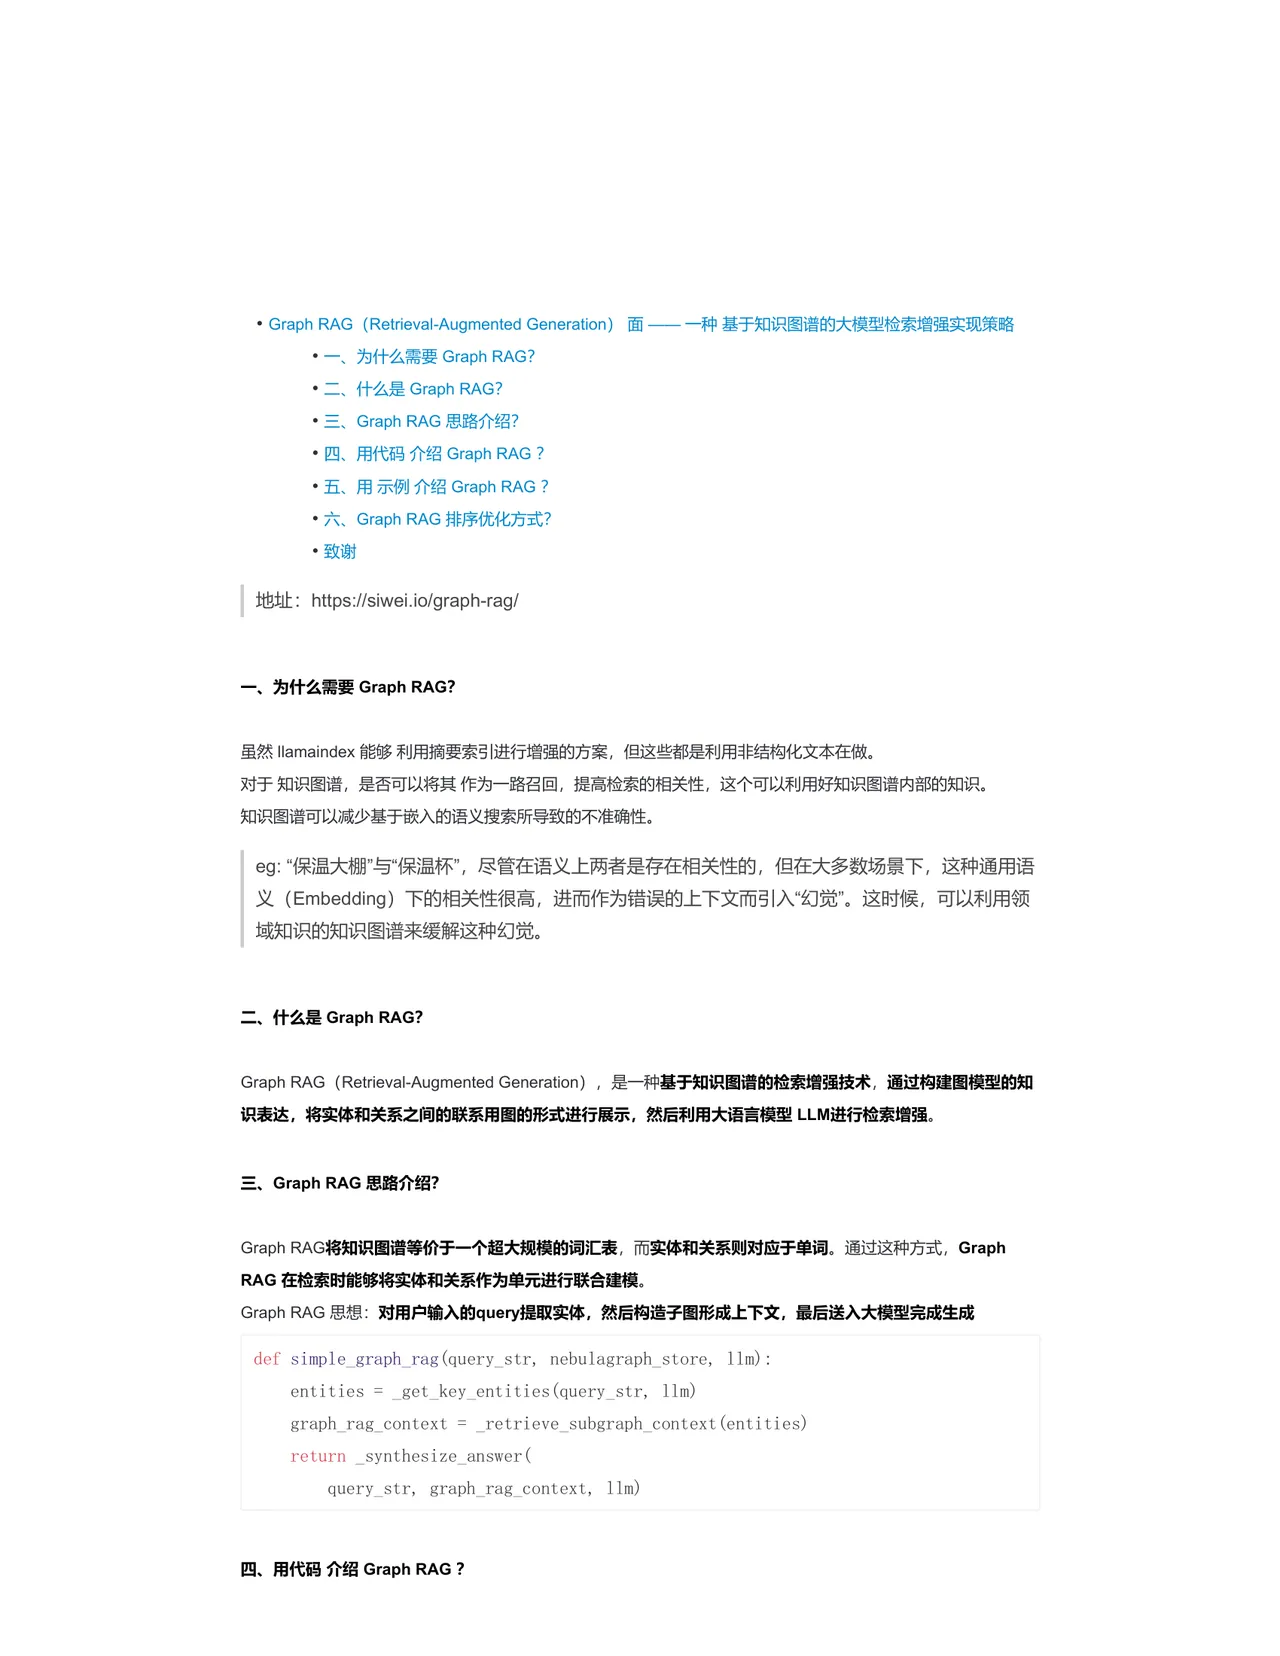
•Graph RAG (Retrieval-Augmented Generation)面——一种基于知识图谱的大模型检索增强实现策略

  • 一、为什么需要 Graph RAG?
  • 二、什么是 Graph RAG?
  • 三、Graph RAG 思路介绍?
  • 四、用代码介绍 Graph RAG?
  • 五、用示例介绍 Graph RAG?

•六、Graph RAG 排序优化方式?

地址:https://siwei.io/graph-rag/

一、为什么需要 Graph RAG?

虽然 Ilamaindex 能够利用摘要索引进行增强的方案,但这些都是利用非结构化文本在做。 对于知识图谱,是否可以将其作为一路召回,提高检索的相关性,这个可以利用好知识图谱内部的知识。 知识图谱可以减少基于嵌入的语义搜索所导致的不准确性。 eg:“保温大棚”与“保温杯”,尽管在语义上两者是存在相关性的,但在大多数场景下,这种通用语 义(Embedding)下的相关性很高,进而作为错误的上下文而引入“幻觉”。这时候,可以利用领 域知识的知识图谱来缓解这种幻觉。

二、什么是 Graph RAG?

Graph RAG (Retrieval-Augmented Generation),是一种基于知识图谱的检索增强技术,通过构建图模型的知 识表达,将实体和关系之间的联系用图的形式进行展示,然后利用大语言模型 LLM 进行检索增强。

三、Graph RAG 思路介绍?

Graph RAG 将知识图谱等价于一个超大规模的词汇表,而实体和关系则对应于单词。通过这种方式,Graph RAG 在检索时能够将实体和关系作为单元进行联合建模。 Graph RAG 思想:对用户输入的 query 提取实体,然后构造子图形成上下文,最后送入大模型完成生成

def simple_graph_rag (query_str, nebulagraph_store, 11m): entities = _get_key_entities (query_str, 11m) graph_rag_context =_retrieve_subgraph_context (entities)

return_synthesize_answer ( query_str, graph_rag_context, 11m)

四、用代码介绍 Graph RAG?

022 / 3
第 2 页
第 2 页

1.使用 LLM (或其他)模型从问…

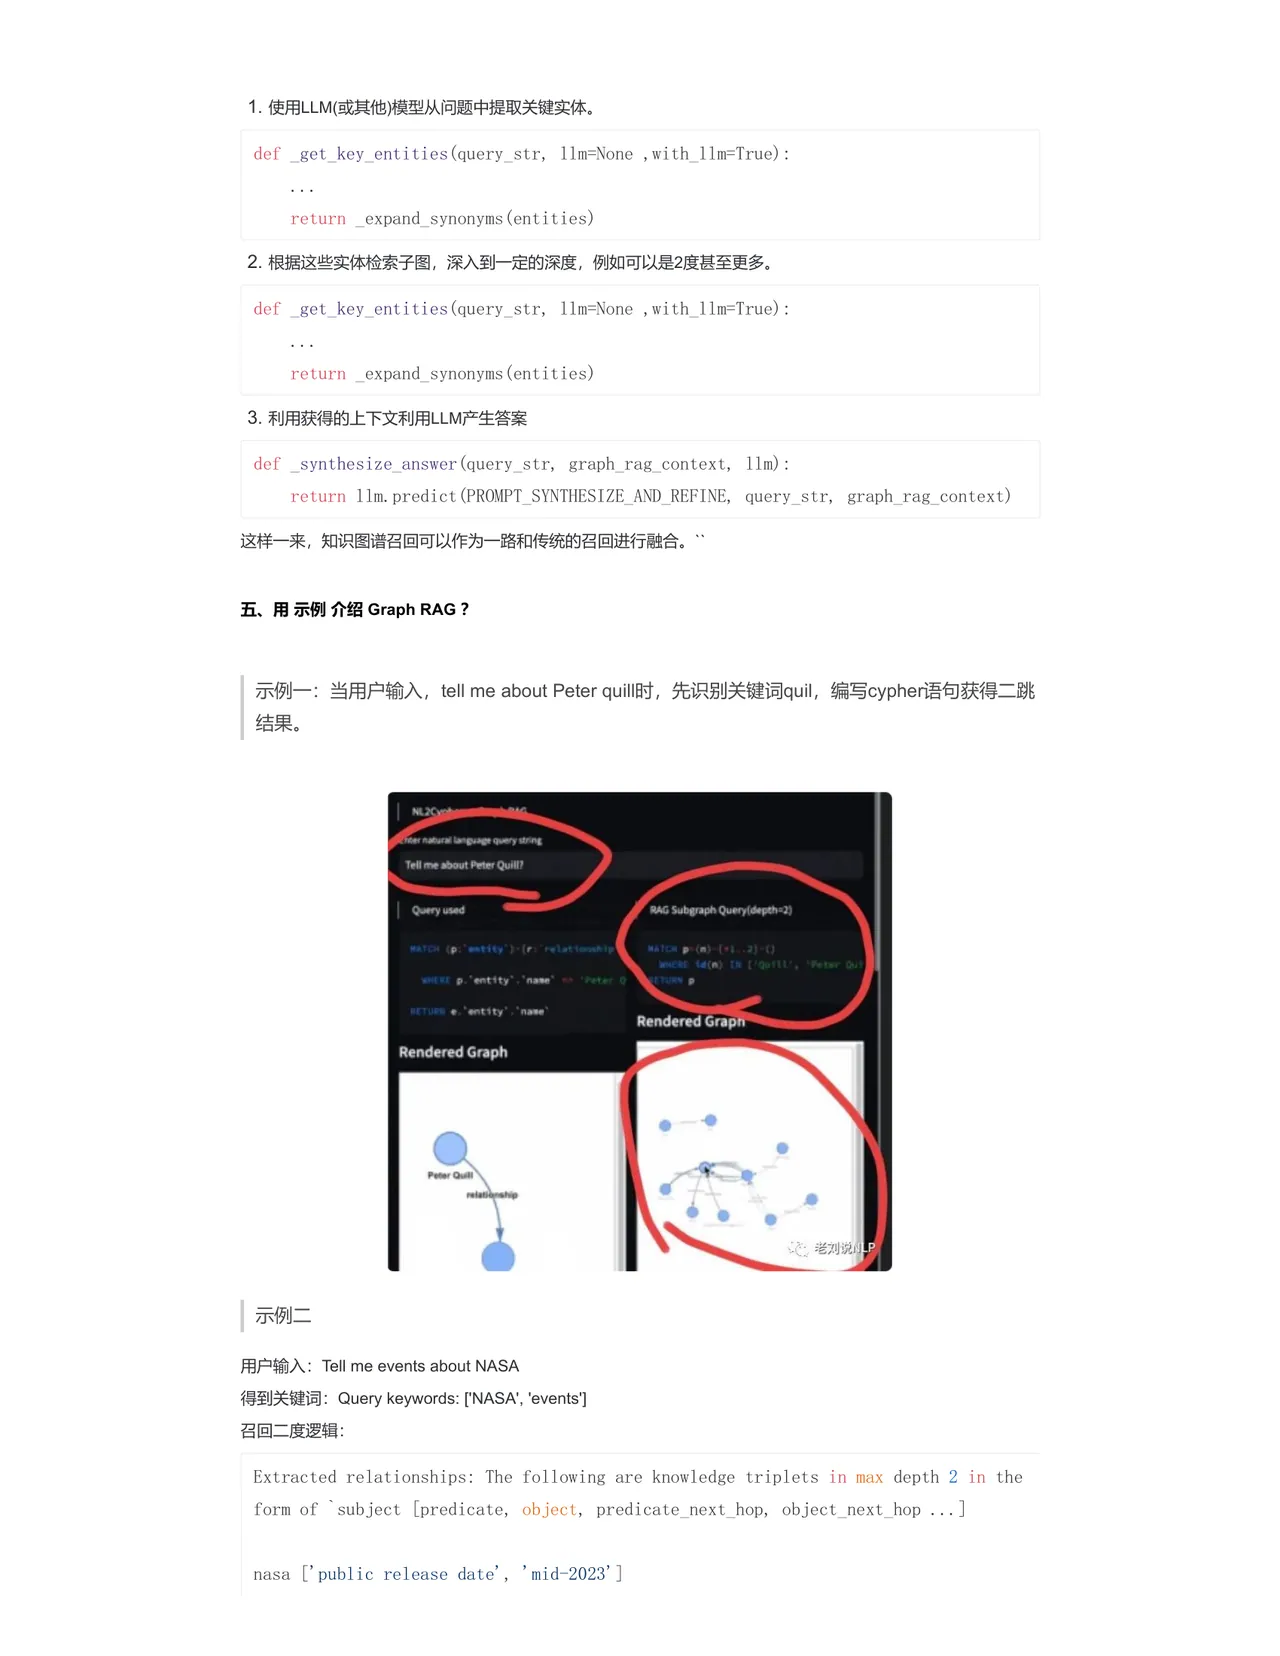
1.使用 LLM (或其他)模型从问题中提取关键实体。

return _expand_synonyms (entities) 2. 根据这些实体检索子图,深入到一定的深度,例如可以是 2 度甚至更多。 def _get_key_entities (query_str, 1Im=None , with_11m-True):

return _expand_synonyms (entities) 3. 利用获得的上下文利用 LLM 产生答案

def

_synthesize_answer (query_str, graph_rag_context, 11m): return 1lm.predict (PROMPT_SYNTHESIZE_AND_REFINE, query_str, graph_rag_context) 这样一来,知识图谱召回可以作为一路和传统的召回进行融合。“

五、用示例介绍 Graph RAG?

示例一:当用户输入,tell me about Peter quil 时,先识别关键词 quil,编写 cypher 语句获得二跳 结果。

Tell me about Peter Quill2

Rendered Graph

示例二

用户输入:Tell me events about NASA

得到关键词:Query keywords:[ NASA,'events ] 召回二度逻辑: Extracted relationships: The following are knowledge triplets in max depth 2 in the form of, subject [ predicate, object, predicate_next_hop, object_next_hop ... ]

nasa [' public release date'

RAG Subgraph Query (depth=2)

Rendered Grapn

033 / 3
第 3 页
第 3 页

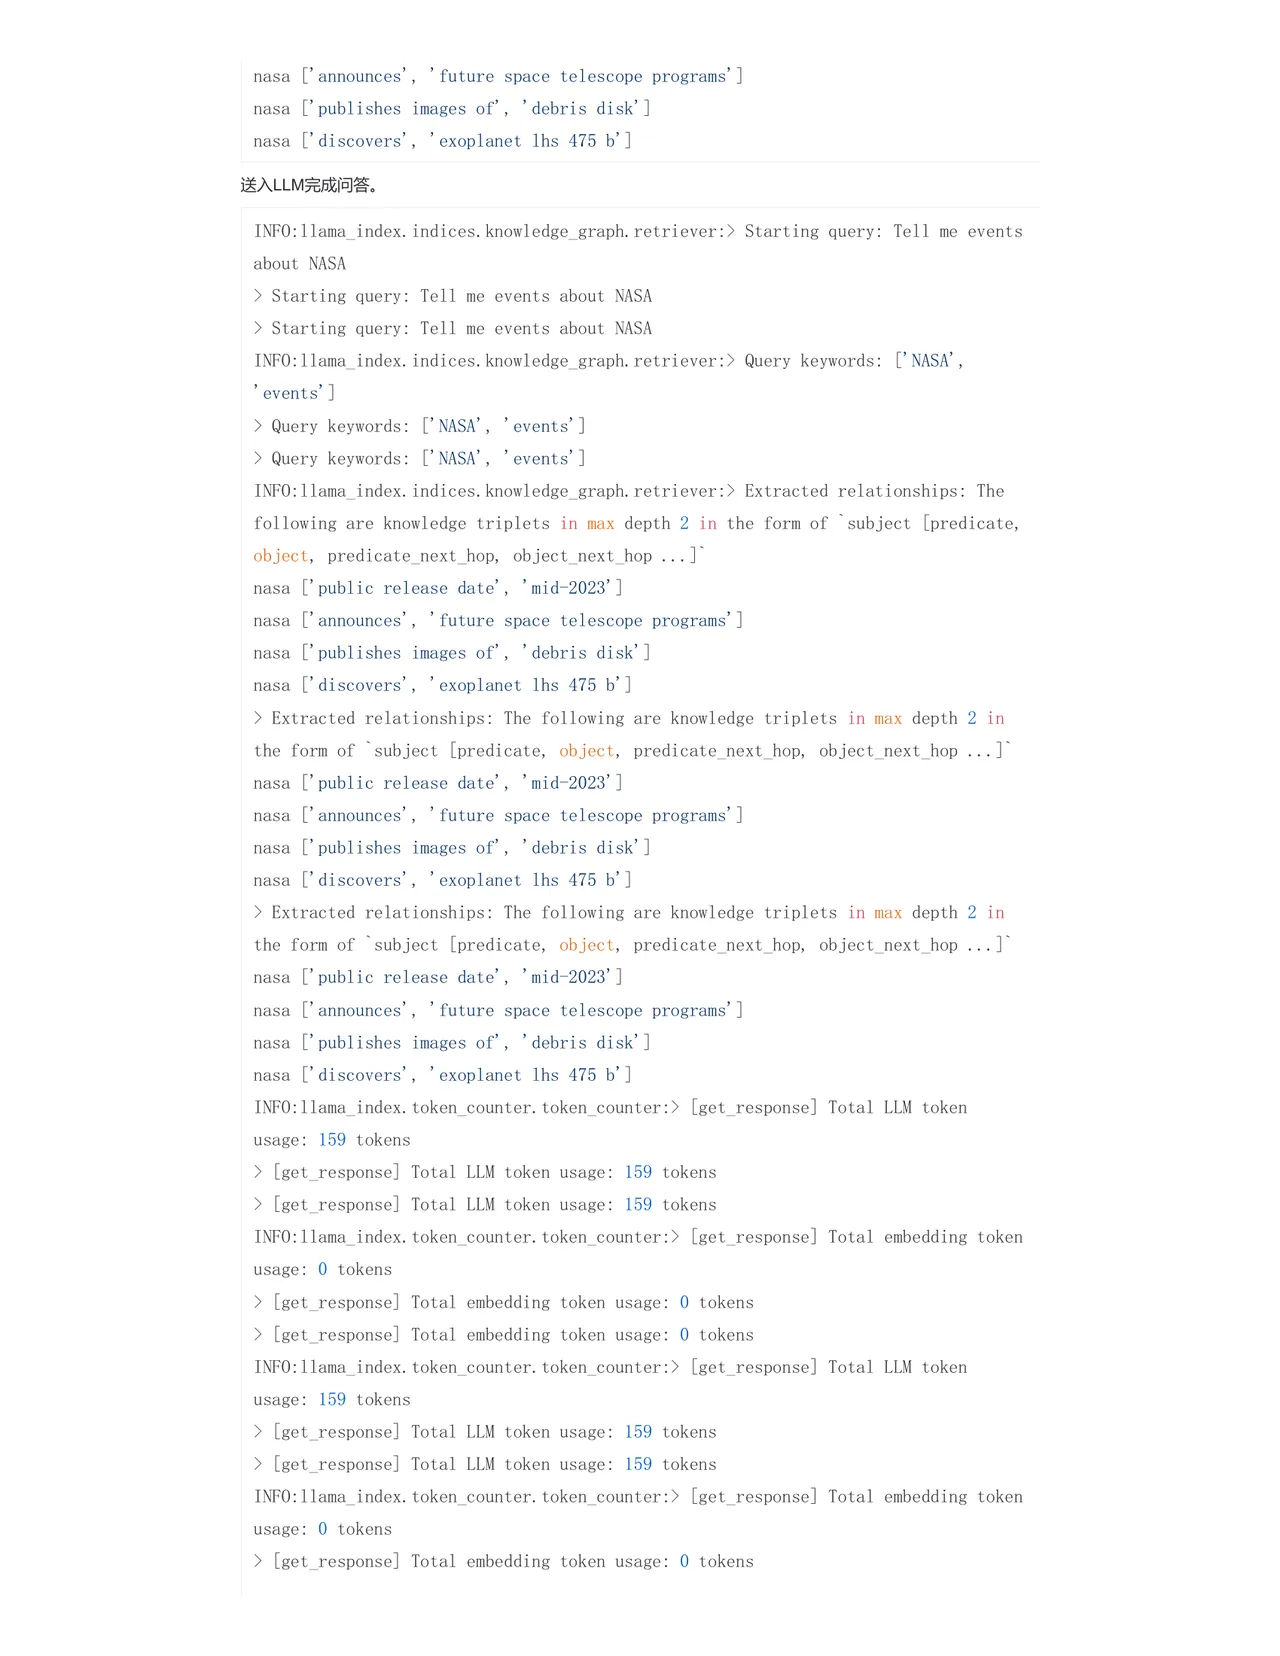
送入 LLM 完成问答。

nasa ['announces’','future space telescope programs'] nasa ['publishes images of’,'debris disk']

送入 LLM 完成问答。

INFO:1lama_index.indices. knowledge_graph. retriever:> Starting query: Tell me events about NASA > Starting query: Tell me events about NASA > Starting query: Tell me events about NASA

INFO:llama_index.indices.knowledge_graph.retriever:〉 Query keywords:['NASA’,

Query keywords:['NASA’,'events' ] > Query keywords:['NASA’,'events']

INFO:1lama_index. indices. knowledge_graph. retriever:> Extracted relationships: The

following are knowledge triplets in max depth 2 in the form ofsubject [ predicate,

object, predicate_next_hop, object_next_hop ...]] nasa ['public release date','mid-2023’] nasa [' announces’,'future space telescope programs'] nasa ['publishes images of’,'debris disk'] nasa ['discovers’,'exoplanet Ihs 475 b’]

Extracted relationships: The following are knowledge triplets in max depth 2 in

the form of“subject [ predicate, object, predicate_next_hop, object_next_hop ...]) nasa ['public release date','mid-2023'] nasa [' announces’,'future space telescope programs'] nasa ['publishes images of’,'debris disk'] nasa ['discovers’,'exoplanet Ihs 475 b’]

Extracted relationships: The following are knowledge triplets in max depth 2 in

the form ofsubject [ predicate, object, predicate_next_hop, object_next_hop ...] nasa ['public release date','mid-2023'] nasa ['announces’,'future space telescope programs'] nasa ['publishes images of’,'debris disk']

INFO:11ama_index.token_counter. token_counter:〉[ get_response ] Total LLM token usage: 159 tokens > [ get_response ] Total LLM token usage: 159 tokens > [ get_response ] Total LLM token usage: 159 tokens INFO:11ama_index.token_counter. token_counter:〉 Lget_response ] Total embedding token usage: 0 tokens > [ get_response ] Total embedding token usage: 0 tokens >[ get_response ] Total embedding token usage: 0 tokens INFO:1lama_index.token_counter.token_counter:〉[ get_response ] Total LLM token usage: 159 tokens > Lget_response ] Total LLM token usage: 159 tokens > Lget_response ] Total LLM token usage: 159 tokens INFO:11ama_index.token_counter. token_counter:〉 Lget_response」Total embedding token usage: 0 tokens > Lget_response」Total embedding token usage: 0 tokens

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求