
哈啰出行分布式消息治理最佳实践
《哈啰出行分布式消息治理最佳实践》共 0.4 万字,通篇围绕 场景、监控、检索、部署 展开,归在「推理、部署与算力」这一层。
适合要把模型跑起来,还得跑得起的人
目录骨架(8 节)
- 消息治理平台设计需要考虑的点
- 尽可能简单易用
- 客户端治理
- 最核心指标聚焦
- 关于告警
- 消息平台图示
- 深入研究 RocketMQ 源码为治理保驾护航
- 应用分级和分组部署
分享内容
- 打造分布式消息治理平台
- RocketMQ 实战踩坑和解决
- 打造微服务高可用治理平台
介绍
哈啰已进化为包括两轮出行(哈啰单车、哈啰助力车、哈啰电动车、小哈换电)、四轮出行(哈啰顺风车、全网叫车、哈啰打车)等的综合化移动出行平台,并向酒店、到店团购等众多本地生活化生态探索。
随着公司业务的不断发展,流量也在不断增长。我们发现生产中的一些重大事故,往往是被突发的流量冲跨的,对流量的治理和防护,保障系统高可用就尤为重要。
服务之间的交互通常可以分为直接调用和通过消息队列解耦的异步调用。他们都可以归为流量调用范畴,本次分享就哈啰在消息流量和微服务调用的治理中踩过的坑、积累的经验一个分享。
聊聊治理这件事
治理在干一件什么事?
- 让我们的环境变得美好一些
需要知道哪些地方还不够好?
- 以往经验
- 用户反馈
- 业内对比
还需要知道是不是一直都是好的?
- 监控跟踪
- 告警通知
不好的时候如何再让其变好?
- 治理措施
- 应急方案
背景
裸奔的 RabbitMQ
公司之前使用 RabbitMQ,下面在使用 RabbitMQ 时的痛点,其中很多事故由于 RabbitMQ 集群限流引起的。
- 积压过多是清理还是不清理?这是个问题,我再想想
- 积压过多触发集群流控?那是真的影响业务了
- 想消费前两天的数据?请您重发一遍吧
- 要统计哪些服务接入了?您要多等等了,我得去捞 IP 看看
- 有没有使用风险比如大消息?这个我猜猜
裸奔的服务
曾经有这么一个故障,多个业务共用一个数据库。在一次晚高峰流量陡增,把数据库打挂了。
- 数据库单机升级到最高配依然无法解决
- 重启后缓一缓,不一会就又被打挂了
- 如此循环着、煎熬着、默默等待着高峰过去
思考:无论消息还是服务都需要完善的治理措施
01 打造分布式消息治理平台
设计指南
哪些是我们的关键指标,哪些是我们的次要指标,这是消息治理的首要问题
设计目标
旨在屏蔽底层各个中间件(RocketMQ/Kafka)的复杂性,通过唯一标识动态路由消息。同时打造集资源管控、检索、监控、告警、巡检、容灾、可视化运维等一体化的消息治理平台,保障消息中间件平稳健康运行。
消息治理平台设计需要考虑的点
- 提供简单易用 API
- 有哪些关键点能衡量客户端的使用没有安全隐患
- 有哪些关键指标能衡量集群健康不健康
- 有哪些常用的用户 / 运维操作将其可视化
- 有哪些措施应对这些不健康
尽可能简单易用
设计指南
把复杂的问题搞简单,那是能耐
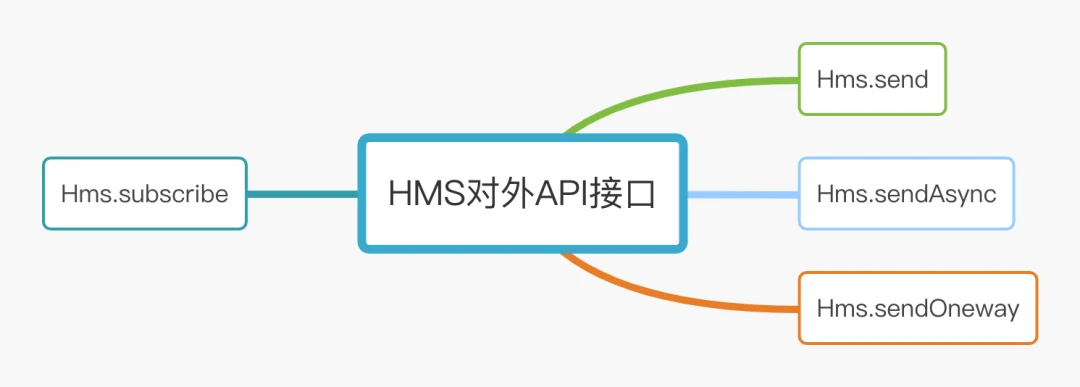
极简统一 API
提供统一的 SDK 封装了(Kafka/RocketMQ)两种消息中间件。
一次申请
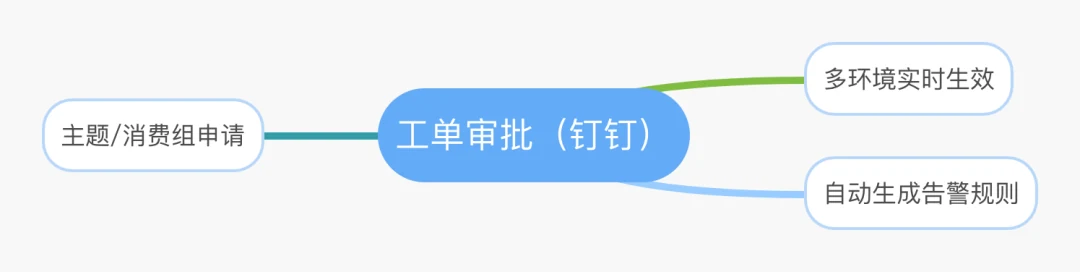
主题消费组自动创建不适合生产环境,自动创建会导致失控,不利于整个生命周期管理和集群稳定。需要对申请流程进行控制,但是应尽可能简单。例如:一次申请各个环境均生效、生成关联告警规则等。
客户端治理
设计指南
监控客户端使用是否规范,找到合适的措施治理
场景回放
场景一 瞬时流量与集群的流控
假设现在集群 Tps 有 1 万,瞬时翻到 2 万甚至更多,这种过度陡增的流量极有可能引发集群流控。针对这类场景需监控客户端的发送速度,在满足速度和陡增幅度阈值后将发送变的平缓一些。
场景二 大消息与集群抖动
当客户端发送大消息时,例如:发送几百 KB 甚至几兆的消息,可能造成 IO 时间过长与集群抖动。针对这类场景治理需监控发送消息的大小,我们采取通过事后巡检的方式识别出大消息的服务,推动使用同学压缩或重构,消息控制在 10KB 以内。
场景三 过低客户端版本
随着功能的迭代 SDK 的版本也会升级,变更除了功能外还有可能引入风险。当使用过低的版本时一个是功能不能得到支持,另外一个是也可能存在安全隐患。为了解 SDK 使用情况,可以采取将 SDK 版本上报,通过巡检的方式推动使用同学升级。
场景四 消费流量摘除和恢复
消费流量摘除和恢复通常有以下使用场景,第一个是发布应用时需要先摘流量,另外一个是问题定位时希望先把流量摘除掉再去排查。为了支持这种场景,需要在客户端监听摘除 / 恢复事件,将消费暂停和恢复。
场景五 发送 / 消费耗时检测
发送 / 消费一条消息用了多久,通过监控耗时情况,巡检摸排出性能过低的应用,针对性推动改造达到提升性能的目的。
场景六 提升排查定位效率
在排查问题时,往往需要检索发了什么消息、存在哪里、什么时候消费的等消息生命周期相关的内容。这部分可以通过 msgId 在消息内部将生命周期串联起来。另外是通过在消息头部埋入 rpcId/traceId 类似链路标识,在一次请求中将消息串起来。
治理措施提炼
需要的监控信息
- 发送 / 消费速度
- 发送 / 消费耗时
- 消息大小
- 节点信息
- 链路标识
- 版本信息