
携程机票业务中台化落地实践
《携程机票业务中台化落地实践》共 0.5 万字,通篇围绕 架构、成本、数据库、监控 展开,归在「企业落地与项目实战」这一层。
适合要把 AI 项目交付出去、对结果负责的人
目录骨架(6 节)
- 一、背景与挑战
- 二、原则与目标
- 三、关键技术实践
- 四、技术架构概览
- 五、成效
- 六、总结
分享内容
- 中台化的背景和面临的挑战
- 中台化设计的原则以及目标
- 中台化架构的关键技术实践
- 整体技术架构概览以及线上运行效果
一、背景与挑战
随着携程国际机票业务的快速发展与全球化战略的深入推进,需要使用的数据种类以及对应的复杂度也随之显著增加。这一增长趋势不仅带来了数据管理的挑战,同样对数据准确性和实时性提出了更高的要求。
接下来,我们从生产者和消费者两个角度具体看下有哪些挑战。
生产者视角下的挑战:对于基础数据的生产者,每一种数据类型都有其独特的业务逻辑,涵盖数据的获取、处理、存储和匹配等环节。数据更新周期长,业务复杂性高,和基础数据相关的应用就达到了几十个,维护成本不断攀升。同时,还存在着数据访问效率低、上云过程复杂、数据回滚困难以及无法应对大规模机器重启或数据刷新等问题。
消费者视角下的挑战:对于基础数据的消费者,每一个应用都或多或少依赖于基础数据。任何一种数据的误差都可能引发广泛的线上问题,而且问题的发现往往滞后,导致生产问题被不断放大。此外,还存在着业务开发接入复杂、测试环境不稳定、服务启动缓慢、垃圾回收频繁、上云过程繁琐以及数据不一致等问题。
二、原则与目标
面对上述问题,构建一套中台化系统是其中一个解决方案,我们希望实现数据资源的高效整合,消除数据孤岛,提高数据处理效率,确保数据质量标准。在系统设计的初期阶段,我们首先从数据生产者和消费者角度出发确立了一系列核心目标:
数据生产者角度:
数据一致性:确保数据在各个环节保持一致性,避免偏差。
数据时效性:保障数据的实时更新,满足业务对数据的即时性需求。
系统健壮性:构建稳定可靠的系统架构,以应对各种运行环境和负载条件。
- 数据可追溯性:实现数据的全流程追踪,便于问题定位和历史分析。
- 数据可回滚性:提供数据版本控制,允许在出现问题时快速回退至稳定状态。
- 监控完善性:建立全面的监控体系,实时监控数据流和系统状态。
降低成本:通过优化资源配置,降低机器和存储的成本;简化系统维护流程,减少人力和时间的投入。
数据消费者角度:
优化消费流程:简化数据消费流程,提高数据处理的便捷性和效率。
- 接入方式简化:提供直观易用的接入方式,降低数据使用的门槛。
- 统一数据模型:建立统一的数据模型,确保数据的一致性和可理解性。
解决环境问题:解决不同运行环境下的数据同步的问题。
- 测试环境完善:提供完善的测试环境,确保数据的准确性和稳定性。
- 云服务便捷性:优化云服务接入,提高数据服务的灵活性和可扩展性。
提升服务性能:通过技术优化,提升服务的响应速度和处理能力。
- 启动耗时降低:减少服务启动时间,提高系统的快速响应能力。
- 减少 GC 次数:优化内存管理,减少因数据更新引起的垃圾回收(GC)操作,提升系统性能。
三、关键技术实践
在基础数据中台化建设的实践过程中,遇到了一系列的问题,我们介绍一些关键的技术实践。
3.1 数据一致性
3.1.1 版本控制
同一集群下不同的机器在更新缓存时由于调度时间不一致,会导致不同机器在同一时间使用的数据不一致,为解决此问题,我们使用数据版本控制策略来解决此问题。每当数据发生变更,我们便认定一个新的数据版本已经诞生。这个新版本可以是包含了变更和未变更数据的完整副本(以下简称为 "全量数据"),也可以是仅包含变更内容的更新(以下简称为 "增量数据")。不论是全量数据还是增量数据,我们都会将数据记录在 BLOB(Binary Large Object)文件中,BLOB 文件将作为数据传输的媒介。
实施数据版本控制后,我们能够收获以下收益:
版本追踪:确保每一次数据更新都有迹可循,并且在新版本出现问题时能够迅速恢复到之前的版本。
数据一致性:保证所有数据消费者能访问到相同版本的数据,从而减少因数据版本不一致而引发的问题。
容错与恢复:能够快速识别出问题数据,并利用多种通知机制,促使产品或开发团队及时介入,解决问题。
性能监控:基于数据版本,构建性能监控体系,以评估数据传输和处理的效率。
数据安全:在数据传输和存储过程中,通过加密和访问控制机制,确保数据安全,防止未授权访问。
3.1.2 去中心化
在业界,如果某个服务想要消费基础数据时,主流解决方案是采用直连数据库或调用应用程序接口的方式,如下图 1 和图 2,这两者均属于 C/S 架构。C/S 架构虽被广泛采用,却面临着如数据库承载压力大、数据一致性难以保障、系统扩展性不足、开发与集成过程复杂、硬件成本高昂、缓存穿透、中心服务的读压力,以及难以应对流量高峰等问题。
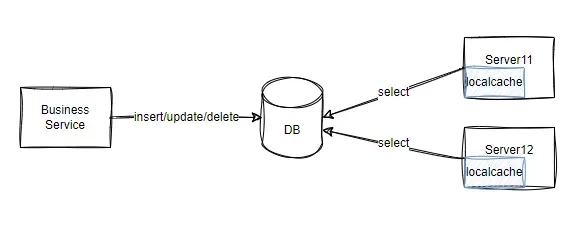
图 1
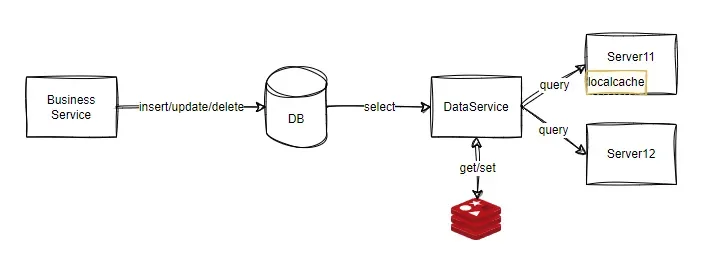
图 2
为了克服以上问题,我们引入了 P2P 架构(Peer-to-Peer Architecture)。与 C/S 架构相比,P2P 架构实现了去中心化。在 P2P 网络中,每个节点都具备客户端和服务器的双重身份,能够直接与其他节点进行通信和数据交换,无需依赖中央服务器。同时,P2P 架构下的数据查询耗时并不会因为客户端数量的增加而线性增长。图 3 直观地展示了 C/S 架构与 P2P 架构的本质区别。