
DeepSeek开源Day3:DeepGEMM技术详解
《DeepSeek开源Day3:DeepGEMM技术详解》共 0.3 万字,通篇围绕 CUDA、GPU、架构、MoE 展开,归在「模型架构与原理」这一层。
适合要跟模型团队对话、得听懂他们在说什么的人
目录骨架(8 节)
- 1 DeepGEMM 简介
- 2 GEMM 与 TensorCore
- **3 DeepEP 的关键技术与未来优化**
- 4 DeepGEMM 架构分析
- 5 DeepGEMM 代码结构
- 6 DeepGEMM 的不足与未来
- 2.1 GEMM
- 2.2 Tensor Core
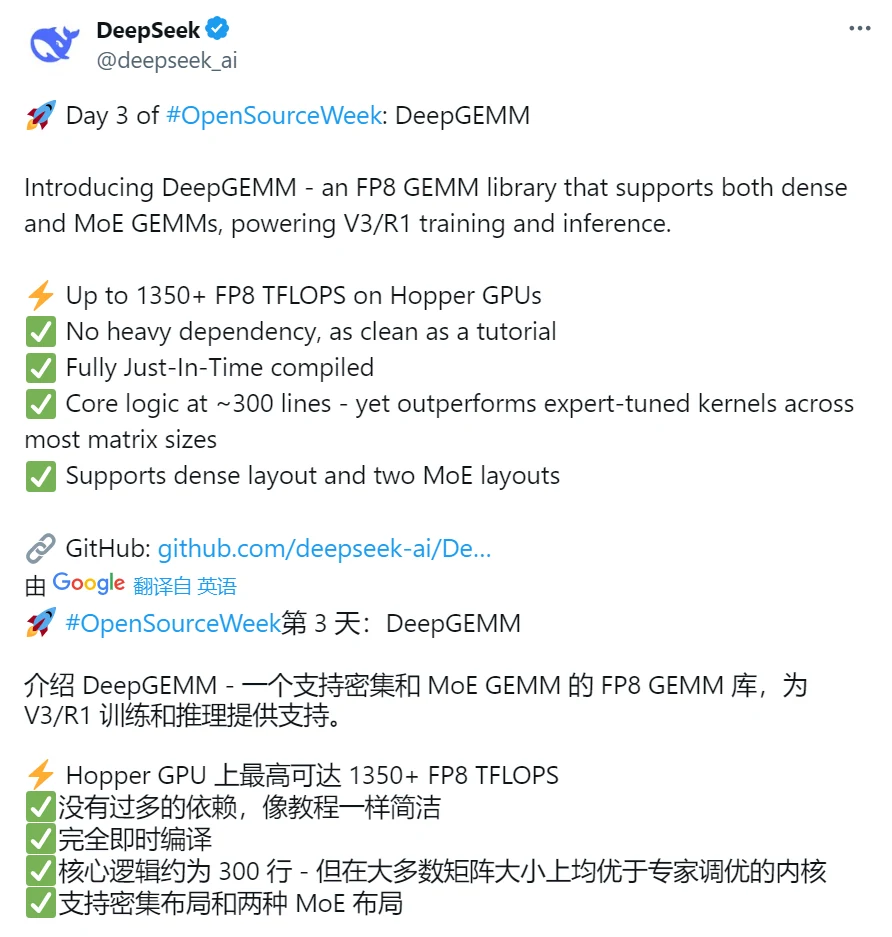
2 月 24 日,DeepSeek 启动 “开源周”,第三个开源的代码库为 DeepGEMM,并向 CUTLASS 团队致敬。DeepGEMM 使用了大量与 Hopper 架构绑定的技术。毫无疑问,H100/H800 绝对是 DeepSeek 的小心肝。另外,从 Day1 到 Day3 的几个创新,都不是一般算法设计能完成的工作,必须要同时对 LLM、CUDA、PTX、GPU 架构有深入了解才能迅速跟进这类技术。
1 DeepGEMM 简介
DeepGEMM 是一个支持 FP8 精度的高性能 GEMM(通用矩阵乘法)库,适用于矩阵和 MoE(Mixture of Experts,专家混合模型)计算。DeepGEMM 具有细粒度缩放功能,采用 CUDA 编写,使用轻量级即时 (JIT) 模块在运行时编译所有内核,PTX 和 SASS 优化轮番上。
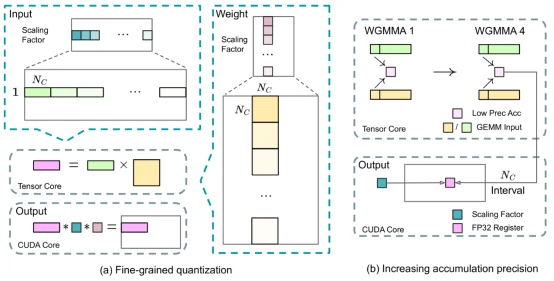
细粒度量化与提高累加精度(来源:DeepSeek)
DeepGEMM 反映了 “OpenSeek” 推动 AGI 探索的承诺。X 的 帖子强调其 “无过多依赖”“像教程一样简洁”,这与 DeepSeek 的“社区驱动创新” 理念一致。通过开放 GEMM 底层工具,DeepSeek 不仅展示技术实力,还为 CUTLASS 研究者和开发者提供了高性能计算的参考实现。
DeepGEMM 在某些矩阵尺寸下比 CUTLASS 快 2.7 倍,尤其在 MoE 模型的分组 GEMM 上表现优异。这是非常显著的优势。
项目地址为:
与前几个开源类似,DeepGEMM 同样需要 Hopper 架构 GPU,CUDA 12.3 或更高版本。
2 GEMM 与 TensorCore
2.1 GEMM
GEMM(General Matrix Multiplications)即通用矩阵乘法,是将两个矩阵的进行相乘的计算。这种方法称为一般矩阵乘法 (GEMM)。科学计算库(如 Numpy、BLAS 等)和大模型都使用了 GEMM。此实现仅适用于方阵。这样做是为了避免使算法过于复杂而无法处理矩形矩阵。
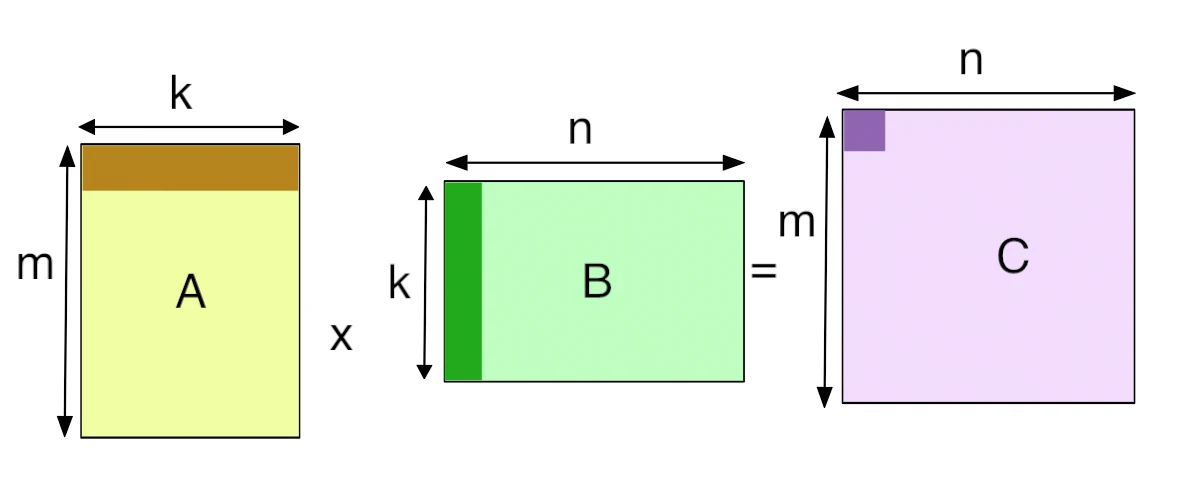
标准 GEMM 示例(来源:互联网)
在 GPU 中,GEMM 定义为运算 C=αAB+βC
其中 A 和 B 作为矩阵输入,α 和 β 作为标量输入,C 作为预先存在的矩阵,被输出覆盖。普通矩阵乘积 AB 是 α 等于 1 且 β 等于 0 的 GEMM。例如,在全连接层的正向传递中,权重矩阵为参数 A,传入激活为参数 B,α 和 β 通常分别为 1 和 0。在某些情况下,β 可以是 1。
GPU 通过将输出矩阵划分为图块来实现 GEMM,然后将其分配给线程块。图块大小(Tile Size)通常是指这些图块的尺寸。每个线程块通过单步执行图块中的 K 维度,从 A 和 B 矩阵加载所需的值,然后将它们相乘并累加到输出中来计算其输出图块。
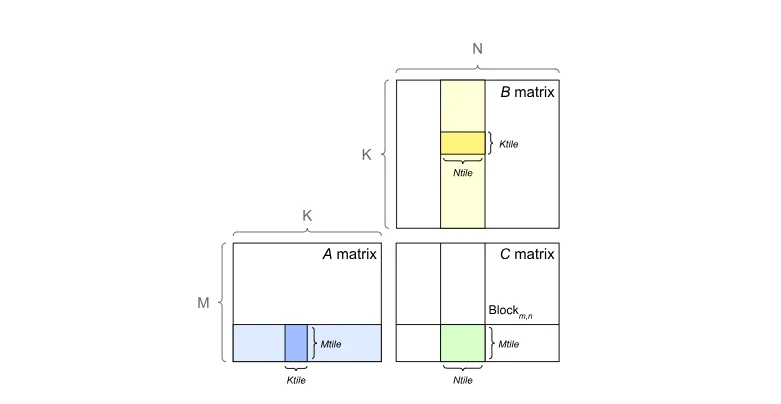
GPU 中 GEMM 的一般计算方法(来源:互联网)
2.2 Tensor Core
英伟达 GPU 引入了 Tensor Core(张量核心) 来最大限度地提高 GEMM 的速度。使用 Tensor Core 的要求取决于 英伟达库的版本。