
AI大模型直播课
《AI大模型直播课》共 0.3 万字,通篇围绕 知识库、RAG、向量、检索 展开,归在「企业落地与项目实战」这一层。
适合要把 AI 项目交付出去、对结果负责的人
目录骨架(8 节)
- 引言 Manus智能体刷屏
- 什么是RAG?为什么需要?原理是?
- RAG和模型微调的区别?微调流程是?
- RAG和模型微调的区别
- 什么是Embedding?为什么需要?
- 如何快速搭建本地知识库?实操!
- AI大模型学习规划,落地项目,简历优化
- AI大模型就业形式,和大厂案例
AI元年逆袭之路, RAGflow构建本地知识库
引言 Manus智能体刷屏
AI元年,万物即可A
随着人工智能技术的飞速发展,我们正处在一个被称为“AI元年”的时代。在这个时期,AI技术不仅在理论上取得了突破,更在实际应用中展现出了巨大的潜力和价值。本文将探讨AI赛道的多个方面,包括AI智能体、模型私有定制化、搜广推等,并深入解析RAG技术、Embedding模型以及如何快速搭建本地知识库等关键技术。
简单来说 AI的大模型正在迅速改变我们的生活方式,万物皆可加入AI,市场缺口巨大。
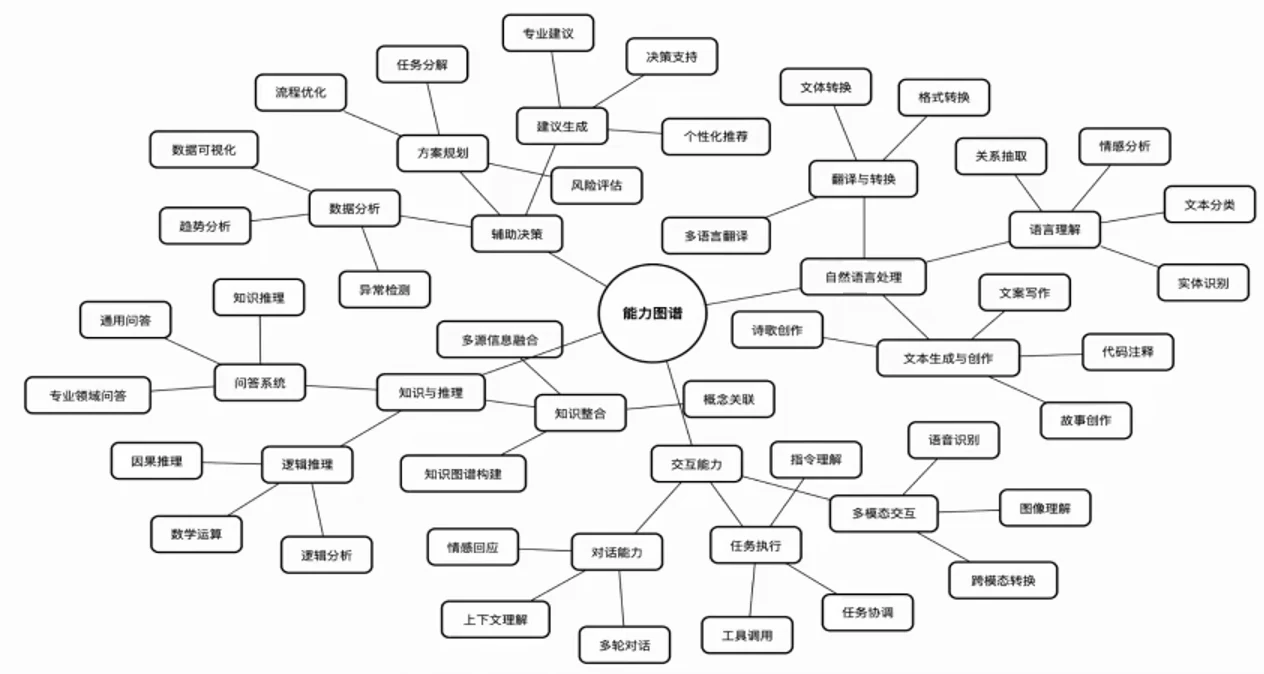
四大核心能力:
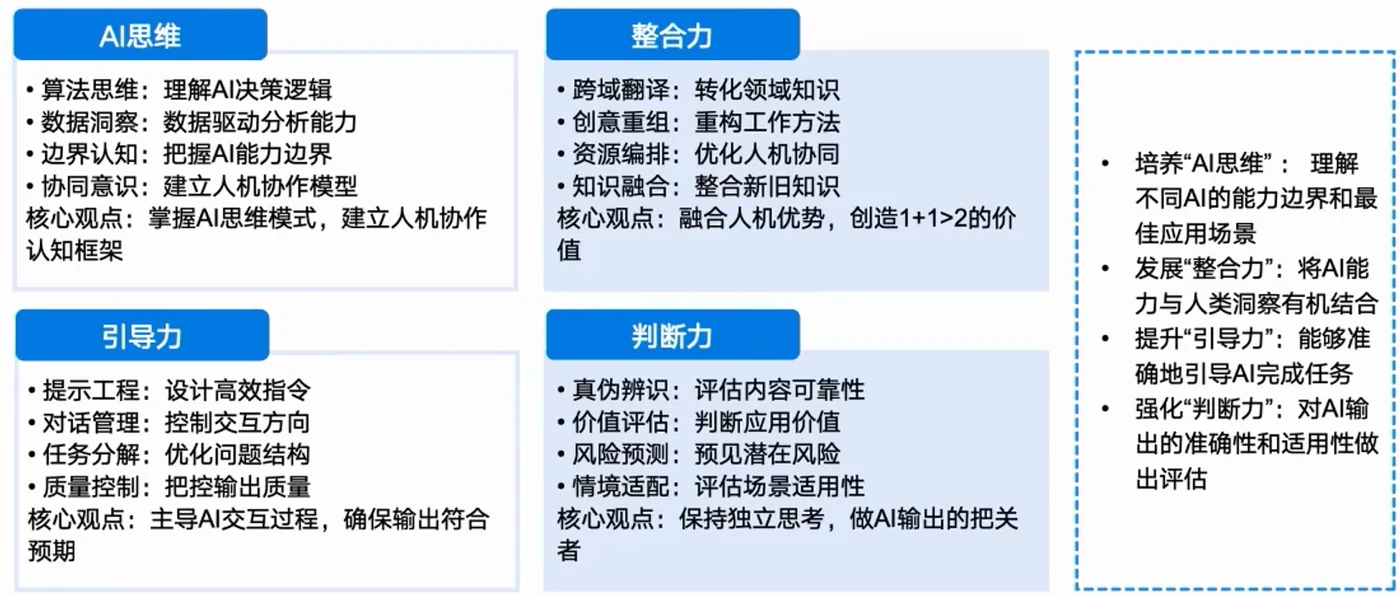
为什么不直接使用网页版ds?
网页版的大模型不说响应速度,和精准度。主要基于现有的外部数据集进行训练,但缺乏完整的知识库。这种结构化不足会导致模型在实际场景中的表现下降。而且特定领域由于数据安全性,不能选择外部模型。
如何实现网页版ds不能实现的需求?
本地化部署,通过RAG(Retrieval-Augmented Generation)结合文本检索和生成任务,弥补了这一短板。它能够根据上下文信息查找相关的知识,并将其整合到模型的回答中,显著提升了模型的泛化能力。
Ollama Down 然后小黑窗口run ,可配合chatbox客户端使用,也可配置硅基流动满血版
AI赛道,如何把握机会?
AI 智能体
AI智能体是指能够自主执行任务、做出决策并从环境中学习的系统。它们可以应用于客户服务、游戏、自动化控制等多个领域。
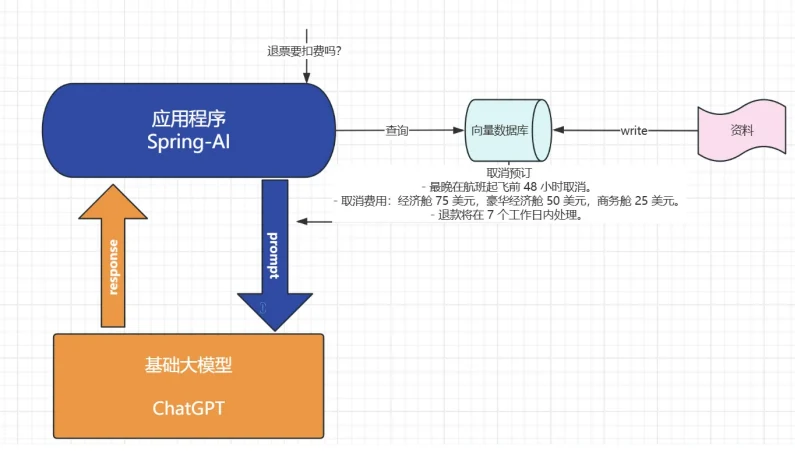
模型私有定制化
模型私有定制化是指根据特定需求和数据集对预训练模型进行调整,以适应特定的业务场景。
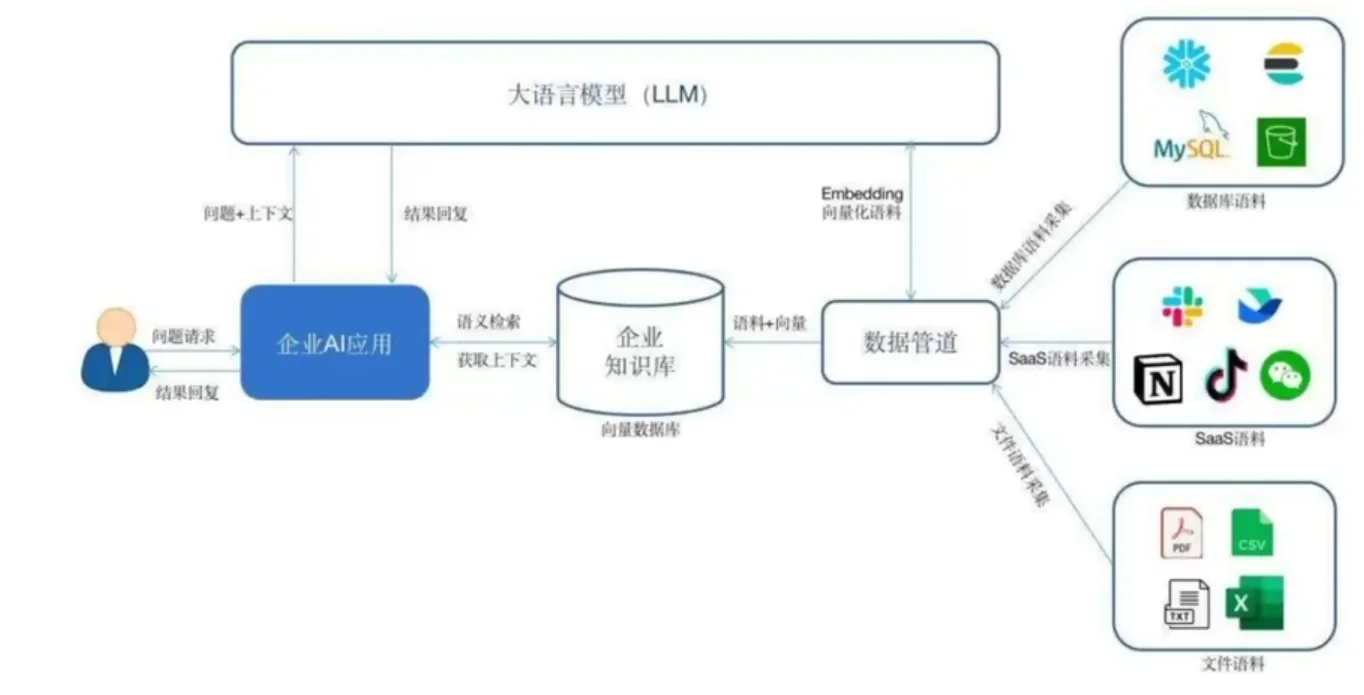
搜广推
即搜索、广告和推荐系统,利用AI技术提高内容的个性化和相关性,提升用户体验和商业价值。
什么是RAG?为什么需要?原理是?
RAG原理
RAG(Retrieval-Augmented Generation)是一种结合了检索(Retrieval)和生成(Generation)的模型架构。它首先从大规模数据集中检索相关信息,然后将这些信息作为上下文输入到生成模型中,以生成更加准确和相关的输出。
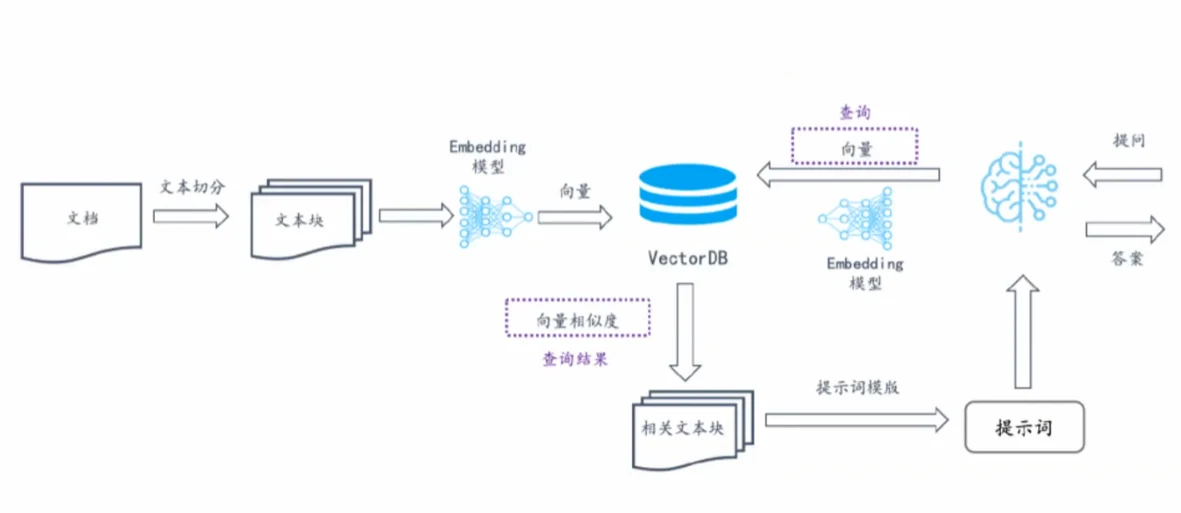
RAG技术的原理是通过检索增强生成模型的能力,使其能够利用外部知识库来生成更加丰富和准确的内容。
技术细节:检索,增强,生成
检索策略:
- 词袋模型:将单词和短语作为实体,存储为向量形式。
- 嵌入表(Embedding):将单词映射到低维空间,便于检索。例如,在Word2Vec模型中,每个单词被映射到一个向量。
生成过程:
- 在生成文本时,结合检索结果获取相关信息,并将其融入生成的文本中。
- 通过监督学习(Supervised Learning),在生成过程和外部知识库之间建立关联。例如,在问答系统中,生成器的目标是尽可能接近用户提供的查询。
增强机制:
- 在生成过程中,使用检索结果来调整生成参数或直接提取相关信息。这可以通过损失函数(Loss Function)来实现,使生成文本与目标数据集更相似。
RAG和模型微调的区别?微调流程是?
RAG和模型微调的区别
| 特性 | RAG(Retrieval-Augmented Generation) | 微调(Fine-tuning) |
|---|---|---|
| 原理 | 通过检索外部知识库中的信息,并将其作为上下文输入到生成模型中,增强生成文本的准确性和相关性。 | 对预训练模型的参数进行针对性调整,使其适应特定任务或领域。 |
| 数据需求 | 数据需求较少,主要依赖外部知识库。 | 需要大量标注数据进行训练。 |
| 更新成本 | 知识更新成本低,只需更新知识库。 | 更新困难,需要重新微调模型。 |
| 推理速度 | 推理速度较慢,需要检索和生成两个步骤。 | 推理速度快,只需一次模型调用。 |
| 灵活与适应性 | 适应性强,适合动态环境和多样化任务。 | 适应性较差,主要适用于特定任务和稳定环境。 |
| 优点 | 动态知识更新、较少的数据需求、灵活性强、可定制化。 | 定制化能力强、一体化、高效推理。 |
| 缺点 | 推理速度慢、复杂性增加、依赖外部知识库。 | 数据需求高、更新困难、存储和计算成本高。 |
| 适用场景 | 外部知识频繁更新、标注数据不足、任务复杂多样。 | 任务和数据相对稳定、有充足标注数据、对推理速度要求高。 |