
互联网大厂分布式ID解决方案
《互联网大厂分布式ID解决方案》共 0.6 万字,通篇围绕 数据库、安全、Redis、并发 展开,归在「推理、部署与算力」这一层。
适合要把模型跑起来,还得跑得起的人
目录骨架(6 节)
- 分布式ID介绍
- 分布式 ID 常见解决方案
- 什么是 ID?
- 什么是分布式 ID?
- 分布式 ID 需要满足哪些要求?
- 开源框架
本次分享内容
- 分布式ID介绍
- 分布式ID常见解决方案(数据库、算法、开源框架)
- 总结
分布式ID介绍
什么是 ID?
日常开发中,我们需要对系统中的各种数据使用 ID 唯一表示,比如用户 ID 对应且仅对应一个人,商品 ID 对应且仅对应一件商品,订单 ID 对3应且仅对应一个订单。
我们现实生活中也有各种 ID,比如身份证 ID 对应且仅对应一个人、地址 ID 对应且仅对应一个地址。
简单来说,ID 就是数据的唯一标识。
什么是分布式 ID?
分布式 ID 是分布式系统下的 ID。分布式 ID 不存在与现实生活中,属于计算机系统中的一个概念。
我简单举一个分库分表的例子。
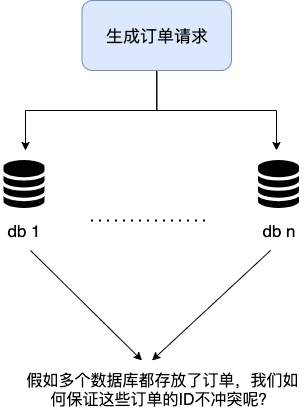
比如有一个项目,使用的是单机 MySQL 。但是,没想到的是,项目上线一个月之后,随着使用人数越来越多,整个系统的数据量将越来越大。单机 MySQL 已经没办法支撑了,需要进行分库分表(推荐 Sharding-JDBC)。
在分库之后, 数据遍布在不同服务器上的数据库,数据库的自增主键已经没办法满足生成的主键唯一了。我们如何为不同的数据节点生成全局唯一主键呢?
这个时候就需要生成分布式 ID了。
分布式 ID 需要满足哪些要求?
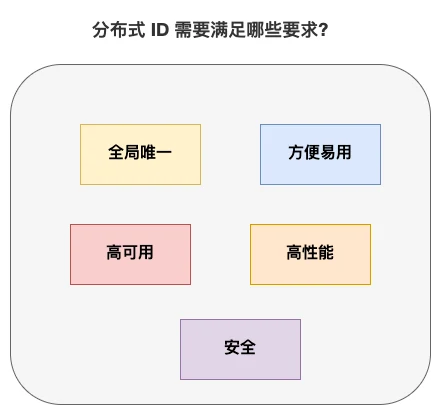
分布式 ID 作为分布式系统中必不可少的一环,很多地方都要用到分布式 ID。
一个最基本的分布式 ID 需要满足下面这些要求:
- 全局唯一:ID 的全局唯一性肯定是首先要满足的!
- 高性能:分布式 ID 的生成速度要快,对本地资源消耗要小。
- 高可用:生成分布式 ID 的服务要保证可用性无限接近于 100%。
- 方便易用:拿来即用,使用方便,快速接入!
除了这些之外,一个比较好的分布式 ID 还应保证:
- 安全:ID 中不包含敏感信息。
- 有序递增:如果要把 ID 存放在数据库的话,ID 的有序性可以提升数据库写入速度。并且,很多时候 ,我们还很有可能会直接通过 ID 来进行排序。
- 有具体的业务含义:生成的 ID 如果能有具体的业务含义,可以让定位问题以及开发更透明化(通过 ID 就能确定是哪个业务)。
- 独立部署:也就是分布式系统单独有一个发号器服务,专门用来生成分布式 ID。这样就生成 ID 的服务可以和业务相关的服务解耦。不过,这样同样带来了网络调用消耗增加的问题。总的来说,如果需要用到分布式 ID 的场景比较多的话,独立部署的发号器服务还是很有必要的。
分布式 ID 常见解决方案
数据库
数据库主键自增
这种方式就比较简单直白了,就是通过关系型数据库的自增主键产生来唯一的 ID。
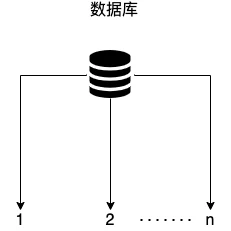
以 MySQL 举例,我们通过下面的方式即可。
1.创建一个数据库表。
CREATE TABLE `sequence_id` (
  `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT,
  `stub` char(10) NOT NULL DEFAULT '',
  PRIMARY KEY (`id`),
  UNIQUE KEY `stub` (`stub`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
stub 字段无意义,只是为了占位,便于我们插入或者修改数据。并且,给 stub 字段创建了唯一索引,保证其唯一性。
2.通过replace into来插入数据。
BEGIN;
REPLACE INTO sequence_id (stub) VALUES ('stub');
SELECT LAST_INSERT_ID();
COMMIT;
插入数据这里,我们没有使用 insert into 而是使用 replace into 来插入数据,具体步骤是这样的:
- 第一步:尝试把数据插入到表中。
- 第二步:如果主键或唯一索引字段出现重复数据错误而插入失败时,先从表中删除含有重复关键字值的冲突行,然后再次尝试把数据插入到表中。
这种方式的优缺点也比较明显:
- 优点:实现起来比较简单、ID 有序递增、存储消耗空间小
- 缺点:支持的并发量不大、存在数据库单点问题(可以使用数据库集群解决,不过增加了复杂度)、ID 没有具体业务含义、安全问题(比如根据订单 ID 的递增规律就能推算出每天的订单量,商业机密啊! )、每次获取 ID 都要访问一次数据库(增加了对数据库的压力,获取速度也慢)
数据库号段模式
数据库主键自增这种模式,每次获取 ID 都要访问一次数据库,ID 需求比较大的时候,肯定是不行的。
如果我们可以批量获取,然后存在在内存里面,需要用到的时候,直接从内存里面拿就舒服了!这也就是我们说的 基于数据库的号段模式来生成分布式 ID。
数据库的号段模式也是目前比较主流的一种分布式 ID 生成方式。像滴滴开源的Tinyid 就是基于这种方式来做的。不过,TinyId 使用了双号段缓存、增加多 db 支持等方式来进一步优化。