RAG 与知识库面试题图文讲义5637 字

大模型RAG相关面试题

·全库 164 / 611

《大模型RAG相关面试题》共 10 页、0.6 万字,通篇围绕 检索、RAG、向量、微调 展开,归在「RAG 与知识库」这一层。

覆盖检索RAG向量微调SFTembedding

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(8 节)
  1. 三,使用 RAG 的好处?
  2. 5.1 如何构建数据索引?
  3. Proprietary
  4. 6.2 Baichuan
  5. 七、RAG 存在什么问题?
  6. 一、LLMs 已经具备了较强能力了,存在哪些不足点?
  7. 二、什么是 RAG?
  8. 五、介绍一下 RAG 典型实现方法?

原 PDF 已逐页还原成图,共 10 页,这里先放前 3 页。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01RAG (Retrieval-Aug…
  2. 02RAG (Retrieval Aug…
  3. 03此外,多查询检索方法让大语言模型能够…
011 / 3
第 1 页
第 1 页

RAG (Retrieval-Aug…

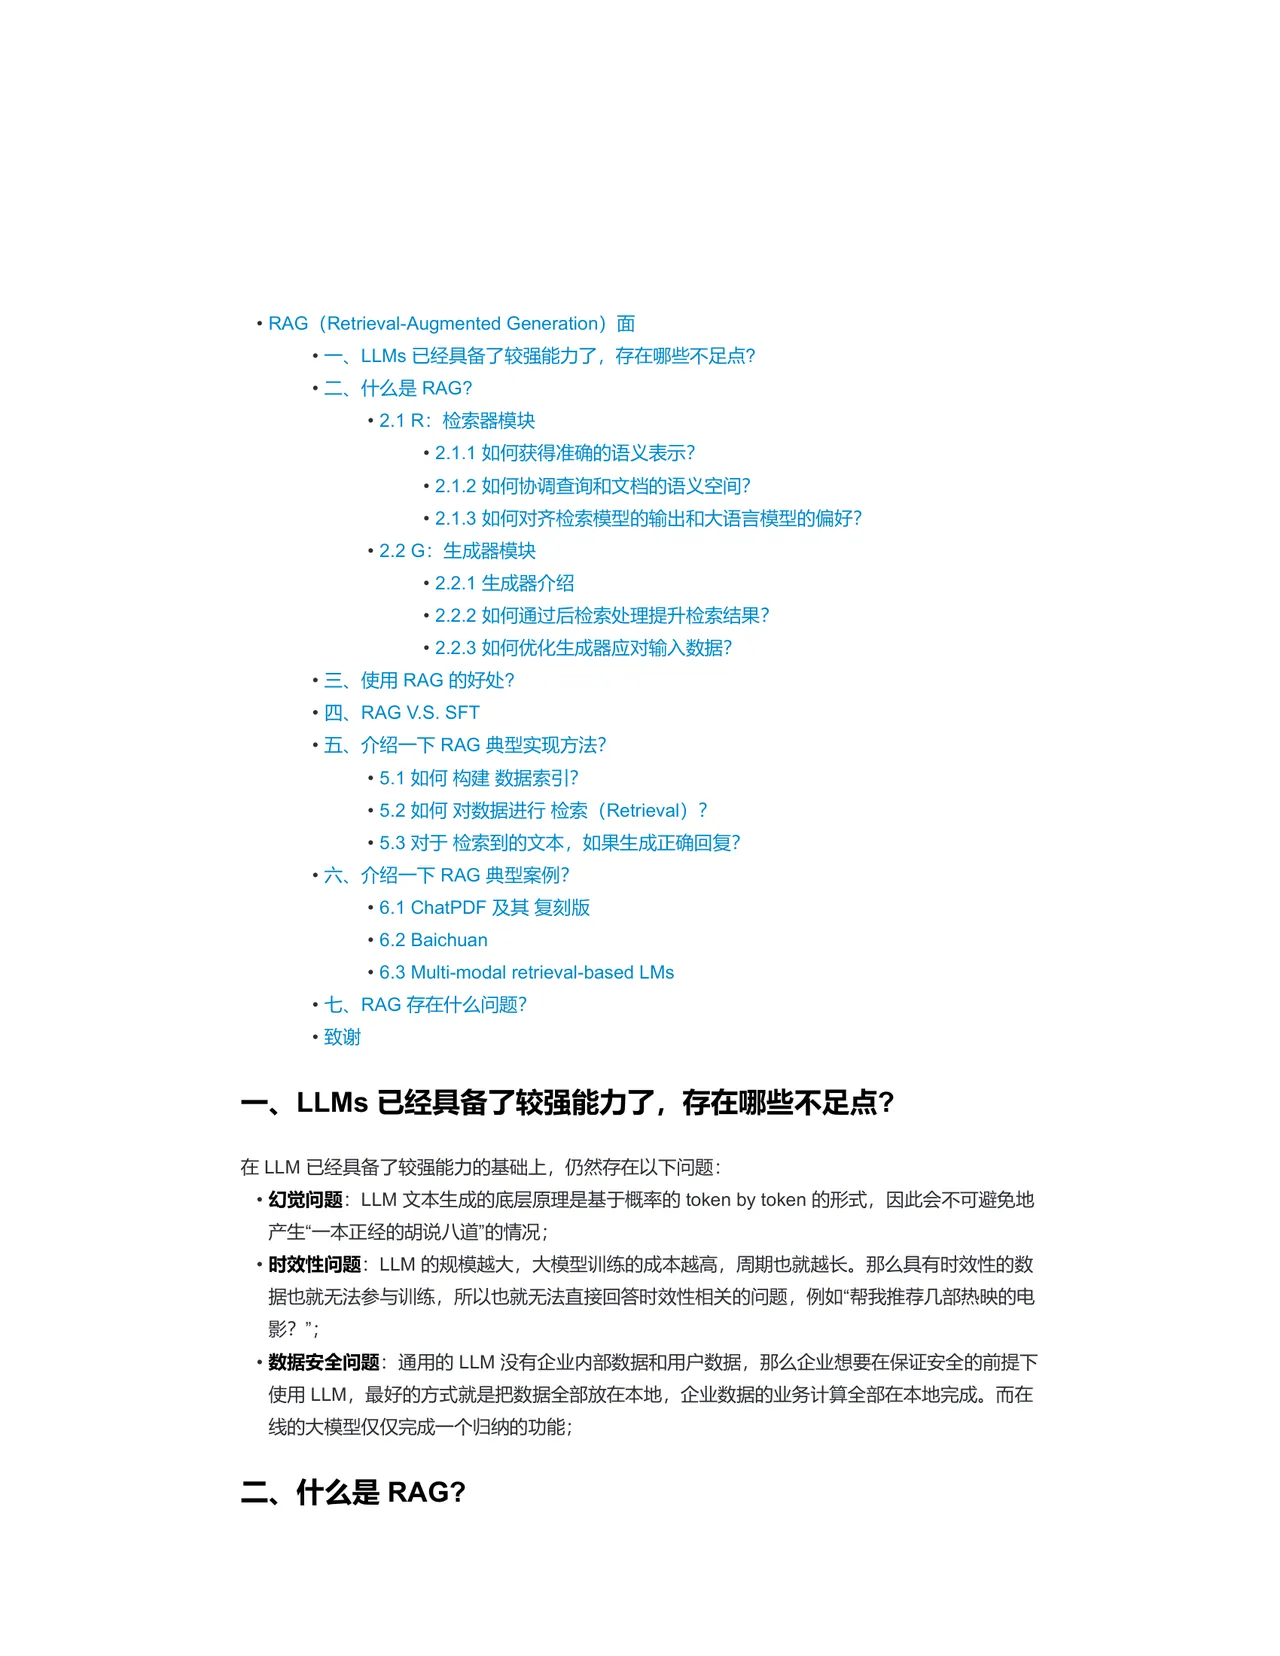
  • RAG (Retrieval-Augmented Generation)面
  • 一、LLMs 已经具备了较强能力了,存在哪些不足点?
  • 二、什么是 RAG?
  • 2.1 R:检索器模块
  • 2.1.1 如何获得准确的语义表示?
  • 2.1.2 如何协调查询和文档的语义空间?
  • 2.1.3 如何对齐检索模型的输出和大语言模型的偏好?
  • 2.2G:生成器模块
  • 2.2.1 生成器介绍
  • 2.2.2 如何通过后检索处理提升检索结果?
  • 2.2.3 如何优化生成器应对输入数据?
  • 三、使用 RAG 的好处?
  • 四、RAG V.S. SFT
  • 五、介绍一下 RAG 典型实现方法?
  • 5.1 如何构建数据索引?
  • 5.2 如何对数据进行检索(Retrieval)?
  • 5.3 对于检索到的文本,如果生成正确回复?
  • 六、介绍一下 RAG 典型案例?
  • 6.1 ChatPDF 及其复刻版
  • 6.2 Baichuan
  • 6.3 Multi-modal retrieval-based LMs

•七、RAG 存在什么问题?

一、LLMs 已经具备了较强能力了,存在哪些不足点?

  • 在 LLM 已经具备了较强能力的基础上,仍然存在以下问题:
  • 幻觉问题:LLM 文本生成的底层原理是基于概率的 token by token 的形式,因此会不可避免地 产生“一本正经的胡说八道”的情况;
  • 时效性问题:LLM 的规模越大,大模型训练的成本越高,周期也就越长。那么具有时效性的数 据也就无法参与训练,所以也就无法直接回答时效性相关的问题,例如“帮我推荐几部热映的电

•数据安全问题:通用的 LLM 没有企业内部数据和用户数据,那么企业想要在保证安全的前提下 使用 LLM,最好的方式就是把数据全部放在本地,企业数据的业务计算全部在本地完成。而在 线的大模型仅仅完成一个归纳的功能:

二、什么是 RAG?

022 / 3
第 2 页
第 2 页

RAG (Retrieval Aug…

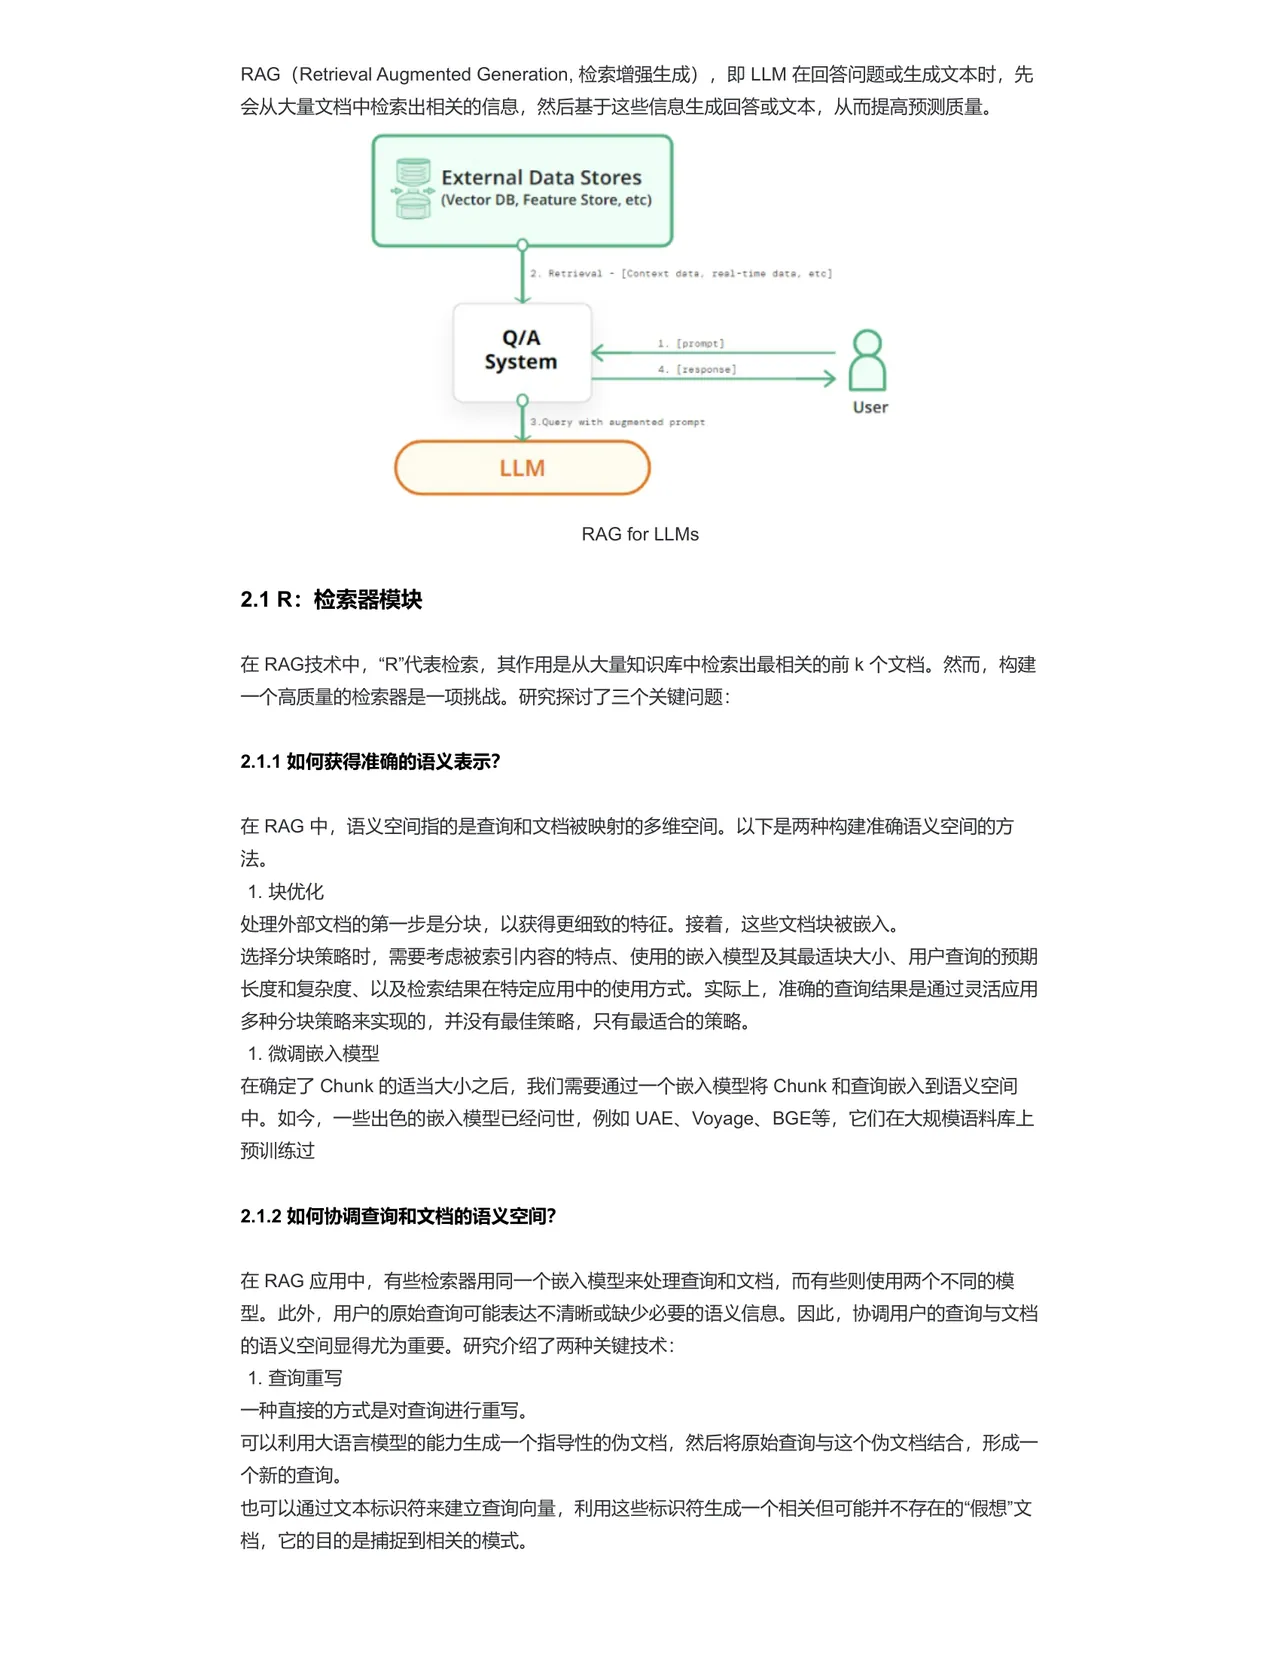
RAG (Retrieval Augmented Generation,检索增强生成),即 LLM 在回答问题或生成文本时,先 会从大量文档中检索出相关的信息,然后基于这些信息生成回答或文本,从而提高预测质量。

2.1 R:检索器模块 在 RAG 技术中,“R”代表检索,其作用是从大量知识库中检索出最相关的前 k 个文档。然而,构建 一个高质量的检索器是一项挑战。研究探讨了三个关键问题:

2.1.1 如何获得准确的语义表示?

在 RAG 中,语义空间指的是查询和文档被映射的多维空间。以下是两种构建准确语义空间的方 法。 1.块优化 处理外部文档的第一步是分块,以获得更细致的特征。接着,这些文档块被嵌入。 选择分块策略时,需要考虑被索引内容的特点、使用的嵌入模型及其最适块大小、用户查询的预期 长度和复杂度、以及检索结果在特定应用中的使用方式。实际上,准确的查询结果是通过灵活应用 多种分块策略来实现的,并没有最佳策略,只有最适合的策略。 1.微调嵌入模型 在确定了 Chunk 的适当大小之后,我们需要通过一个嵌入模型将 Chunk 和查询嵌入到语义空间 中。如今,一些出色的嵌入模型已经问世,例如 UAE、Voyage、BGE 等,它们在大规模语料库上 预训练过

2.1.2 如何协调查询和文档的语义空间?

在 RAG 应用中,有些检索器用同一个嵌入模型来处理查询和文档,而有些则使用两个不同的模 型。此外,用户的原始查询可能表达不清晰或缺少必要的语义信息。因此,协调用户的查询与文档 的语义空间显得尤为重要。研究介绍了两种关键技术: 1. 查询重写 一种直接的方式是对查询进行重写。 可以利用大语言模型的能力生成一个指导性的伪文档,然后将原始查询与这个伪文档结合,形成一 个新的查询。 也可以通过文本标识符来建立查询向量,利用这些标识符生成一个相关但可能并不存在的“假想”文 档,它的目的是捕捉到相关的模式。

External Data Stores (Vector DB, Feature Store, etc)

Q/A

RAG for LLMs

User

033 / 3
第 3 页
第 3 页

此外,多查询检索方法让大语言模型能够…

此外,多查询检索方法让大语言模型能够同时产生多个搜索查询。这些查询可以同时运行,它们的 结果一起被处理,特别适用于那些需要多个小问题共同解决的复杂问题。 在 Liu 于 2023 年提出的 Llamalndex 中,研究者们通过在查询编码器后加入一个特殊的适配器, 并对其进行微调,从而优化查询的嵌入表示,使之更适合特定的任务。 Li 团队在 2023 年提出的 SANTA 万法,就是为了让检索系统能够理解并处理结构化的信息。他们 提出了两种预训练方法:一是利用结构化与非结构化数据之间的自然对应关系进行对比学习;二是 采用了一种围绕实体设计的掩码策略,让语言模型来预测和填补这些被掩盖的实体信息。 2.1.3 如何对齐检索模型的输出和大语言模型的偏好?

在 RAG 流水线中,即使采用了上述技术来提高检索模型的命中率,仍可能无法改善 RAG 的最终 效果,因为检索到的文档可能不符合大语言模型的需求。 因此,研究介绍了如下方法: 大语言模型的监督训练:REPLUG 使用检索模型和大语言模型计算检索到的文档的概率分布,然后 通过计算 KL 散度进行监督训练。 这种简单而有效的训练方法利用大语言模型作为监督信号,提高了检索模型的性能,消除了特定的 交叉注意力机制的需求。 此外,也有一些方法选择在检索模型上外部附加适配器来实现对齐,这是因为微调嵌入模型可能面 临一些挑战,比如使用 API 实现嵌入功能或计算资源不足等。因此,一些方法选择在检索模型上 外部附加适配器来实现对齐。 除此之外,PKG 通过指令微调将知识注入到白盒模型中,并直接替换检索模块,用于根据查询直接 输出相关文档。 2.2 G:生成器模块 2.2.1 生成器介绍

  • 介绍:在 RAG 系统中,生成组件是核心部分之一
  • 作用:将检索到的信息转化为自然流畅的文本。在 RAG 中,生成组件的输入不仅包括传统的 上下文信息,还有通过检索器得到的相关文本片段。这使得生成组件能够更深入地理解问题背 后的上下文,并产生更加信息丰富的回答。此外,生成组件还会根据检索到的文本来指导内容 的生成,确保生成的内容与检索到的信息保持一致。 正是因为输入数据的多样性,我们针对生成阶段进行了一系列的有针对性工作,以便更好地适应来 自查询和文档的输入数据。

2.2.2 如何通过后检索处理提升检索结果?

  • 介绍:后检索处理指的是,在通过检索器从大型文档数据库中检索到相关信息后,对这些信息 进行进一步的处理、过滤或优化。
  • 主要目的:提高检索结果的质量,更好地满足用户需求或为后续任务做准备。
  • 后检索处理策略:包括信息压缩和结果的重新排序。

2.2.3 如何优化生成器应对输入数据?

  • 生成器工作:负责将检索到的信息转化为相关文本,形成模型的最终输出。
  • 其优化目的:在于确保生成文本既流畅又能有效利用检索文档,更好地回应用户的查询。

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求