RAG 与知识库面试题图文讲义3090 字

RAG Fusion优化策略面试题

·全库 165 / 611

《RAG Fusion优化策略面试题》共 6 页、0.3 万字,通篇围绕 RAG、向量、上下文、检索 展开,归在「RAG 与知识库」这一层。

覆盖RAG向量上下文检索幻觉工作流

适合手上有一堆资料,要把它变成能问答的知识库的人

目录骨架(5 节)
  1. 四、说一下 RAG-Fusion 核心技术?
  2. 一、RAG 有哪些优点?
  3. 二、RAG 存在哪些局限性?
  4. 三、为什么需要 RAG-Fusion?
  5. 五、说一下 RAG-Fusion 工作流程?

原 PDF 已逐页还原成图,共 6 页,这里先放前 3 页,其中 1 页识别出了标题。右侧文字由 OCR 按版面重排,可能有个别错字,以图为准;点图可全屏放大。

本讲义目录 · 3 页
  1. 01一、RAG 有哪些优点?
  2. 02四、说一下 RAG-Fusion 核心技术?
  3. 03利用提示工程和自然语言模型拓宽搜索视…
011 / 3
第 1 页
第 1 页

一、RAG 有哪些优点?

  • 一、RAG 有哪些优点?
  • 二、RAG 存在哪些局限性?
  • 三、为什么需要 RAG-Fusion?
  • 四、说一下 RAG-Fusion 核心技术?
  • 五、说一下 RAG-Fusion 工作流程?
  • 5.1 多查询生成
  • 5.2 多查询生成技术实现(提示工程)?
  • 5.3 多查询生成工作原理?
  • 5.4 逆向排名融合(RRF)
  • 5.4.1 为什么选择 RRF?
  • 5.4.2 RRF 技术实现?
  • 5.4.3 生成性输出用户意图保留
  • 5.4.4 生成性输出用户意图保留技术实现
  • 六、RAG-Fusion 的优势和不足
  • 6.1 RAG-Fusion 优势
  • 6.2 RAG-Fusion 挑战

一、RAG 有哪些优点?

1.向量搜索融合:RAG 通过将向量搜索功能与生成模型相结合,引入了一种新颖的范式。这种融 合使大型语言模型(LLM)能够生成更丰富、更具上下文意识的输出。 2.减少幻觉现象:RAG 显著降低了 LLM 产生幻觉的倾向,使生成的文本更加基于数据。 3. 个人和专业效用:从个人应用(如浏览笔记)到更专业的集成,RAG 在提高生产力和内容质量 方面展示了其多功能性,同时基于可信的数据来源。

二、RAG 存在哪些局限性?

  1. 当前搜索技术的限制:RAG 受到限制的方面与我们的检索式基于词汇和向量的搜索技术相同。 2. 人类搜索效率低下:人类在向搜索系统输入他们想要的内容时并不擅长,如打字错误、含糊的 查询或词汇有限,这常常导致错过那些超出显而易见的顶部搜索结果的大量信息。虽然 RAG 有 所帮助,但它并没有完全解决这个问题。 3.搜索的过度简化:我们普遍的搜索范式是将查询线性映射到答案,缺乏理解人类查询的多维 性。这种线性模型通常无法捕捉更复杂用户查询的细微差别和上下文,导致结果相关性较低。

三、为什么需要 RAG-Fusion?

022 / 3
第 2 页:四、说一下 RAG-Fusion 核心技术?
第 2 页

四、说一下 RAG-Fusion 核心技术?

它解决了 RAG 固有的限制,通过生成多个用户查询并重新排序结果。利用逆向排名融合和自定义 向量评分加权进行综合、准确的搜索。 RAG-Fusion 旨在弥合用户明确询问与他们意图询问之间的差距,更接近于发现通常隐藏的变革性 知识。

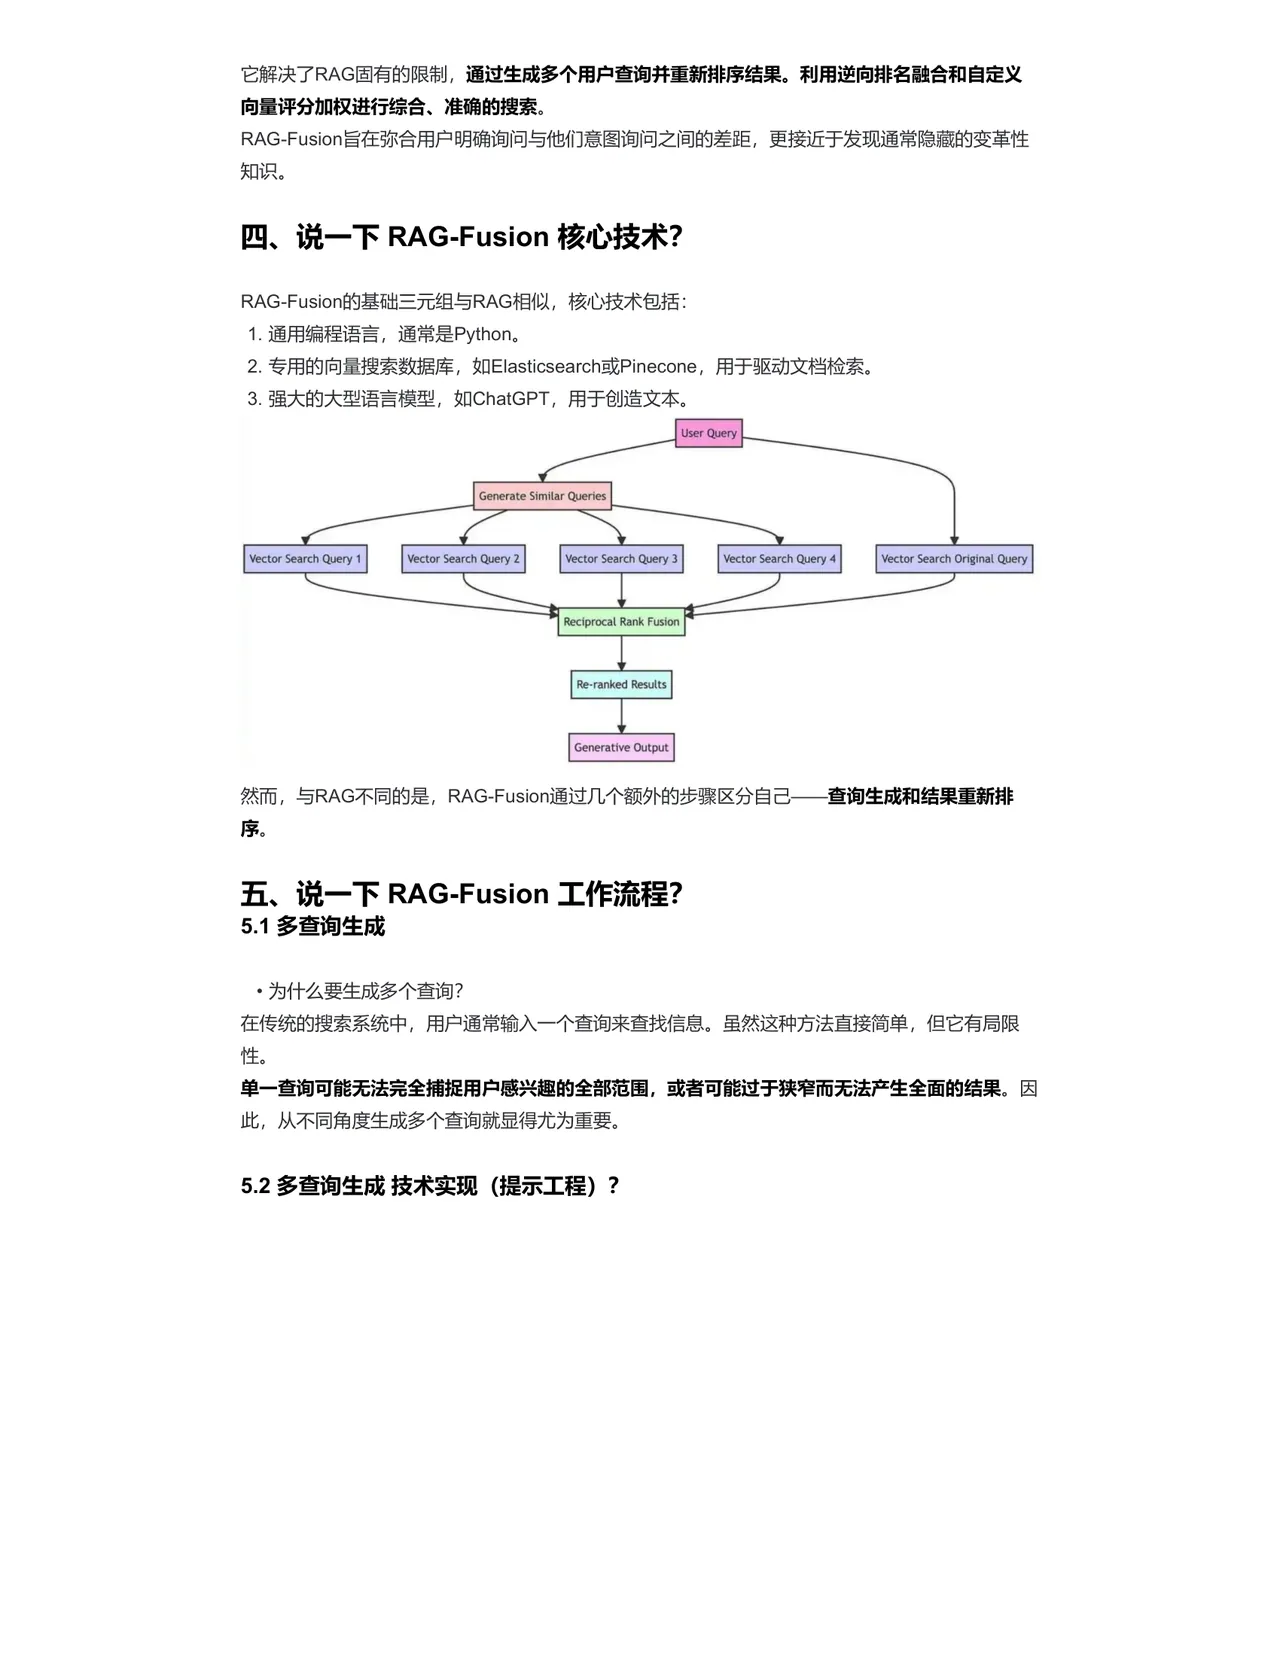
RAG-Fusion 的基础三元组与 RAG 相似,核心技术包括: 1.通用编程语言,通常是 Python。 2. 专用的向量搜索数据库,如 Elasticsearch 或 Pinecone,用于驱动文档检索。 3.强大的大型语言模型,如 ChatGPT,用于创造文本。

Vector Search Query

然而,与 RAG 不同的是,RAG-Fusion 通过几个额外的步骤区分自己—查询生成和结果重新排 序。

五、说一下 RAG-Fusion 工作流程?

5.1 多查询生成

•为什么要生成多个查询? 在传统的搜索系统中,用户通常输入一个查询来查找信息。虽然这种方法直接简单,但它有局限 性。 单一查询可能无法完全捕捉用户感兴趣的全部范围,或者可能过于狭窄而无法产生全面的结果。因 此,从不同角度生成多个查询就显得尤为重要。 5.2 多查询生成技术实现(提示工程)?

Generate Similar Queries

Vector Search Query

Vector Search Query

Vector Search Original Query

033 / 3
第 3 页
第 3 页

利用提示工程和自然语言模型拓宽搜索视…

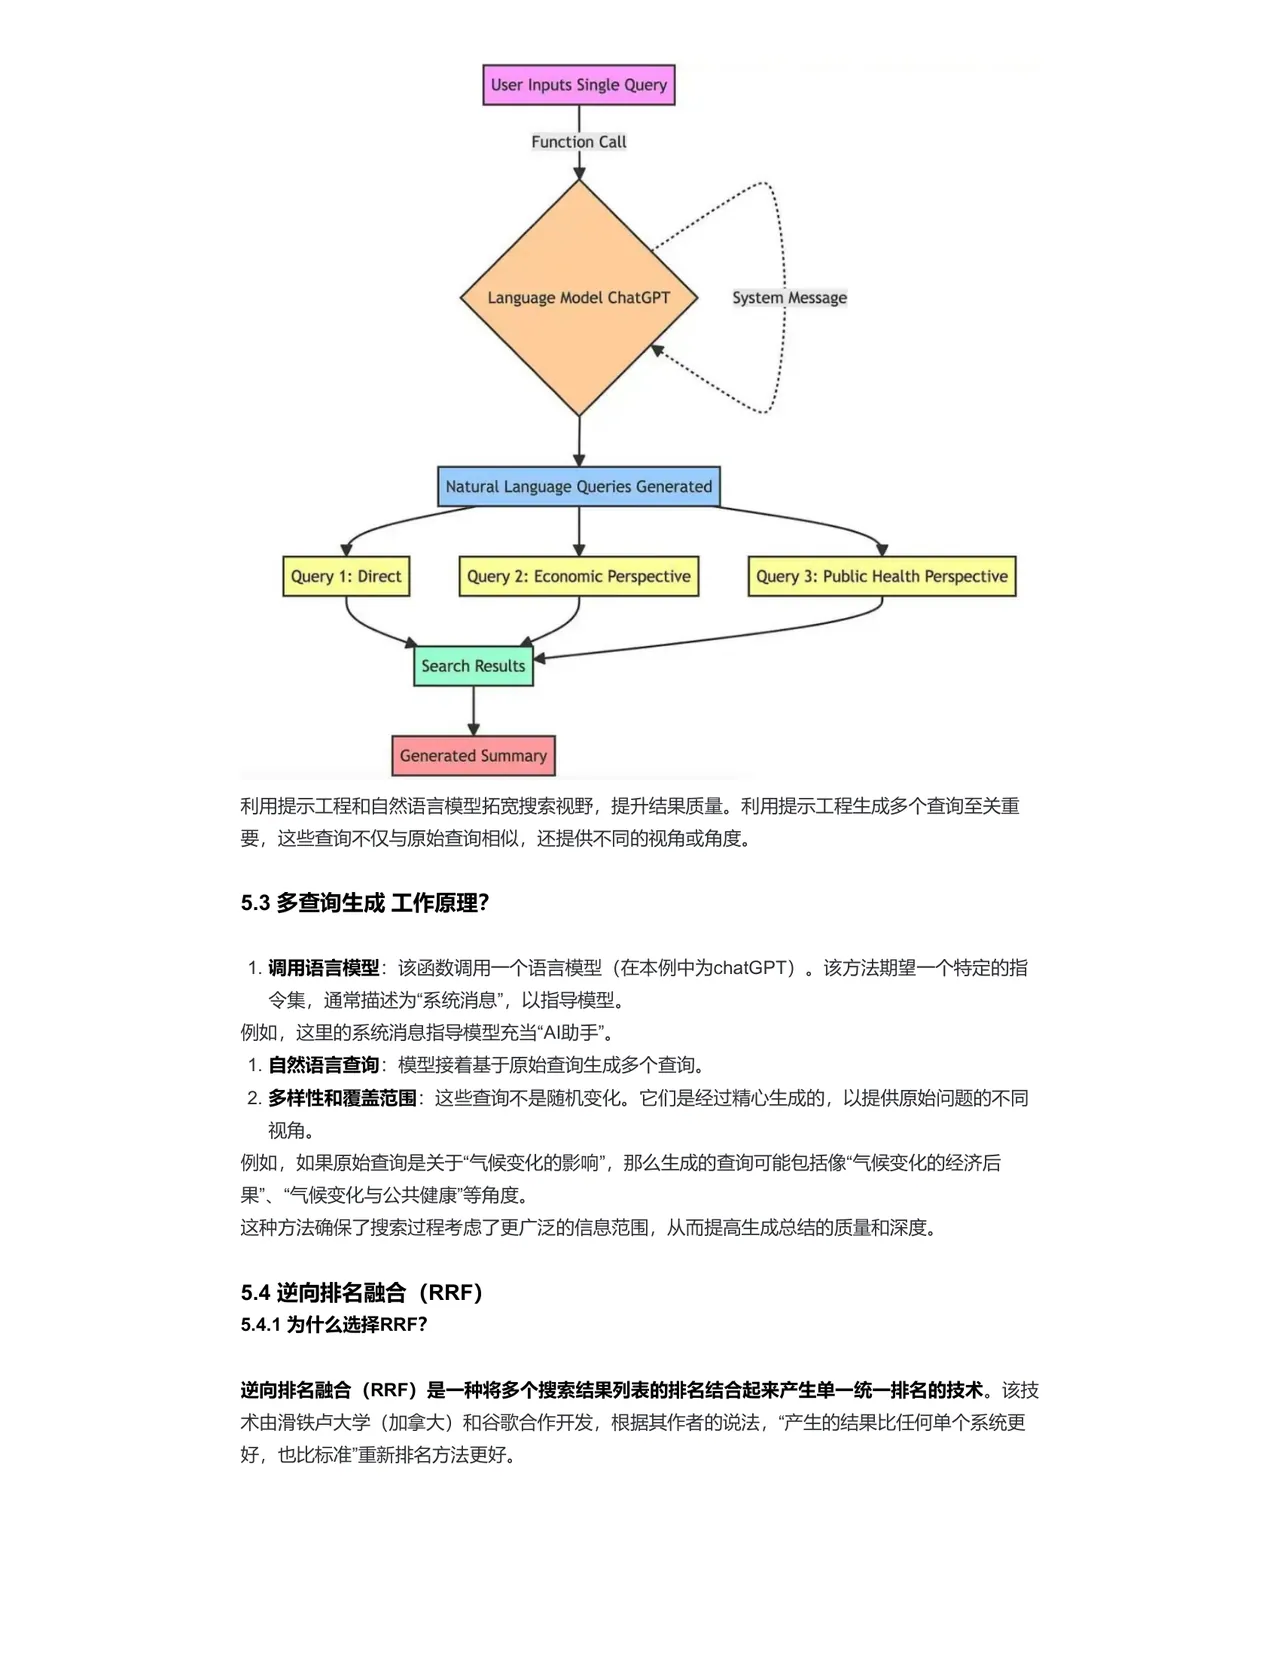
User Inputs Single Query

Function Call

Language Model ChatGPT

Natural Language Queries Generated

Query 1: Direct Query 2: Economic Perspective

Search Results

Generated Summary

利用提示工程和自然语言模型拓宽搜索视野,提升结果质量。利用提示工程生成多个查询至关重 要,这些查询不仅与原始查询相似,还提供不同的视角或角度。 5.3 多查询生成工作原理?

1.调用语言模型:该函数调用一个语言模型(在本例中为 chatGPT)。该方法期望一个特定的指 令集,通常描述为“系统消息”,以指导模型。 例如,这里的系统消息指导模型充当“AI 助手”。 1.自然语言查询:模型接着基于原始查询生成多个查询。 2. 多样性和覆盖范围:这些查询不是随机变化。它们是经过精心生成的,以提供原始问题的不同 视角。 例如,如果原始查询是关于“气候变化的影响”,那么生成的查询可能包括像“气候变化的经济后 果”、“气候变化与公共健康“等角度。 这种方法确保了搜索过程考虑了更广泛的信息范围,从而提高生成总结的质量和深度。

5.4 逆向排名融合(RRF) 5.4.1 为什么选择 RRF?

逆向排名融合(RRF)是一种将多个搜索结果列表的排名结合起来产生单一统一排名的技术。该技 术由滑铁卢大学(加拿大)和谷歌合作开发,根据其作者的说法,“产生的结果比任何单个系统更 好,也比标准“重新排名方法更好。

System Message

Query 3: Public Health Perspective

资料里没有你的场景?

把你手上的数据和想解决的那个环节发上来,我们按具体情况回,不复述方法论。

发布需求