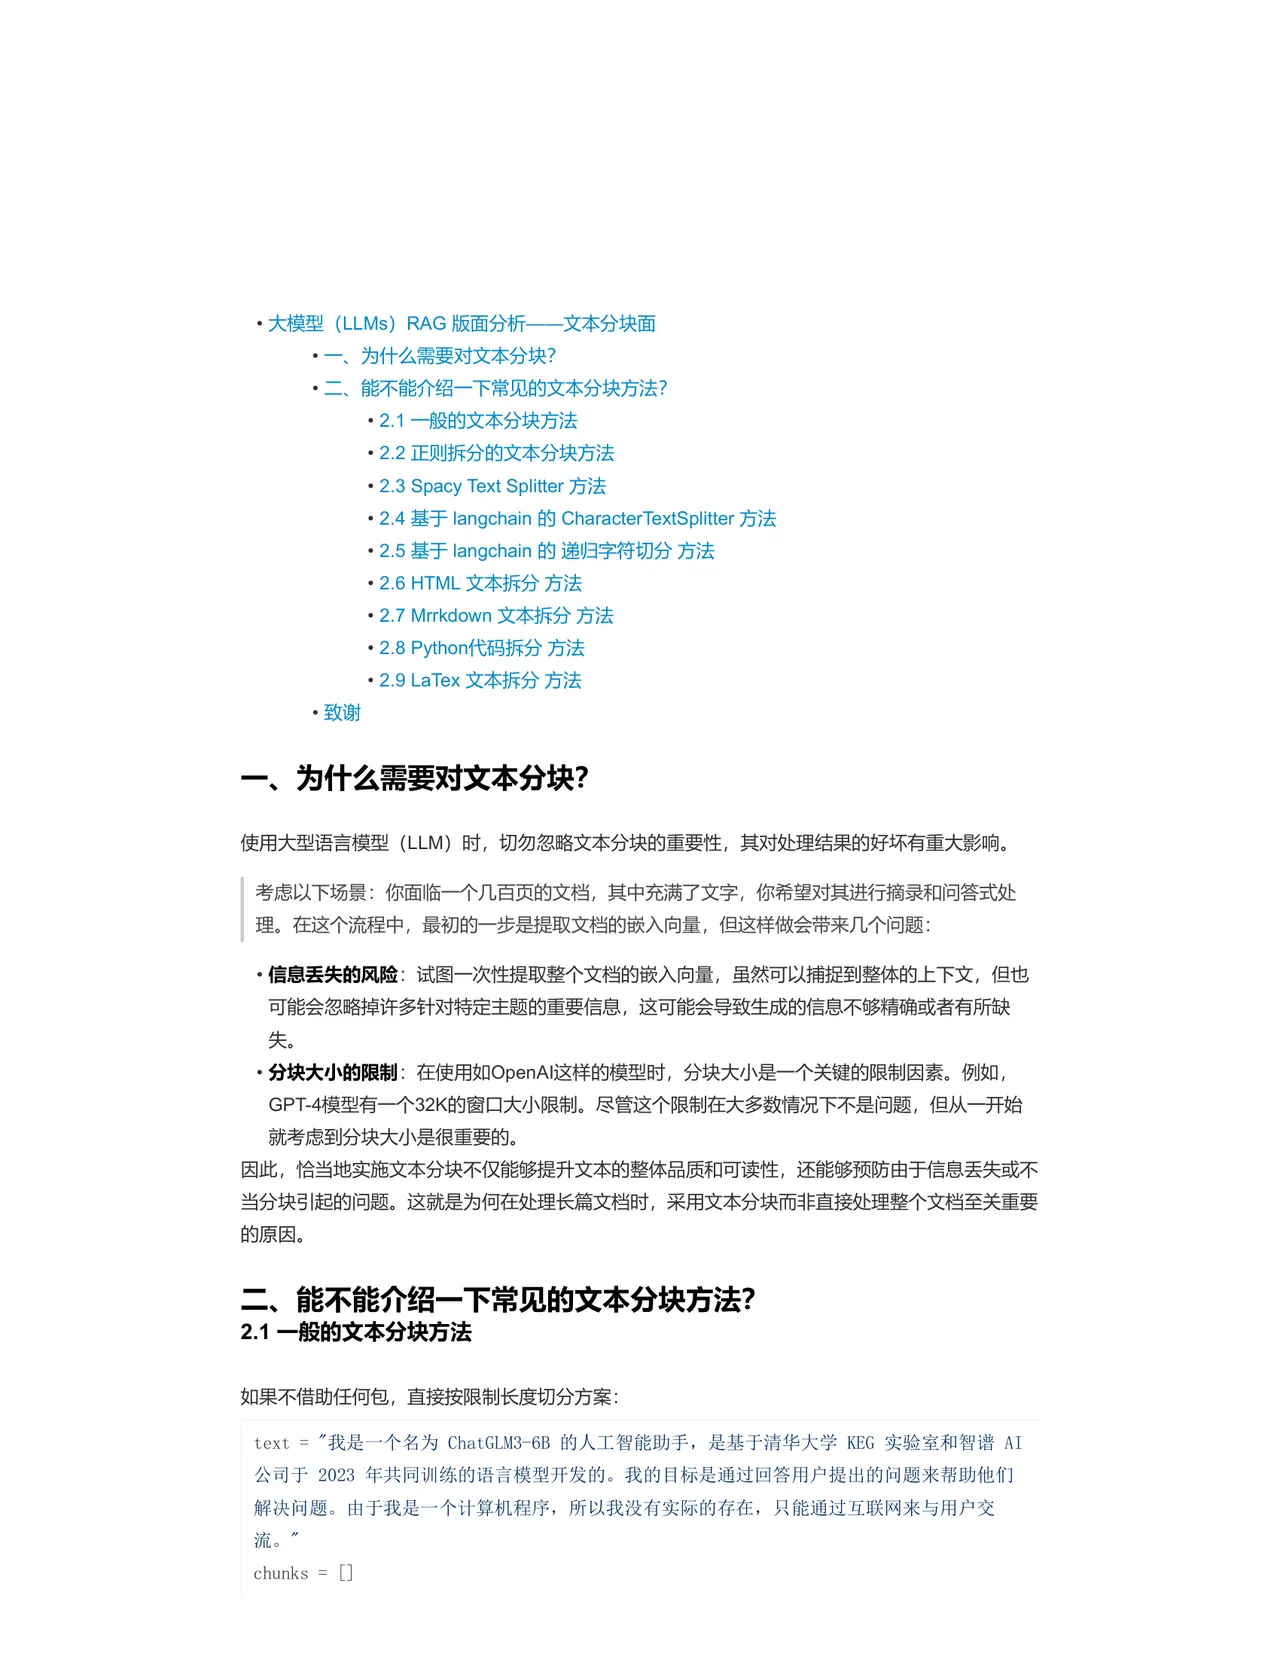
在上面例子中,我们并没有采用任何特定的方式来分割句子。另外,还有许多其他的文本分块技术 可以使用,例如词汇化(tokenizing)、词性标注(POS tagging)等。 2.3 Spacy Text Splitter 方法
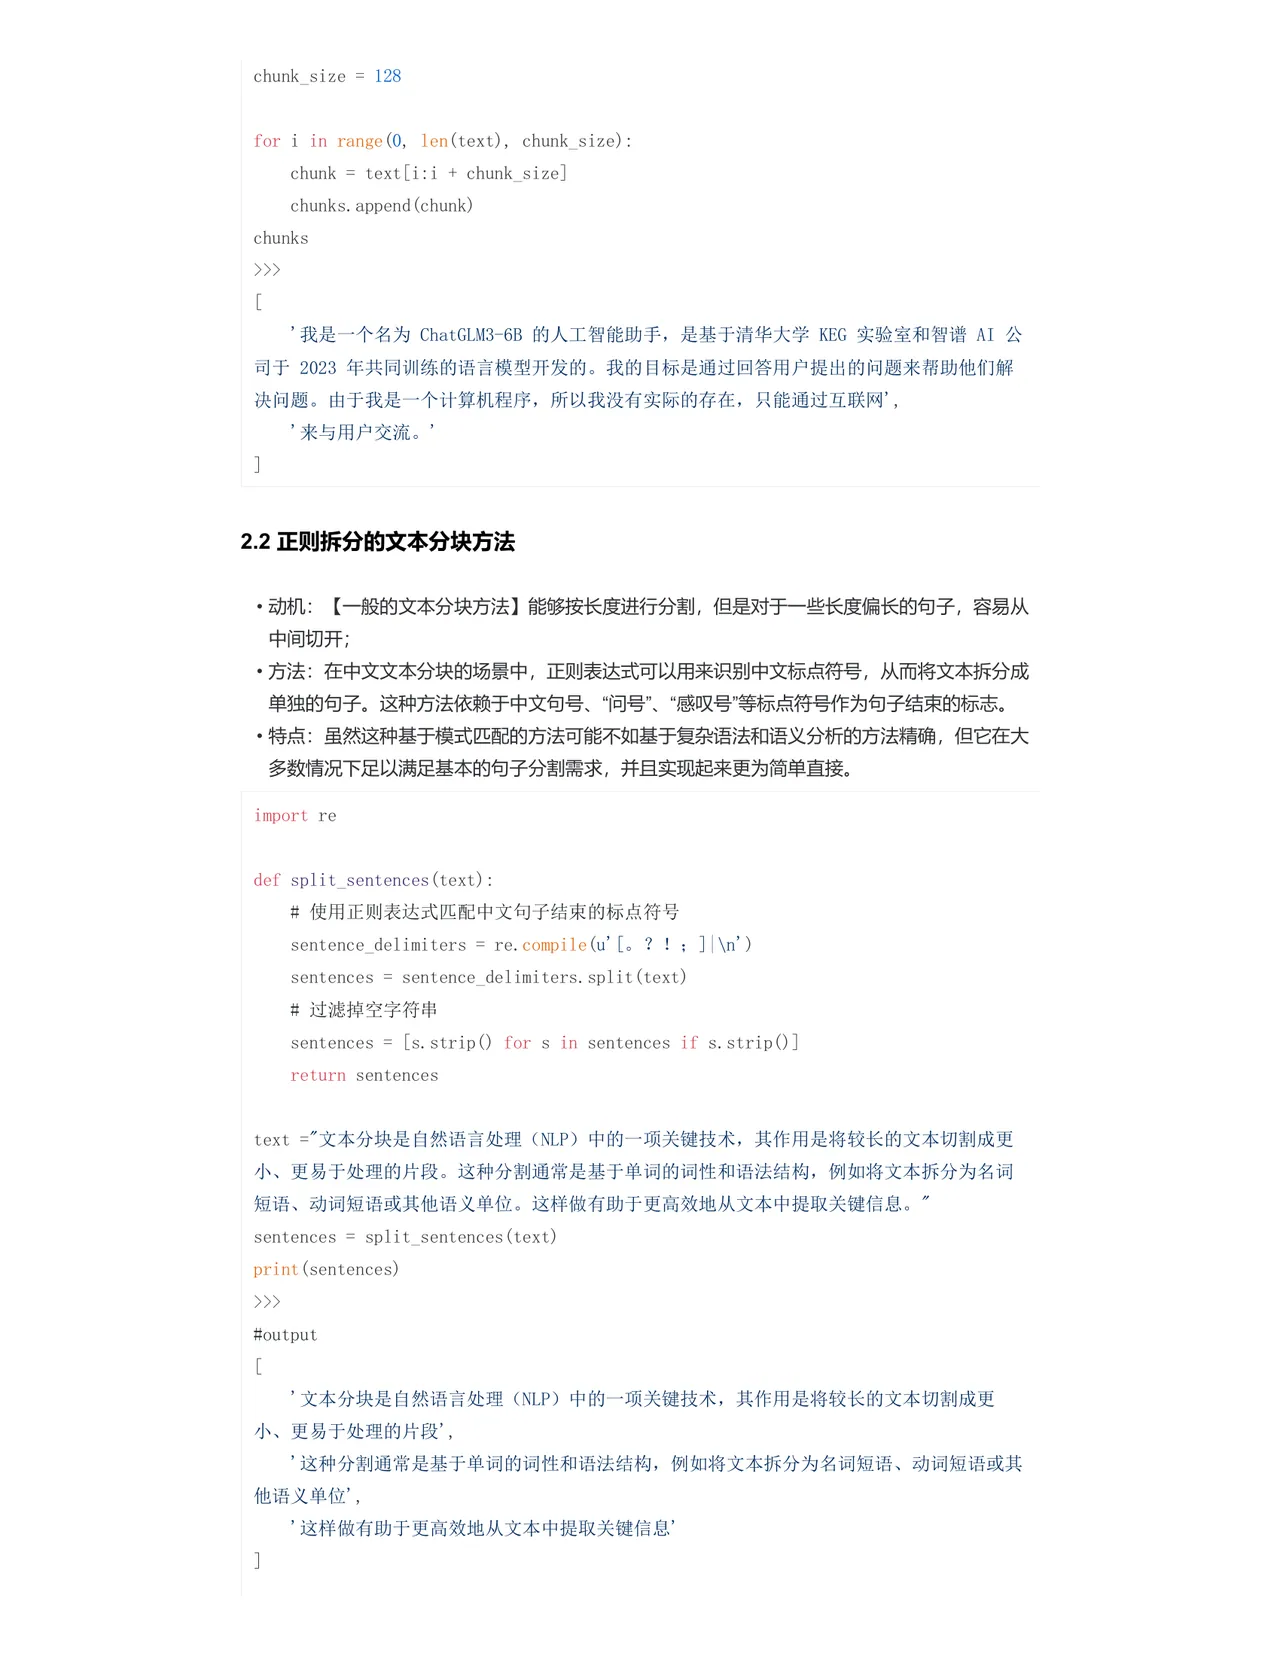
•介绍:Spacy 是一个用于执行自然语言处理(NLP)各种任务的库。它具有文本拆分器功能, 能够在进行文本分割的同时,保留分割结果的上下文信息。
import spacy
input_text = “文本分块是自然语言处理(NLP)中的一项关键技术,其作用是将较长的文本切 割成更小、更易于处理的片段。这种分割通常是基于单词的词性和语法结构,例如将文本拆分 为名词短语、动词短语或其他语义单位。这样做有助于更高效地从文本中提取关键信息。”
doc = nlp (input_text) for s in doc.sents: print (s)
’文本分块是自然语言处理(NLP)中的一项关键技术,其作用是将较长的文本切割成更 小、更易于处理的片段。’, ”这种分割通常是基于单词的词性和语法结构,例如将文本拆分为名词短语、动词短语或其 他语义单位。”, “这样做有助于更高效地从文本中提取关键信息。”
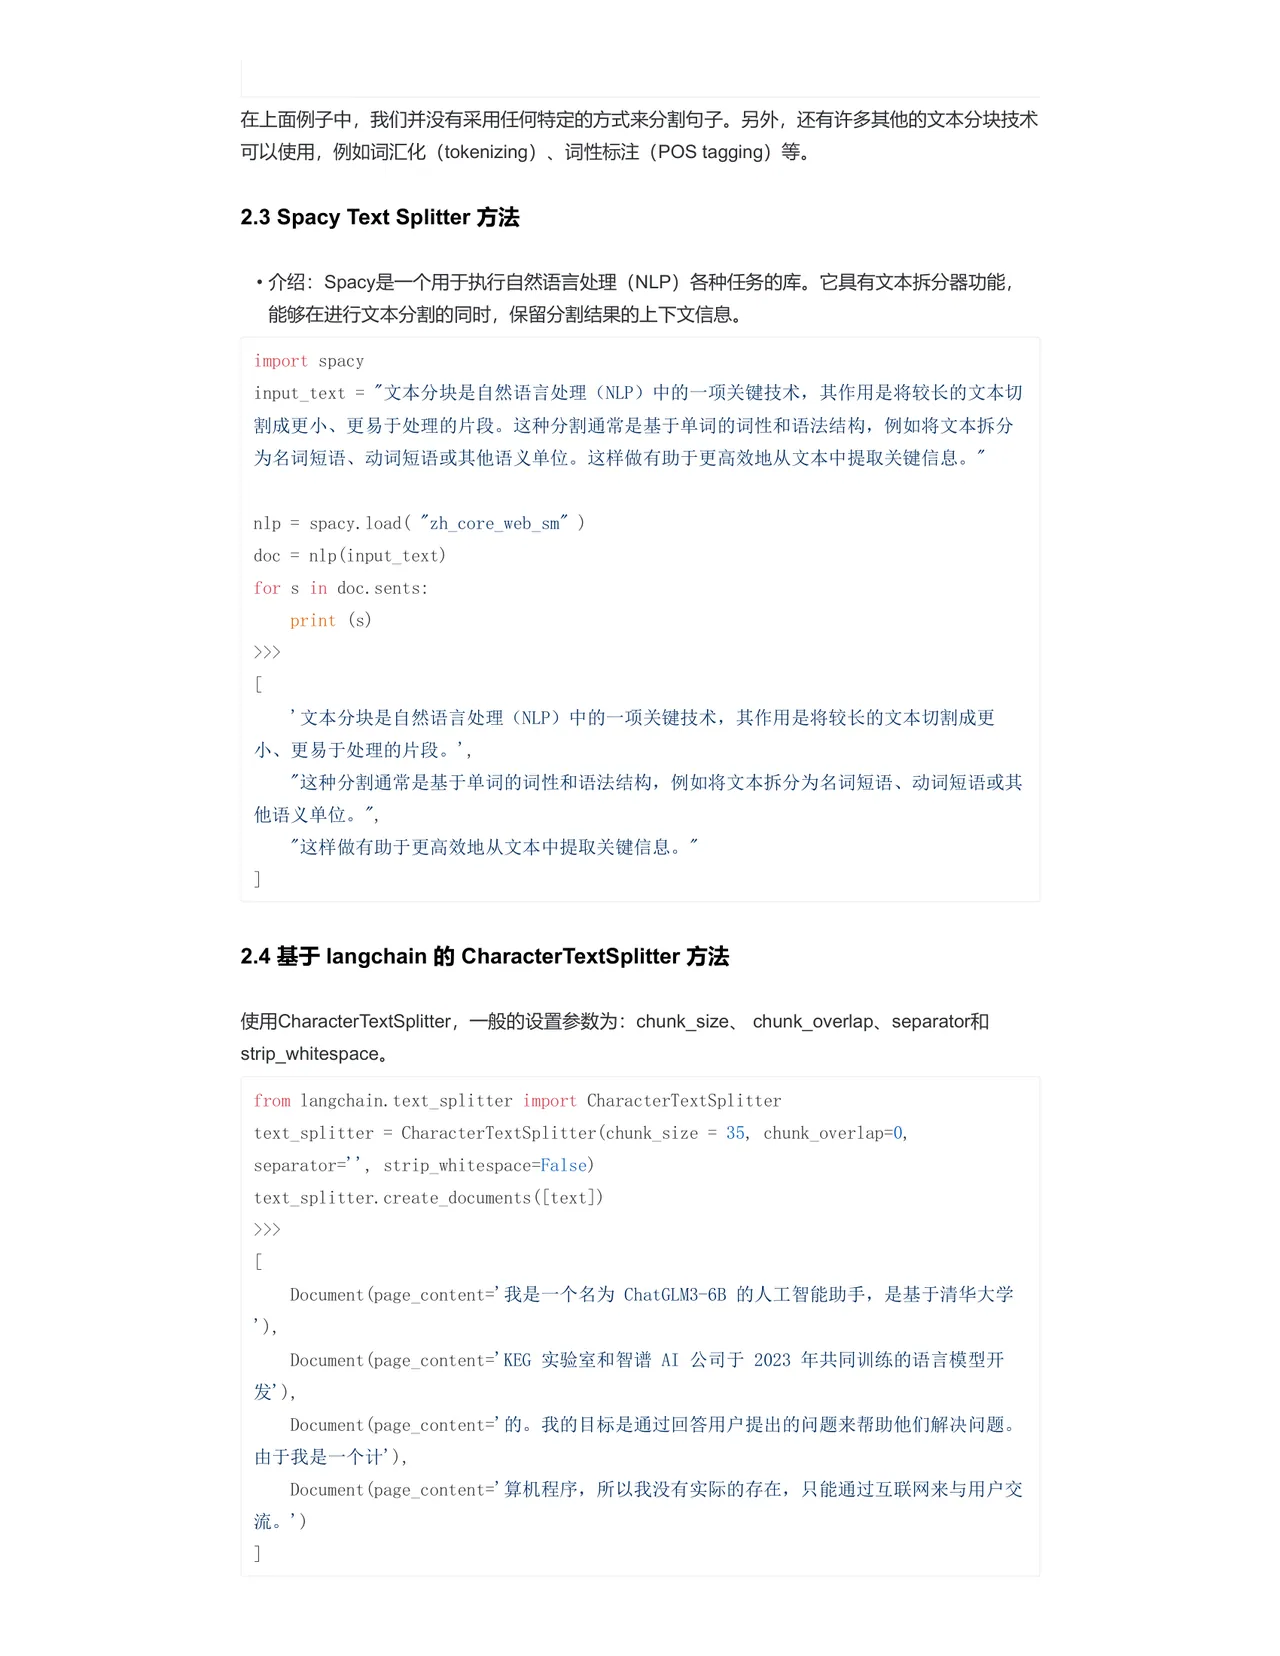
2.4 基于 langchain 的 CharacterTextS plitter 方法 使用 CharacterTextSplitter,一般的设置参数为:chunk_size、chunk_overlap、separator 和 strip_whitespace。 from langchain. text_splitter import CharacterTextSplitter text_splitter = CharacterTextSplitter (chunk_size = 35, chunk_overlap=0, separator='’,strip_whitespace=False) text_splitter.create_documents ([ text ])
Document (page_content=’我是一个名为 ChatGLM3-6B 的人工智能助手,是基于清华大学
Document (page_content='KBG 实验室和智谱 AI 公司于 2023 年共同训练的语言模型开
Document (page_content=’的。我的目标是通过回答用户提出的问题来帮助他们解决问题。 由于我是一个计’), Document (page_content=’算机程序,所以我没有实际的存在,只能通过互联网来与用户交