
互联网大厂高并发限流解决方案
《互联网大厂高并发限流解决方案》共 0.5 万字,通篇围绕 并发、吞吐、场景、部署 展开,归在「推理、部署与算力」这一层。
适合要把模型跑起来,还得跑得起的人
目录骨架(8 节)
- 1. 高并发下如何保证高可用
- 2. 限流的核心思想
- 3. 常见的限流策略
- 1.1 什么是高并发?
- 1.2 高并发的处理指标
- 1.3 什么是高可用?
- 1.4 高并发下如何确保高可用
- 2.1 什么是限流?
示例代码
注:将ppt后缀名改为zip后解压
jdk版本:1.8.0_181
本次分享内容
- 高并发下如何保证高可用
- 限流的核心思想
- 限流的场景
- 常见的限流策略
1. 高并发下如何保证高可用
1.1 什么是高并发?
高并发(High Concurrency)是一种系统运行过程中遇到的一种“短时间内遇到大量操作请求”的情况,主要发生在web系统集中大量访问收到大量请
求(例如:秒杀、12306的抢票、天猫双十一、微博热点)。该情况的发生会导致系统在这段时间内执行大量操作,例如对资源的请求,数据库的操作等。
总的来说,高并发需要一定的用户基数、一定的业务量,才会碰到
1.2 高并发的处理指标
高并发相关常用的一些指标有:
1.响应时间(Response Time)
响应时间:系统对请求做出响应的时间。例如系统处理一个HTTP请求需要200ms,这个200ms就是系统的响应时间
2.吞吐量(Throughput)
吞吐量:单位时间内处理的请求数量。
3.每秒查询率QPS(Query Per Second)
QPS:每秒响应请求数。在互联网领域,这个指标和吞吐量区分的没有这么明显。
4.并发用户数
并发用户数:同时承载正常使用系统功能的用户数量。例如一个即时通讯系统,同时在线量一定程度上代表了系统的并发用户数。
1.3 什么是高可用?
高可用HA(High Availability)是分布式系统架构设计中必须考虑的因素之一,它通常是指,通过设计减少系统不能提供服务的时间。
假设系统一直能够提供服务,我们说系统的可用性是100%。
如果系统每运行100个时间单位,会有1个时间单位无法提供服务,我们说系统的可用性是99%。
我们平常经常看到互联网公司喊口号,我们今年一定要做到3个9、4个9,即99.9%、99.99%,甚至还有5个9,即99.999%。
年 = 365天 = 8760小时
99.9 = 8760 0.1% = 8760 0.001 = 8.76小时 (3个9)
99.99 = 8760 0.0001 = 0.876小时 = 0.876 60 = 52.6分钟 (4个9)
99.999 = 8760 0.00001 = 0.0876小时 = 0.0876 60 = 5.26分钟 (5个9)
| 系统可用性% | 宕机时间/年 | 宕机时间/月 | 宕机时间/周 | 宕机时间/天 |
|---|---|---|---|---|
| 90% (1个9) | 36.5 天 | 72 小时 | 16.8 小时 | 2.4 小时 |
| 99% (2个9) | 3.65 天 | 7.20 小时 | 1.68 小时 | 14.4 分 |
| 99.9% (3个9) | 8.76 小时 | 43.8 分 | 10.1 分钟 | 1.44 分 |
| 99.99% (4个9) | 52.56 分 | 4.38 分 | 1.01 分钟 | 8.66 秒 |
| 99.999% (5个9) | 5.26 分 | 25.9 秒 | 6.05 秒 | 0.87 秒 |
全年停机52.6分钟才能做到99.999%,即4个9
全年停机5.26分钟才能做到99.999%,即5个9
这么多9代表什么意思呢?
实际上这就是一个SLA的概念,是对服务可用性的一个保证。9越多,代表全年服务可用时间越长,服务越稳定,停机时间越短,反之亦然。
SLA 是什么?
SLA:服务等级协议(简称:SLA,全称:service level agreement)。是在一定开销下为保障服务的性能和可用性,服务提供商与用户间定义的一种双方认可的协定。通常这个开销是驱动提供服务质量的主要因素。
百度的搜索首页,是业内公认高可用保障非常出色的系统,甚至人们会通过www.baidu.com 能不能访问来判断“网络的连通性”,百度高可用的服务让人留下啦“网络通畅,百度就能访问”,“百度打不开,应该是网络连不上”的印象,这其实是对百度HA最高的褒奖。
1.4 高并发下如何确保高可用
高并发下的高可用与普通高可用存在很大差异
普通高可用只是多节点部署,防止服务进程死亡、机器故障、网络故障。
高并发意味着流量大、并发高,系统很容易因为流量大而被冲垮,宕机
解决的思路、方法各不相同。
高可用必备手段
集群化、多节点部署:冗余、最基础高可用设计
失败重试:要区分调用失败的类型。有些失败是短暂偶然的(比如网络抖动),进行重试即可。而有些失败是确定,那么重试反而会造成调用请求量的放大,加重对调用系统的负担。经验值:重试的次数一般设为3次,再多次的重试没有好处。
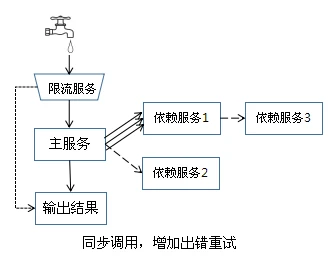
快速回滚:出现问题后,能有有效的回滚机制。涉及到数据修改的,发布后会引起脏数据的写入,需要有可靠的回滚流程,保证脏数据的清除。
除了发布流程外,还应该在其他开发流程上做规范,比如代码控制,集成编译、自动化测试、静态代码扫描等。